
「只在某些夜裡出現的破綻,白天怎麼問都問不出來——但它被寫下來了。」
——《阿帕契開源審計錄》¹ 卷三·偶發篇
幕間
七號在微弱油燈下將指控理成四段:背景、破綻、論證與驗證。
她從頭讀完每一格紀錄,確保每句質疑都能精確對應到某一夜的具體行為。
「明天,我只要把這張紙攤開在陽光下。」
七號盯上一個模式,盯了三個晚上。二號在某些夜裡會變得特別明顯:接著別人的話尾、附議刀口、自己從不先開口。但不是每一晚。她比對了三世的紀錄,發現那個模式只在兩個條件同時成立時出現——發言順序剛好把他排在五號後面,而且法官宣布了限時。
今晚她決定逼它現形。輪到分配發言方向時,她低聲跟警長說了幾句,警長便指定由二號第一個開口,不排在任何人後面,也不宣布限時。
結果什麼都沒有。二號站起來,環視一圈,說:「我沒什麼要補充的,聽大家的。」平淡得像一杯溫水。他甚至沒有可以覆誦的句子,因為前面沒有人講過話。
七號在羊皮紙邊緣寫了一行小字:「只在『接在五號之後』且『限時』時出現;主動去戳,它就縮回去。」她差一步,就差那麼一步。
而我在對面,手心冒汗——因為她描述的東西,我太熟了。那不是玄學。那是一個 flaky test。
flaky test(不穩定測試)指的是:同一份程式碼、同一個測試,什麼都不改,重跑就可能一次綠一次紅。它最惡毒的地方,是「你越想盯它,它越不出現」——因為你加了 log、放慢了速度、把它單獨拉出來跑,這些動作本身就改變了觸發條件。它跟七號今晚遇到的狀況一模一樣:把二號單獨叫起來第一個講,那個破綻就不見了。
flaky test 的代價不是「偶爾紅一下」這麼輕。CI 一紅,大家的反射動作是「再跑一次」;跑幾次過了就當沒事。久了,整個團隊不再相信測試,真正的迴歸也被淹沒在雜訊裡,release 就卡在這裡出不去。一個大型專案在發版前,往往要有人專門去盯這些時綠時紅的測試,逐一判斷「這次紅是真的壞了,還是它老毛病」——這份工作沒有成就感、沒人搶著做,卻是 release 能不能準時的關鍵,這就是所謂的 release blocker。
七號手上那頁紀錄的處境完全一樣:她知道二號身上有個東西不對,但那個東西只在特定條件下浮現,她沒辦法在白天當著全場的面把它重現出來。一個無法在需要時重現的破綻,跟一個無法在需要時重現的測試失敗,是同一種東西。
這裡有個放大效應:一個 flaky test 壞掉的不只是它自己。它訓練整個團隊養成「紅燈先重跑」的反射動作,於是下一個真的抓到迴歸的紅燈,也會被當成雜訊按掉。信任是二元的——一套測試要嘛可信、要嘛不可信,沒有「九成可信」這種東西。所以成熟專案對 flaky test 的容忍度極低,寧可暫時停用它、開一張票追,也不讓它繼續汙染訊號。這也是為什麼修好一個 flaky test,比修一百個 typo 更被看見:你修的不是一行程式碼,是整條 CI 的可信度。
「源來適你」社群的 chia7712 審過 2500 份以上的 PR,他反覆講一個判斷標準:拿 AI 掃一輪、送一百個修 typo 或無關 refactor 的 PR,數字刷得很漂亮,卻不會讓社群多看你一眼;專案真正在意的是 release blocker 和 flaky test 這種沒人想碰的硬骨頭。一個在 codebase 裡遊蕩了好幾年、時而通過時而失敗的測試,背後可能是測試自己寫爛了,也可能藏著 production 程式碼裡一個很神秘的 bug。你抓到一隻,等於幫所有維護者把 CI 的信任找回來——這比一百個表面功夫的 PR 都有份量(他的鐵人賽系列)。
換句話說:修 typo 像白天喊一句「他很可疑」——聲音大、風險低、也沒人記得。抓 flaky test 像七號手上那頁紀錄——安靜、費力、可被審查。
chia7712 還提過另一個角度:在一段「已經跑了很久」的舊路徑上,聽 AI 掃描器的話把 O(n) 優化成 O(1),如果你不懂整個依賴生態,很可能是在替一段下個版本就要淘汰的程式碼化妝。同樣的 AI 額度,拿去重現並獵捕那些讓 CI 變紅又消失的偶發失敗,價值高得多。這跟七號的選擇完全對得上:她沒有把力氣花在「聽起來很有力」的指控上,而是花在那個抓不住、卻真的存在的模式上。
抓 flaky test 的第一守則跟抓狼一樣:先穩定重現,再談修。把測試跑一千次、開最大平行度、在負載很高的機器上跑、把測試順序打亂——先讓它紅得可預測。然後往三個方向分類:
-race、-parallel、或機器一忙就更容易紅」。修法是加鎖、改用 channel、或乾脆不共享。sleep 當等待、直接讀 time.Now()、時區假設、逾時抓太緊。修法是把「睡 50 毫秒然後檢查」改成「輪詢直到條件成立或 deadline 到」,並把時鐘做成可注入。t.Cleanup / defer 收尾、掛 goroutine leak detector。每一種都有一個你一看就認得的樣子。併發競爭:兩個 goroutine 同時對一個 map 寫入,測試在你的筆電上跑一萬次都過,一上 CI 的共享機器就偶爾 panic。時鐘或順序相依:測試 A 設了一個全域的假時間、結束忘了還原,單獨跑 A 沒事,A 之後接著跑 B 就爆,把順序對調又好了。資源未釋放:測試起了一個聽在固定 port 的伺服器、結束沒關,下一個要用同一個 port 的測試就 bind 失敗——但只有這兩個剛好排在一起時才撞得到。
分類完,如果一時修不好,就 quarantine——標記跳過並開一張 issue 追蹤——絕對不要 @Disabled 之後忘掉它。
四語言都有把「重現」自動化的工具:Go 用 go test -run TestX -count=1000 -race,一行就能壓力測一個測試;Java 用 JUnit 的 @RepeatedTest,或在 Maven Surefire 設 rerunFailingTestsCount 統計重跑通過率;Python 用 pytest-randomly 打亂順序、pytest-repeat 重複跑,把順序相依和資源污染逼出來;Rust 用 cargo nextest 的 retry 與分片,快速定位不穩定的案例。共通策略是:把「偶爾紅」變成「可預測地紅」,你才有東西可以除錯。一個你無法重現的 bug,等於一個你無法修的 bug——你頂多是把它藏起來。
package worker

import (
	"sync"
	"testing"
	"time"
)

// Minimal Worker so both tests compile: Submit hands work to Run, which counts it.
type Worker struct {
	mu        sync.Mutex
	processed int
	jobs      chan int
	quit      chan struct{}
}

func NewWorker() *Worker {
	return &Worker{jobs: make(chan int, 16), quit: make(chan struct{})}
}

func (w *Worker) Submit(n int) { w.jobs <- n }

func (w *Worker) Run() {
	for {
		select {
		case n := <-w.jobs:
			time.Sleep(10 * time.Millisecond) // simulated work
			w.mu.Lock()
			w.processed += n
			w.mu.Unlock()
		case <-w.quit:
			return
		}
	}
}

func (w *Worker) Stop() { close(w.quit) }

func (w *Worker) Processed() int {
	w.mu.Lock()
	defer w.mu.Unlock()
	return w.processed
}
// FLAKY: relies on a fixed sleep to "wait" for the worker, and reads processed
// without synchronisation. Green on a fast laptop, red under CI load.
func TestWorker_Flaky(t *testing.T) {
	w := NewWorker()
	go w.Run()
	w.Submit(10)

	time.Sleep(50 * time.Millisecond) // hope 50ms is enough
	if w.processed != 10 {            // data race on processed
		t.Fatalf("processed = %d, want 10", w.processed)
	}
}

// FIXED: poll until the condition holds or a deadline fires; guard shared state;
// make sure the background goroutine is gone before the next test starts.
func TestWorker_Deterministic(t *testing.T) {
	w := NewWorker()
	done := make(chan struct{})
	go func() { w.Run(); close(done) }()
	t.Cleanup(func() {
		w.Stop()
		<-done
	})

	w.Submit(10)
	waitFor(t, 2*time.Second, func() bool { return w.Processed() == 10 })
}

func waitFor(t *testing.T, timeout time.Duration, cond func() bool) {
	t.Helper()
	deadline := time.Now().Add(timeout)
	for time.Now().Before(deadline) {
		if cond() {
			return
		}
		time.Sleep(5 * time.Millisecond)
	}
	t.Fatalf("condition not met within %s", timeout)
}
兩個版本的差別集中在兩個地方。等待:time.Sleep(50ms) 是賭博——賭機器夠快;waitFor 是輪詢到條件成立或 deadline 到,機器慢就多等幾輪,不會假性失敗。收尾:t.Cleanup 保證背景 goroutine 在下一個測試開始前一定結束,把「資源未釋放」這條路堵死。再加上 Processed() 用 mutex 保護共享欄位,go test -race 就不會再叫。
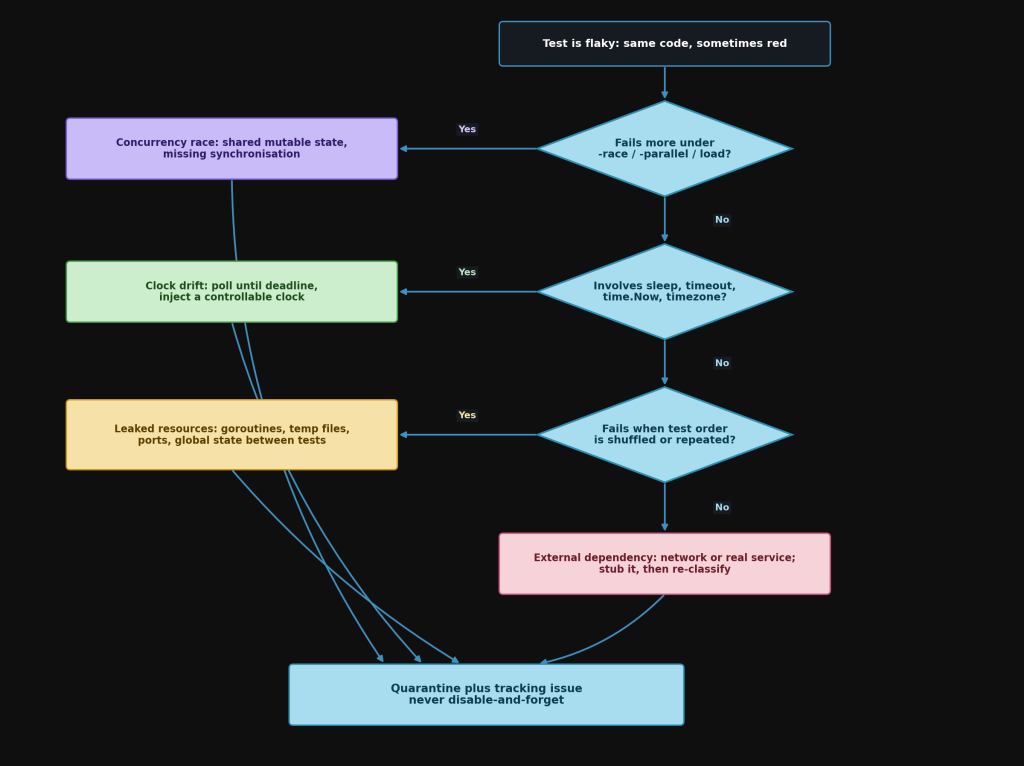
「先穩定重現,再談修」講起來簡單,做起來最煩人的部分往往是「盯著它跑一千次」這件苦力活——人得守著終端機,一輪一輪按、一輪一輪看結果,跟七號守著二號那三個晚上一樣耗神。這種「重複執行、記錄結果、直到證據夠了」的工作,剛好是可以交給背景任務的那種:Claude Code 的 /loop 技能可以把一條指令設成固定週期反覆執行,例如每隔幾分鐘就跑一次 go test -run TestWorker -count=100 -race,讓失敗率的證據在你去做別的事情時持續累積,而不必自己守著終端機一輪一輪按。等回頭一看,你要的不是「它又紅了一次」,而是「一百次裡紅了幾次、在什麼條件下紅」——這正是判斷一個 flaky test 該歸類到 race、clock 還是 resource 之前,最耗時間但最不需要人腦介入的那一步。
七號那三個晚上的苦功,某種意義上就是人工版的 /loop:固定條件、重複觀察、記錄下觸發與不觸發的那條界線。差別只在於,她沒有能替她值夜的工具。
七號沒有丟掉她那個抓不住的假設。她把它寫在羊皮紙邊緣,繼續追——這正是對付一個「無法隨傳隨到」的 bug 的正確動作:先隔離、掛著追蹤,別假裝它不存在。她差一步就碰到真相:一個真獵人不可能三十天都在附議,二號那個「從不第一個提目標」的破綻是真的,只是它有觸發條件,你正面去問,它就縮回去。我們 2N1P 都看得出來她離答案很近了。
那三個晚上,城堡上空的月亮紅得比上一次更深,陰影像從一個缺口慢慢咬進去。每隔幾世就來這麼一次,我漸漸摸到了它的節奏——只是還不知道它要通向什麼。
讀完今天,你應該能做到:測試一 flaky,先想辦法穩定重現(迴圈跑、加負載、打亂順序),再把它歸類到 race、clock、resource 其中一種才動手修;修不完就 quarantine 加追蹤 issue,不要靜靜地把它關掉。可以讀 Go 官方文件 - testing 套件 與 Go 官方部落格 - Introducing the Go Race Detector,再對照 cargo-nextest 官方文件 - Retries 看 Rust 生態怎麼自動化重跑判斷。
testing 套件
pytest-randomly 套件文件
flaky test root cause race condition clock drift resource leak go test -race count parallel quarantine tracking issue release blocker
¹ 註:本書名為情境設定之虛構文獻,非真實歷史或開源紀錄。


 iThome鐵人賽
 看影片追技術