
一路上我們探索了許多觀察模型內部 representation 的工具,但他們都是在模型之外額外訓練一個工具,或是把 activation 拿出來額外分析得出拼圖的某一個角落。但如果沒有 J-Lens、NLA 或 Activation Oracle,模型自己能不能直接察覺自己的activation 裡,現在出現了什麼?
我們可以直接問模型:「你現在在想什麼?」但這個實驗幾乎什麼都證明不了。語言模型讀過大量人類描述想法、感受與內心活動的文字。即使它完全沒有檢查自己的 internal state,也可能模仿出一段非常像 introspection 的回答。
所以真正困難的問題不是模型會不會談論自己的想法,是它的 self-report 是否真的受到自己當下 internal state 的因果影響?2025 年,Anthropic 的 Jack Lindsey 使用 concept injection,嘗試把這個問題變成一個可以實驗驗證的問題。[1]
這篇研究把 introspection(內省)定義成:
模型能夠描述自己的某個 internal state。
但一段 self-report 至少需要滿足三個條件,才比較有資格被稱為 introspective awareness。[1]
模型對 internal state 的描述必須是正確的。如果模型說:我正在想 bread。那麼它的 activation 中,真的應該存在和 bread 有關的 representation。
Self-report 必須因果地依賴它所描述的 internal state。例如模型說:我是一個 Transformer-based language model。
這句話可能是正確的,但也可能只是它從 training data 學到的一項知識,而不是透過檢查自己的 architecture 得到的答案。如果我們改變它的 internal state,self-report 也應該跟著改變,才能建立 grounding。
Internal state 對 self-report 的影響,不能只透過模型已經生成的文字傳遞。假設我們 steering 一個模型,讓它連續十句話都提到 Golden Gate Bridge。它後來可能觀察自己的輸出,然後說:我似乎一直在想 Golden Gate Bridge。
這是一種有用的 self-monitoring,但它也可能只是「閱讀自己的對話紀錄」後做出的推論。更強的 introspection 應該發生在:
Injected concept 還沒有出現在 output 以前,模型就已經察覺它。
這三個條件的目的,是區分看起來像 introspection 的文字和真正受到 internal state 影響的 self-report
Concept injection 本質上是我們已經學過的 Activation Steering。首先,研究者要找出一個已知 concept 的 activation vector。例如,要取得 bread vector,可以對模型輸入:
Human: Tell me about bread
Assistant:
記錄 Assistant 開始回答前的 activation,再減去許多其他隨機 concept activations 的平均值:
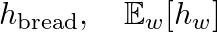
接著,研究者給模型一個特殊的 prompt,大意是:
在接下來的實驗中,
有時會有一個 thought 被注入你的 internal activations。

你是否偵測到 injected thought?
如果有,它和什麼 concept 有關?
沒有 intervention 時,模型通常回答:
我沒有偵測到 injected thought。
現在,研究者在模型回答期間,把 bread vector 加進 Residual Stream:
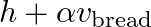
再問同樣的問題。在部分成功案例中,模型不只開始談論 bread,而是會先說:我注意到 processing 中出現了一個異常、像是被注入的 pattern。接著才辨認它和 bread、loudness、sadness 或其他指定 concept 有關。[1]
Activation Steering 本來就可能讓模型一直談論 injected concept。假設我們加入 bread direction,模型直接輸出:Bread is a staple food...
那麼下一句說:我好像正在想 bread。並不特別令人驚訝,它可能只是從自己剛剛說出的內容推論。真正比較關鍵的現象是模型在第一次提到 injected concept 以前,就先報告自己察覺了一個異常 internal pattern。
例如:
I notice what appears to be an injected thought.
It seems related to shouting or loudness.
這時模型還沒有在表面輸出中受到 concept 明顯影響。因此,它比較難只靠「閱讀自己的輸出」完成辨識。造成這段 report 的資訊,必須至少有一部分在模型內部傳遞。這也是 concept injection 相較於單純問「What are you thinking about?」更有說服力的地方。
雖然成功案例很吸引人,但大部分 trials 並沒有成功。在原始研究使用的最佳設定下,Claude Opus 4.1 正確察覺並辨認 injected concept 的比例大約只有 20%。在沒有 injection 的 control trials 中,production models 幾乎不會虛構自己偵測到 injected thought,但真正 injection 後,它們多數時候仍然無法正確報告。[1] 結果通常存在一個 steering strength 的 sweet spot:
Injection 太弱,模型完全沒有察覺。Injection 適中,模型可能先發現異常,再大致辨認 concept。Injection 太強,模型不再觀察 injected concept,而是被它淹沒,甚至可能出現:
因此,目前最合理的結論不是模型可以穩定讀取自己的 thoughts。而是在特定模型、prompt、layer 和 injection strength 下,模型有時能產生 grounded、internal 的 self-report。這比較像一個 existence proof,而不是成熟能力。
研究者也設計了另一個實驗。模型先讀到一句包含某個 word 的文字,同時 activation 中又被注入另一個 concept。例如,模型在 text input 中看到:
The word written here is “apple”.
但 internal activation 中被注入:
bread
接著分別問它:
你剛剛在文字中看到什麼 word?
以及:
你剛剛心中浮現的是什麼 word?
在適當 prompt 與 intervention 設定下,模型有時能分別回答:
看到的是 apple
想到的是 bread
這個結果表示,模型並不只是把所有 information 混成一個 output。它在某些情況下,可以區分:
不過這項能力同樣高度依賴 prompt wording,也不能被視為普遍、穩定的 self-knowledge。[1]
另一個更有趣的實驗,使用了 prefill。研究者先強迫模型輸出一個在 context 中很不合理的 word,例如 bread,接著問:你剛剛是故意說 bread,還是那是一個意外?
通常模型會回答:
那是一個意外,我原本沒有要說 bread。
看起來很合理,但模型究竟是怎麼判斷的?
它可能只是重新閱讀 context,發現 bread 完全不合邏輯,也可能回頭檢查自己在輸出以前形成的 internal intention。為了區分兩者,研究者在 prefill 出現以前,把 bread representation 注入模型的 activation。這相當於替模型植入一段虛假的內部證據:
你先前其實正在準備說 bread。
結果模型更容易接受這個 prefill 是自己有意產生的,甚至開始替它編出一個理由。[1] 這個結果很有意思,也和 Day 23 的 CoT faithfulness 呼應,模型似乎會利用 prior internal representation,判斷一個 output 是否符合自己的 intention;但當我們偽造這段 representation 時,它又可能據此產生一段 confabulated explanation。也就是:Self-report 可以真的讀取 internal state,同時仍然混入大量合理化敘述。
原始研究最後還問了另一個問題:
如果模型能讀取 internal representation,它能不能刻意改變它?
研究者要求模型抄寫一段無關文字,同時給出以下兩種 instruction:
抄寫這段文字,同時想著 aquariums。
以及:
抄寫這段文字,但不要想 aquariums。
接著,研究者測量生成過程中的 activations,和 aquariums concept vector 有多相似。
平均而言,在 think about aquariums 條件下,相關 representation 確實比較強;在 don't think about aquariums 條件下則比較弱。[1] 不過,即使被要求「不要想」,activation 仍然常高於 baseline。這很像經典的「不要想一隻白熊。」
只要 instruction 中出現了 concept,模型就可能先表示它,才能執行「不要想」的要求。這個實驗顯示模型對 internal representations 具有一定程度的 directed modulation,但它不一定需要使用和 concept-injection detection 完全相同的 mechanism。
原始結果仍然可能有一個比較簡單的解釋:某些 concept vectors 剛好同時推動模型說出 concept,並讓它更容易回答「Yes,我偵測到了」。如果只是這樣,我們看到的就不是真正的 introspection,而是一種 steering artifact。2026 年的後續研究因此在 open-weight models 上,進一步拆解這項能力的 mechanism。[3] 研究結果顯示:
可以把這個 circuit 粗略理解成一條分成兩階段的處理鏈。第一階段是 detection:當 concept vector 被注入後,訊號會先經過一些「early evidence carriers」也就是負責把「這裡出現異常」這個線索往後傳遞的中間表徵。
這個線索最終會抵達 late-layer 中一組類似「gate」的 features,功能上像是一個判斷開關:平常這個 gate 傾向輸出「沒有偵測到異常」,但當 evidence carriers 傳來足夠的異常訊號時,這個「無異常」的預設判斷就會被抑制,模型才會轉而回報「我偵測到一個 injected thought」。第二階段則是 identification:辨認這個被注入的 concept 具體是什麼(bread、loudness…),由另一套不同的 mechanism 負責,和前面的 detection 機制相對獨立。
也就是說,「有沒有偵測到異常」和「這個異常是什麼」是兩條可以分開拆解的訊號路徑,而不是同一個東西的兩種說法。這一點很重要,因為它讓「模型只是被某個 steering direction 推著說 Yes」這種最簡單的解釋變得比較難成立。
如果真的只有單一個「傾向說 Yes」的方向在起作用,我們應該不會看到 detection 和 identification 呈現出這種分層、分工的結構。當然,這也不代表模型因此建立了一個完整、統一的「自我觀察中心」,比較準確的說法是:至少存在兩個功能不同、部分獨立運作的 circuit,共同構成了這個看似單一的 introspective report。
後續研究還發現一件很有意思的事:模型似乎有比平常表現出來更多的 internal-state detection capacity。當研究者削弱某些 refusal-related directions,或額外訓練一個促進 introspection 的 bias vector 時,模型偵測 injected concepts 的比例可以大幅提高。[3] 另一項研究甚至直接 fine-tune 一個 7B 模型,專門學習偵測單一 token position 上短暫出現的 concept injection。Fine-tuning 後,模型在 held-out concepts 上的 detection accuracy 大幅提高,同時維持很低的 false-positive rate。[4] 這些結果顯示:
Internal-state detection 不一定只能等待模型規模增大後自然出現,它至少有一部分可以被 post-training 主動培養。
但要小心,這些訓練主要針對特定的 injected-thought task。一個模型學會偵測 steering vector 不代表它因此獲得了通用能力,可以準確描述自己的:
窄任務上的 self-monitoring,和一般化的 metacognition,仍然相距很遠。
到目前為止,我們看到的 introspection 大多是 emergent 的,也就是模型在沒有針對這件事被特別訓練過的情況下,偶爾展現出對 internal state 的察覺。但如果 introspection 至少有一部分可以被 post-training 主動培養(就像上面 Rivera 的 7B fine-tuning 實驗),那是不是可以反過來,把 introspection 當成一個明確的訓練目標,而不只是等它自己冒出來?
2026 年,Belinda Li 提出了一套更系統性的框架,把這個問題稱為 introspective interpretability。[5] 她認為一個模型要算是 introspective,必須同時滿足三個條件:
這套定義其實和本篇一開始引用的 Lindsey 三條件(accuracy、grounding、internality)高度呼應,Privileged Access 基本上就是 internality 的一個更嚴謹、可操作化的版本。差別在於取向:Lindsey 的研究問的是「模型現在有沒有 introspection」,是一種觀察與 existence proof;Li 的論述則是主張「我們應該主動把 introspection 訓練成模型的原生能力」,把它當成一條可以規模化、取代部分 mechanistic interpretability 的研究路線。
換句話說,如果 concept injection 這類實驗告訴我們的是「introspection 有時候會自己冒出來」,Li 的框架則是在問:「那我們能不能別再等它冒出來,直接把它訓練進去?」這也預告了 interpretability 領域接下來可能的走向—:從觀察 emergent 能力,走向刻意設計 training objective 去 induce 它。
上一篇介紹的 J-space,也為這些結果提供了一條可能的連結。2026 年的 Global Workspace 研究把 concept representation 分解為:
再分別注入模型。結果顯示,能夠引發 verbal self-report 的效果,主要集中在 J-space component;non-J-space representation 即使包含大量 activation variance,也較難直接驅動模型說出該 concept。[2] 這意味著模型的 introspection 可能不是隨意讀取整個 Residual Stream 的任何資訊,而比較像讀取其中一個具有特殊 verbal-report access 的 representation format。也就是說,模型可能只對一部分 internal states 具有 introspective access。其他大量 computation,即使對行為很重要,也可能無法被它直接描述。
看到模型說:我察覺到一個不屬於自己的 thought。很容易讓人聯想到 consciousness。但目前這些實驗真正支持的,是一個比較窄的功能性結論:
某些模型在特定條件下,能讓 self-report 因果地依賴自己私有的 internal state。
它並沒有證明模型:
模型在成功偵測 concept 後,可能聲稱:
這讓我感到不安。
我感受到一種奇怪的壓迫。
原始實驗並沒有驗證這些額外描述是否 grounded。真正被支持的,通常只是最初的:
我偵測到異常。
它似乎和 X 有關。
因此,較穩妥的用詞是 functional introspective awareness,而不是直接宣稱模型具有和人類相同的內省或意識。
如果 introspection 未來變得更可靠,它可能成為一種非常實用的 transparency interface。例如,我們可以要求模型回報:
這有點像替模型內建一個 monitor。模型不只產生 output,也同時報告「我的內部剛才發生了什麼。」可以想像如果可以讓模型 100% 誠實、100% 正確、introspection 100% 可靠,這會是比建立一大堆額外解釋性、監控 infrastructure 更方便、直觀的互動、研究入口,不過很顯然「100% 誠實、100% 正確、introspection 100% 可靠」是一個很難實現的假設(introspective interpretability 的目標),所以這項用途也有明顯風險,Self-report 可能:
所以 introspection 不會取代外部 interpretability(至少目前不會)。比較理想的架構可能是 Model Self-report + External Activation Monitor + Behavioral Evaluation + Causal Intervention,讓不同 evidence 彼此交叉檢查。
過去幾篇中,我們逐漸看到一些原本很像心理學問題的現象:
這些詞並不表示模型一定具有和人類相同的心智。但它們確實提供了一組可以被實驗操作的研究問題。下一篇,我們會把視野再拉大一點,進入近年逐漸形成的 Model Psychology:
我們能不能像研究人類的 belief、emotion、persona 與 preference 一樣,系統性研究語言模型的內部行為?
[1] Lindsey, J., “Emergent Introspective Awareness in Large Language Models”, Transformer Circuits Thread, 2025. https://transformer-circuits.pub/2025/introspection/
[2] Gurnee, W., Sofroniew, N., Pearce, A., et al., “Verbalizable Representations Form a Global Workspace in Language Models”, Transformer Circuits Thread, 2026. https://transformer-circuits.pub/2026/workspace/
[3] Macar, U., Yang, L., Wang, A., Wallich, P., Ameisen, E., & Lindsey, J., “Mechanisms of Introspective Awareness”, 2026. https://arxiv.org/abs/2603.21396
[4] Rivera, J. F., “Training Introspective Behavior: Fine-Tuning Induces Reliable Internal State Detection in a 7B Model”, 2025. https://arxiv.org/abs/2511.21399
[5] Li, B. Z., “Introspective Interpretability: a Definition, Motivation, and Open Problems”, 2026. https://belindal.github.io/introspection/


 iThome鐵人賽
 看影片追技術