

Day 7 談到一件事:
Conversation 可以消失,但重要狀態必須能從 Repository 重新取得。
這解決的是「Agent 要去哪裡找回正確 Context」。
但實際工作再往前走,很快又遇到另一種重複。
有些東西不是「現在做到哪」。
也不是「為什麼這樣決定」。
而是每次進到新的 Repository、開新的 Session、準備修改 Code 之前,都在重新教一次:
先確認 repo root
先讀 applicable instructions
先看 Git working tree
不要蓋掉使用者原本的修改
先確認這次允許改什麼
完成後要跑哪些 verification
失敗時不要把 baseline failure 算成這次造成
一開始,把這些規則放在 Prompt 裡最合理。
但當同一套程序開始出現在不同 Repo、不同 Session,而且每次只差少量參數時,新的問題就出現了:
我到底是在重複描述一個需求,還是在重複安裝一種能力?
這也是後來開始把部分 Prompt 抽成 Skill 的原因。Skill 並沒有因此比 Prompt 高級;只是我開始懷疑:
如果一個 Agent 連同一件事都還要每輪重新教,真的需要先增加第二個 Agent 嗎?
在幾個 Repository 之間工作後,最明顯的重複之一是「修改前檢查」。
每次開始任務,大概都會出現類似提醒:
修改前先確認:
- 目前在哪個 repo
- 有哪些 AGENTS.md / instruction
- working tree 是否已有變更
- 這些變更是不是使用者自己的
- 本次 scope 是什麼
- 有沒有 migration / deploy / production risk
如果只是偶爾做一次,把它寫在 Prompt 裡最便宜。
但這些步驟開始反覆出現,而且不是文案偏好;漏掉其中幾項,真的可能造成工程風險。
例如 Agent 沒先確認 working tree,就可能把原本存在的變更一起算進自己的工作;沒有先找 applicable instructions,就可能用錯 Repository 的規則;沒有先確認 authority boundary,就可能把「可以修改 Code」誤解成「可以 deploy」。
於是我先做的並不是:
再開一個專門負責安全的 Agent
而是把這套反覆出現的能力抽出來。
在自己的 shared Agent platform 裡,它後來變成:
ap-safe-preflight
它不是某個專案功能,而是一個跨 Repository 都反覆需要的工作能力:
在 mutation 之前,先建立可信的起點。
一段 Prompt 很長,不代表它就應該變成 Skill。
反過來,一段只有十幾行的流程,如果每個 Repo 都需要,而且錯一次代價很高,也可能很值得抽離。
後來我不再用:
「這個 Prompt 已經很長了。」
作為抽 Skill 的理由。
我比較在意的是下面幾件事。
REPEATABILITY
這件事是否反覆出現?

STABILITY
核心步驟是否已經相對穩定?

BOUNDARY
它負責什麼、不負責什麼,能不能說清楚?

EVIDENCE
執行後能不能留下可檢查的結果?

PORTABILITY
換一個 Session 或 Repository,是否仍然成立?
當這五項開始同時成立時,它就比較不像一次性的 Prompt,而比較像:
可以被安裝、呼叫、驗證的能力單元。
它不只是 Prompt 模板的進階版,更接近:
Agent 與某一類工作之間,可重用的契約。
例如一個 preflight Skill,至少應該說清楚:
什麼時候用
↓
需要哪些輸入
↓
按什麼步驟做
↓
遇到什麼條件要停
↓
最後應留下哪些 evidence
↓
哪些事情不是它的責任
最容易被忽略的是最後一項。
因為如果 Skill 只是不斷把更多規則塞進去,它很快又會變成另一份超級 Prompt。
例如 ap-safe-preflight 不應該順便負責:
它的責任應該停在:
mutation 前,確認起始狀態與風險邊界。
而另一個 shared Skill:
ap-verification-core
才負責完成階段的 verification evidence 與失敗歸因。
把責任拆開後,價值在於:
每個能力的 failure boundary 開始變得可理解。
Day 3 談 AGENTS.md 時,已經遇到過一次類似問題。
Repository 的長期 invariant 很適合放進 AGENTS.md:
不要擅自 deploy
修改前先確認狀態
不要碰 scope 外檔案
完成必須有 verification
但如果開始把完整操作程序也塞進去:
步驟 1 跑什麼
步驟 2 解析什麼
步驟 3 比對什麼
步驟 4 產生什麼 evidence
步驟 5 哪些 exit condition
...
AGENTS.md 很快就會從「Repository 的工作地圖」變成一份巨大的操作手冊。
這會讓每個 Session 都背著不必要的 Context。
比較合理的是:
AGENTS.md
→ 說明何時必須使用某種能力

Skill
→ 承擔那套能力的詳細流程
例如:
AGENTS.md
「mutation 前必須執行 safe preflight」

        ↓

ap-safe-preflight
「safe preflight 到底怎麼做」
這樣 Agent 先知道有哪些能力存在,需要時再載入完整操作內容。
OpenAI 的〈建立技能〉文件把這種設計稱為 progressive disclosure:ChatGPT 與 Codex 先取得 Skill 的名稱與描述,選用後才載入完整 SKILL.md;references、scripts 等內容則在需要時再讀取或執行。
它的價值除了節省 Token,還包括:
不用讓每個 Session 一開始就吞下所有可能用到的操作細節。
做到這裡,我也開始發現「抽成 Skill」不能只有一種模板。
因為重複內容的性質不同。
至少可以先分成五類。
| 類型 | 它在解什麼 | 例子 |
|---|---|---|
| Knowledge | Agent 反覆需要知道什麼 | 特定技術或 domain 操作知識 |
| Workflow | Agent 反覆要走哪些步驟 | preflight、release preparation |
| Verification | 怎麼證明工作完成 | test selection、failure attribution |
| Tool | 怎麼正確使用某個工具 | 固定 script / command contract |
| Policy | 哪些情況必須停或升級 | production、migration、security gate |
更實際的問題是:
這一次任務到底需要哪一種能力?
而不是把全部 Context 一次倒進去。
這題沒有神奇數字。「三次就一定要抽」並不存在,重複次數只是其中一個訊號。
還要看四個成本。
每一次新 Session 都要重新貼:
規則
步驟
例外
驗證方式
這會直接消耗 Context,也增加漏講的機率。
同一件事用自然語言講十次,十次可能有細微差異。
例如這一輪寫:
先看 Git status
下一輪寫:
先確認 working tree
再下一輪又漏掉「保護既有使用者變更」。
文字看起來接近,但 safety contract 已經漂移。
如果規則要改,一份 Prompt 好改;十個 Repository 各有一份相似版本,就開始麻煩。
但抽 Skill 也不是免費的。
它會多出:
判斷標準不能只是「有重複就抽 Skill」,而應該看:
重複造成的 drift / risk / Context 成本
>
新增 Skill 的維護成本
才值得升級。
如果某段 Prompt 開始反覆出現,可以先問:
1. 這是不是跨 Session / Repo 重複出現?

2. 核心流程是否已經穩定,
   還是每次其實都在重新探索?

3. 漏掉它會只是麻煩,
   還是可能真的造成風險?

4. 能不能定義清楚輸入、輸出、停止條件?

5. 執行結果能不能留下 Evidence?

6. 抽出後,是否真的減少重複,
   還是只是多一個檔案要維護?
如果前五題大多是「是」,第六題也成立,
才比較值得抽。
反過來,如果流程每次都不一樣、還在探索期、沒有穩定 contract,
那就繼續放在 Prompt 裡。
因為:
太早抽象,只是把尚未理解的問題固定成錯的介面。
這是這篇最想保留的一個差別。
假設現在有一個 Agent,做長任務時常常漏掉 preflight。
直覺上可能會想:
Agent A
→ 負責實作

Agent B
→ 負責安全檢查
但這會立刻多出新的問題:
誰先跑?

A 與 B 怎麼交接?

B 的結果怎麼傳給 A?

兩邊看到的 Git state 是否一致?

如果 B 判斷錯,誰負責?

多一次 Agent invocation 值不值得?
原本只是「缺一套穩定 preflight 能力」,結果變成「要治理兩個 Agent」。
遇到 Agent 能力不足時,可以先問:
缺的是另一個角色,還是現有 Agent 缺一個可重用能力?
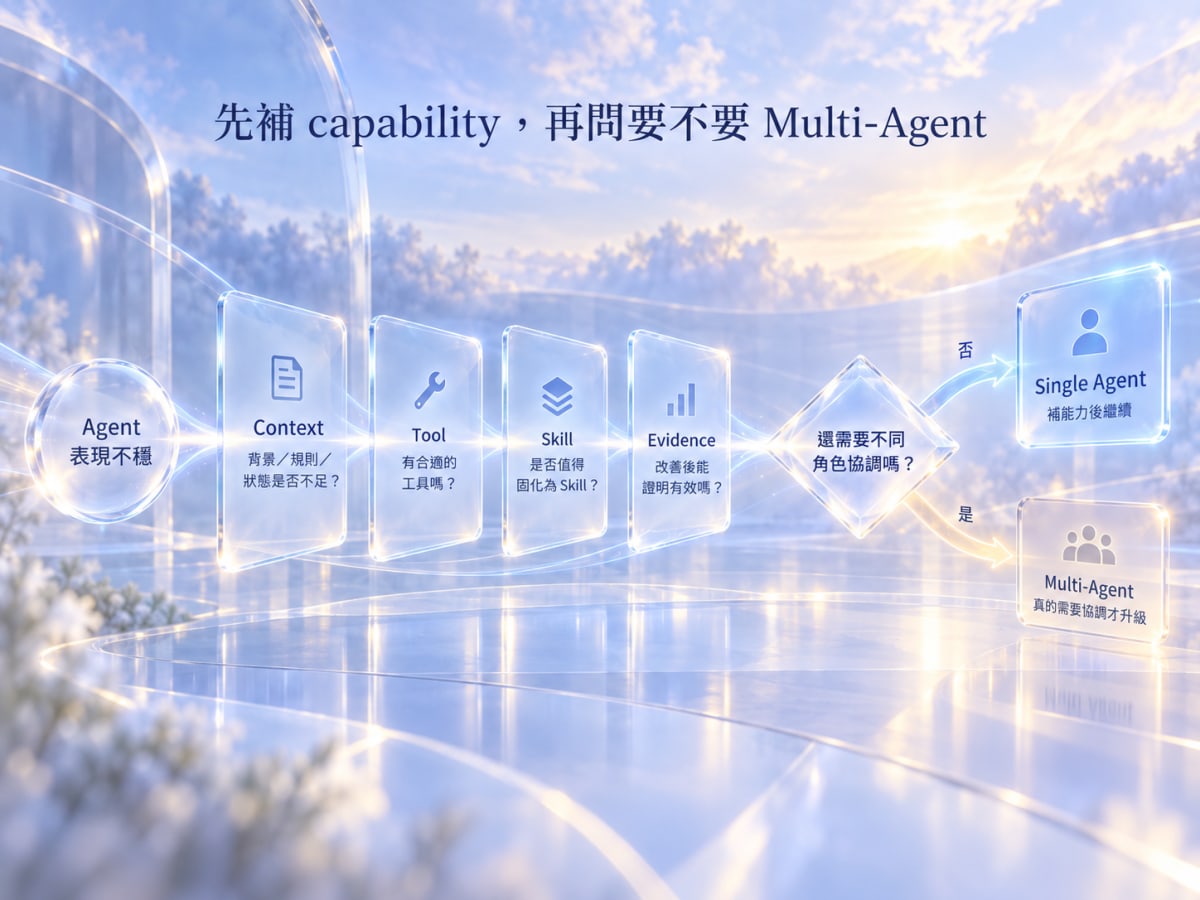
如果是後者,先補 Skill 往往更便宜。
這也和 Anthropic 在《Building Effective Agents》提出的方向一致:先從最簡單可行的方案開始,只有當更高複雜度能明確改善結果時才升級。至於 Skill 的載入與重用方式,則以 OpenAI 的 Skills 文件作為本文的官方對照。
這不代表「Single Agent 永遠比較好」。比較重要的是保留一個懷疑:
每一次想加 Agent 之前,先證明問題真的需要 coordination,而不是只缺 capability。
「現在有 Skill 了,比較專業」並不能證明任何事。
目前能確認的改善,是把散落在每次 Prompt 裡的責任,變成 Repository 裡可重新取得的能力定義。 ap-safe-preflight 負責 mutation 前的起始狀態與 risk gate, ap-verification-core 負責完成階段的 verification evidence 與 failure attribution。
長期工作因此從:
每個 Repo
各自複製一套 Prompt
逐步變成:
Repo
→ 宣告需要的能力
→ Agent 載入 Skill
→ 執行
→ 留下 Evidence
至少從結構上,這已經把「重複提醒」變成「可重用能力」。
Skill 一旦開始被多個 Repository 使用,下一個問題馬上出現:
如果 Skill 自己改了,其他 Repo 怎麼知道?
再往下還會碰到:
這些已經不是「要不要抽 Skill」的問題了。
而是:
共用能力本身,也開始需要 lifecycle governance。
這部分先停在這裡。若把 version、compatibility、sync、rollout 全部展開,主題就會從「Prompt 什麼時候應該升級成 Skill?」跳成「Shared Skills 要怎麼做版本治理?」——那是下一層問題。
最後還要防另一個極端。
既然重複 Prompt 可以抽 Skill,很容易開始把所有事情都 Skill 化:
寫 README 一個 Skill
改 CSS 一個 Skill
跑 npm test 一個 Skill
看 Git diff 一個 Skill
回報完成一個 Skill
最後 Agent 還沒開始工作,就先花大量時間判斷到底要載入哪十幾個 Skills。
這只是把 Prompt inflation 換成 Skill inflation。
我反而會保留一個刪除條件:
如果一個 Skill 無法降低 Context 重複、行為漂移、風險或人工注意力,它就沒有因為「被抽象」而自動變得有價值。
Skill 仍然是一種複雜度,也一樣要證明自己值得存在。
前幾天處理的是 Context:怎麼工作、現在在哪、為什麼這樣做,以及 Conversation 消失後去哪裡重建真相。
走到今天,問題進入另一層:
Skill
→ 哪些重複工作能力,不應該每輪重新教
最大的轉折在於:
能力不足
≠
一定需要更多 Agent
當 Agent 做不好一件事時,先問:
Context 是否不足?
Tool 是否缺失?
是否有重複程序可以抽成 Skill?
Verification 是否太弱?
這些都還沒解決就升級成 Multi-Agent,很可能只是把一個 Agent 的問題變成 coordination problem。
更合理的順序是:
Context
→ Tool
→ Skill
→ Evidence
→ 再問是否真的需要另一個 Agent
這個判斷保留 Multi-Agent,但要求:
架構複雜度必須先賺到它存在的理由。
Skill 被抽出來之後,新的問題改成:
當同一個 Skill 開始被多個 Repository 共用,它自己要怎麼避免變成新的治理風險?
這會把問題從「能力重用」推向「能力的版本與相容性」。


 iThome鐵人賽
 看影片追技術