

把規劃、執行、評估分成三種責任之後,很容易再往前一步:讓三個 Agent 同時工作,應該就會更快。
但這個系列的現有紀錄,還沒有一組足以回答問題的對照:同一個任務、同一份起始狀態與驗收條件,分別以單 Agent 和多 Agent 完成,並記錄從開始到整合驗證結束的時間。
因此,這篇不能交出「多 Agent 快了多少」的答案。它先把比較條件定清楚,避免把同時開工當成效率成果。
Multi-Agent 是否值得,要把平行執行的收益和協調成本一起算,並以相同完成條件比較。
兩個子任務都回報完成,整體任務仍可能沒完成。還需要比對介面、整合修改、處理分歧,再對最後的共同狀態驗證。
如果只量每個 worker 的工作時間,下面這些成本會消失在報表之外:
這些是待量測項目,不是本專案已經量到的損耗。
先看依賴是否真的可以拆開:
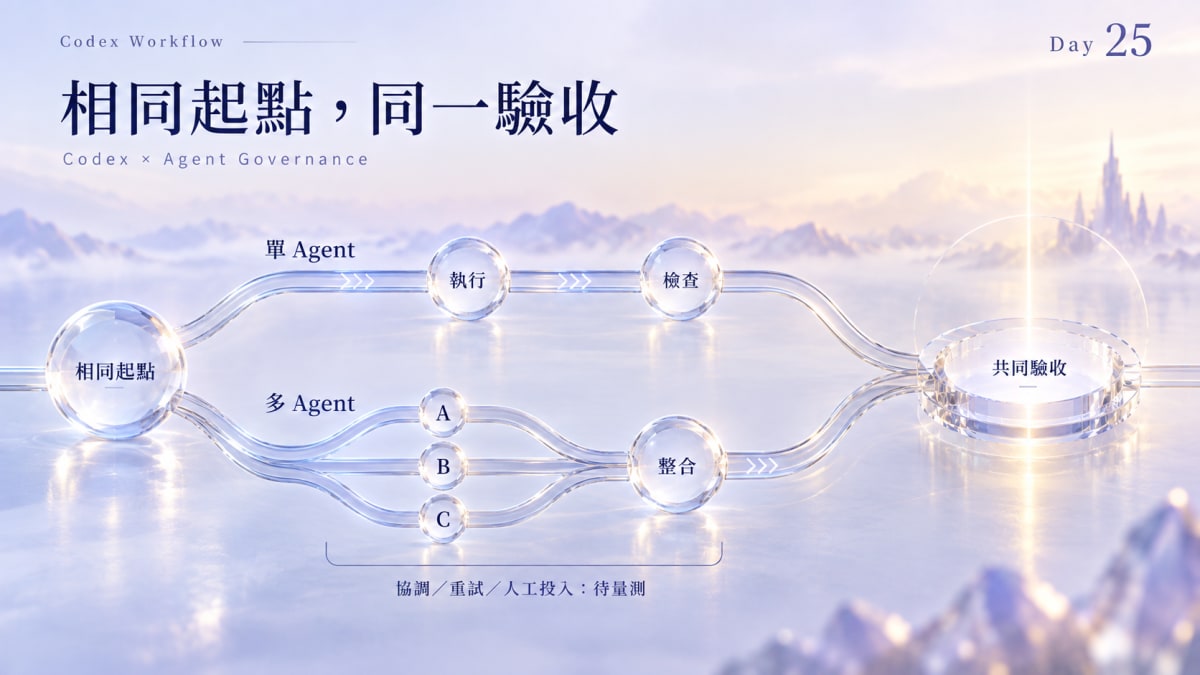
A ──┐
B ──┼→ 整合與共同驗證
C ──┘
若 A、B、C 有固定輸入與交付界線,可以先分別完成,再整合。若後一步必須依賴前一步的新決策,則較接近:
A → B → C
硬把後一種流程拆成三個同時工作的 Agent,並不會消除依賴,可能只增加等待與交接。
Day 13 的工作樹隔離只處理修改狀態的分開。兩個 Agent 即使沒有改同一檔案,也可能對同一介面的回傳格式各作一套假設;是否存在這種語意衝突,要在整合結果中另外檢查。
最小對照可以先固定:
起點:相同 commit、任務、工具與可讀資料
終點:相同驗收條件通過,整合後產物已檢查
單 Agent:先給完整而清楚的 Context、工具與驗證條件
平行組:明列任務切分、共享介面、owner 與整合責任
另外記錄請求的模型與推理強度、實際執行環境、同時工作的 Agent 上限,以及哪些 runtime 資訊無法取得。若兩組配置不同,時間差便不能全部歸因於 Agent 數量。
不能讓單 Agent 承擔模糊需求,卻給平行組一份已收斂計畫。第二輪也可能從第一輪學到解法;若要比較,要記錄執行順序與可見資料,避免把學習效應誤判成平行收益。
至少應分開記錄以下結果:
| 欄位 | 計算邊界 |
|---|---|
| 經過時間 | 從任務開始到最終整合驗證完成,包含等待與修正 |
| 模型用量 | 合計所有 worker、協調與評估的用量;拿不到就標未知 |
| 重試 | 區分工具失敗、錯誤假設、驗收未過與整合重做 |
| 整合成本 | 衝突處理與共同驗證時間,不只計算 merge conflict |
| 人工投入 | 人閱讀、澄清、裁決與修正的實際時間 |
| 完成品質 | 相同驗收條件的通過/未通過及未驗證項目 |
當經過時間下降,但模型用量或人工投入上升,是否值得取決於任務目標。截止時間優先與總成本優先,可能選擇不同安排。
GPT‑6 系列指南現在也提供 delegation 與 multi-agent workflow:互不相依的子任務可以交給子 Agent,再整合發現。這證明產品能力存在,也替「可分解的工作可以平行」提供一個官方 pattern。
但指南同時要求依賴關係要保留:等待某個工具結果的工作,仍要等結果回來再繼續。也就是說,delegation 不會把 A → B → C 變成三條真正獨立的路。
因此,本篇的 Evidence Gate 不變。官方能力不能替代同任務 single / parallel matched run;在沒有總經過時間、重試、整合與人工投入之前,仍不能說多 Agent 比單 Agent 更快或更省。
2026-10-08,我用 Issue #6 的正式結構盤點做了一個固定輸入的摘要任務,分別跑單 Agent 與兩個獨立角色。兩組都通過同一份 JSON 驗收:日期、五項資料筆數及五項零值檢查完全吻合,並把結論限制在結構證據。
單 Agent 的執行回報為 3 秒;兩個角色依序完成,整體執行區間為 7 秒,之後由我整合兩段輸出,驗收器在不到一秒內通過兩組。這不是並行速度比較:時間戳沒有重疊,計時是 Agent 回報,人工投入沒有計時,推理強度與 Token 用量不可見,任務也只是摘要而非程式修改。細節、原始輸出與驗收條件保存在同日實驗紀錄。
這次結果只證明兩種安排都能完成這個小任務。雙角色的分工和整合有實際發生,但目前沒有證據說明它值得額外成本;Issue #4 的實作級、可重查對照仍待補。
仍缺一組隔離工作區中的小型 repo 修改對照,包含相同起始 commit、相同測試、可比較的模型與推理設定,以及計時的人工作業與整合。這次試跑無法取得 Token/成本,也沒有交換順序重跑,不能外推成通用效率結論。
在這些資料補齊前,本文的量測設計可用,但效率結論仍未成立。
把評估交給另一個執行脈絡,目的是讓驗收不只沿用執行者的自評。Day 24 已有產物與自評不同的例子;那能說明評估責任,不能證明增加一個 Agent 比同一個 Agent 重新對照原始條件更划算。
因此,對照實驗也要固定評估要求。若平行組多做一輪獨立審查,單 Agent 組卻沒有相同品質門檻,兩組的時間差便混入了不同工作量。
先把單 Agent 的輸入、工具與驗證補完整,才知道剩下的瓶頸是工作本身可平行,還是需求與證據沒有整理好。
這不是預先判定多 Agent 沒用。它要求增加協調層之前,先說出要改善哪一個可觀察的瓶頸,以及多出的成本會記在哪裡。
下一篇把成本再拆一層:文件變短、模型少讀一點,是否真的讓 Agent 與人更容易重新理解系統?


 iThome鐵人賽
 看影片追技術