
一、當請求不再是「一來一回」
前面二十七天的所有測試,骨子裡都是同一個動作:發一個請求,等一個回應,量中間的時間。HTTP 的世界觀就是一來一回,http_req_duration 量的就是這一回合。但有些功能不是這樣運作的:聊天室的訊息是伺服器「推」給你的,你沒有發請求;即時報價的數字自己在跳;線上遊戲、共編文件、IoT 儀表板——這些的底層是 WebSocket:連線建立一次,之後雙方隨時互丟訊息,連線一直掛著。
這個差別讓效能測試的問題整組換掉。HTTP 測試問「一次請求多久回來」「每秒能處理幾個請求」;長連線的世界裡,連線掛著不動也占資源,於是問題變成:「同時掛一萬條連線,伺服器撐得住嗎」「訊息從伺服器推出來,多久到我手上」「掛了一小時的連線,會不會被誰默默斷掉」。一句話:HTTP 量回合,WebSocket 量「同時掛著的量」與「訊息的延遲」。
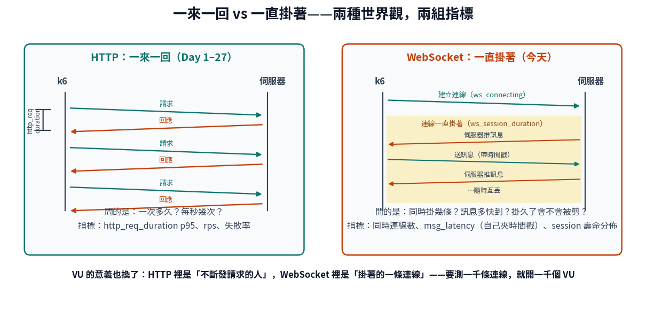
圖 1:一來一回 vs 一直掛著——兩種世界觀,兩組完全不同的指標
對應到 k6 的指標,變化是這樣: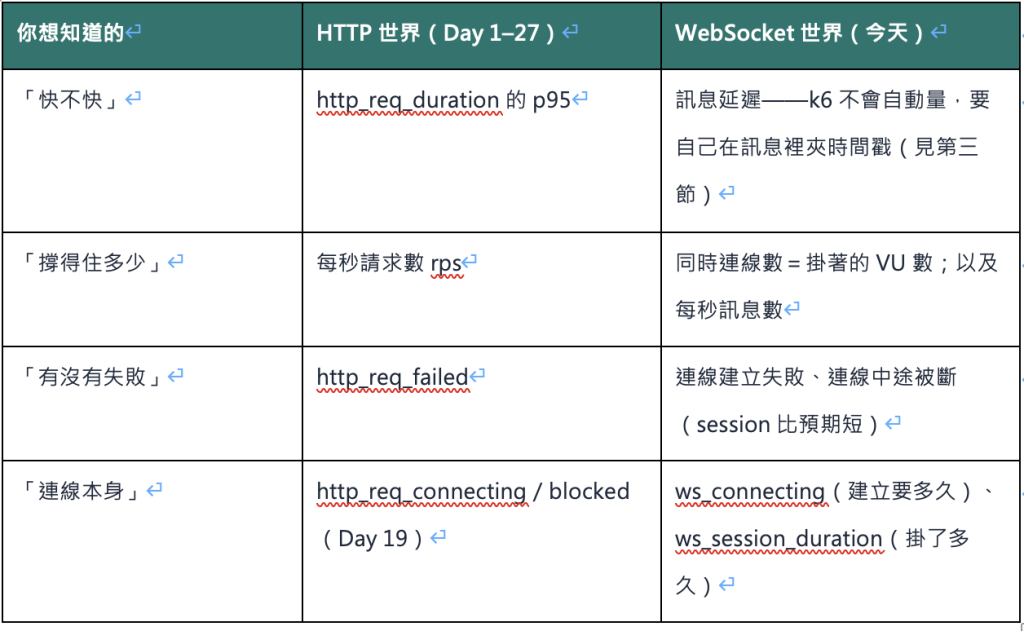
表裡最重要的一格是右上角:訊息延遲 k6 不會自動給你。HTTP 的一來一回,k6 兩頭都看得到,時間自己就量出來了;伺服器主動推的訊息,k6 只看得到「收到的那一刻」,不知道它是什麼時候出發的。解法很老派也很有效:讓訊息裡帶著出發時間,收到時相減。這件事第三節動手做。
二、思維轉換:VU 在長連線測試裡是什麼
寫腳本之前,先把一個觀念換過來,不換的話數字會全部讀錯。
HTTP 測試裡,VU 是「不斷發請求的人」,30 個 VU 可以每秒打出上百個請求;長連線測試裡,VU 是「掛著的一條連線」——它連上去、待著、偶爾收發訊息。所以 30 個 VU 的意思不再是「一秒上百請求的壓力」,而是「同時 30 條連線」。要測一千條同時連線,就真的需要一千個 VU——好消息是掛著的連線很便宜,k6 撐幾千條協定層 WebSocket 連線沒有問題;真的要上萬,回 Day 25 的三條路。
負載模型也跟著換。Day 12 的 ramping 在這裡的意義是「連線湧入的速度」——尖峰時每秒新建幾條連線,本身就是一個要測的東西(連線建立比維持貴得多);Day 24 的 soak 在長連線世界甚至更重要,因為長連線最常見的事故就是「掛久了出事」:伺服器、負載平衡器、防火牆都可能有自己的閒置逾時,60 秒沒動靜就把連線默默剪掉——使用者的體感是「聊天室用著用著就斷線重連」。測長連線,時間軸永遠是主角之一。
三、動手做:壓 QuickPizza 的 WebSocket
QuickPizza 有一個 WebSocket 端點可以練習。讓 Claude Code 生成,需求裡把長連線的關鍵都點名:
Prompt 1|WebSocket 壓測腳本
請幫我寫一支 k6 WebSocket 壓測腳本(tests/ws.js),目標是 QuickPizza 的
WebSocket 端點(請先查官方文件或範例確認目前的端點路徑與訊息格式):
- 50 個 VU,每個 VU:建立連線 → 掛著 3 分鐘 → 期間每 10 秒送一則訊息
  (訊息內容帶上送出當下的時間戳)→ 收到訊息時,若含時間戳就計算延遲
- 用自訂 Trend 指標記錄「訊息延遲」,叫 msg_latency
- thresholds:連線建立 ws_connecting p(95)<1000;msg_latency p(95)<500;
  連線失敗率要能看到
- 請用 k6 目前建議的 WebSocket 模組寫法(新舊兩套 API 請幫我選現行建議的那套)
- 逐段解釋,特別是:時間戳夾帶與相減的位置、VU 掛著時程式在「等」什麼
骨架大致如下(模組寫法與端點以 Claude Code 查到的現行版本為準):
import { WebSocket } from 'k6/experimental/websockets';   // 以現行建議模組為準
import { Trend, Rate } from 'k6/metrics';

const msgLatency  = new Trend('msg_latency', true);
const connectFail = new Rate('ws_connect_fail');

export const options = {
  vus: 50, duration: '3m',
  thresholds: {
    ws_connecting:  ['p(95)<1000'],
    msg_latency:    ['p(95)<500'],
    ws_connect_fail:['rate<0.01'],
  },
};

export default function () {
  const ws = new WebSocket('wss://quickpizza.grafana.com/ws');  // 端點以查到的為準
  ws.onopen = () => {
    // 每 10 秒送一則帶時間戳的訊息
    const timer = setInterval(() => {
      ws.send(JSON.stringify({ t: Date.now(), msg: 'ping from k6' }));
    }, 10000);
    setTimeout(() => { clearInterval(timer); ws.close(); }, 170000); // 掛滿再收
  };
  ws.onmessage = (e) => {
    try {
      const d = JSON.parse(e.data);
      if (d.t) msgLatency.add(Date.now() - d.t);   // 出發時間相減=延遲
    } catch (_) {}
  };
  ws.onerror = () => connectFail.add(1);
}
跑起來之後,讀數的方式照這個順序:
先看連線層。ws_connecting 的 p95 是「建立一條連線要多久」——50 條同時湧入時它會不會飆?connect_fail 有沒有出現?這一層有問題,後面都不用看。再看 session。ws_session_duration 應該貼著你設計的時長(掛 170 秒就該接近 170 秒)——如果一堆 session 只活了 60 秒上下,恭喜你抓到了某一層的閒置逾時,這是長連線測試最有價值的發現之一,把「60 秒」這個數字帶去 Day 22 開單,RD 會知道去查哪裡。最後看訊息。msg_latency 的 p95 和分佈——它是長連線世界的 http_req_duration,Day 3 的百分位、Day 18 的分佈思維全部適用。
判讀交給 Claude Code 的 prompt 邏輯照舊(Day 18、24 的路數),多教它一件事:session 長度的分佈比平均重要——平均 150 秒可能是「大多數活滿、少數秒斷」,也可能是「全部活 150 秒被齊頭剪掉」,兩者是完全不同的問題。
四、SOAP:老朋友,新工具,同一招
換個完全不同的方向。如果你在台灣的金融、保險、電信或政府環境做測試,大概率遇過 SOAP——WSDL、信封(Envelope)、XML 巢狀到天邊。這些系統穩定運行了十幾二十年,也還會繼續跑很多年,「效能測試工具都在講 REST 和 JSON,我的系統是 SOAP 怎麼辦」是個真實的焦慮。
答案短得出乎意料:對 k6 來說,SOAP 就是「POST 一段 XML 到一個網址」。它跑在 HTTP 上,所以 Day 8 的 http.post、Day 3 的百分位、Day 7 的 thresholds、Day 12 的負載模型——全部直接適用,一天新東西都不用學。差別只有三個細節:Content-Type 是 XML 的、要多一個 SOAPAction 標頭、body 是那段信封。實際長相:
import http from 'k6/http';
import { check } from 'k6';

const envelope = `<?xml version="1.0" encoding="utf-8"?>
<soap:Envelope xmlns:soap="http://schemas.xmlsoap.org/soap/envelope/">
  <soap:Body>
    <QueryBalance xmlns="http://example.com/bank">
      <AccountId>${__ENV.TEST_ACCOUNT}</AccountId>
    </QueryBalance>
  </soap:Body>
</soap:Envelope>`;

export default function () {
  const res = http.post('https://staging.example.com/BankService.asmx', envelope, {
    headers: {
      'Content-Type': 'text/xml; charset=utf-8',
      'SOAPAction':  '"http://example.com/bank/QueryBalance"',
    },
  });
  check(res, {
    '狀態 200': (r) => r.status === 200,
    '沒有 SOAP Fault': (r) => !r.body.includes('<soap:Fault>'),   // 重要!見下
  });
}
兩個 SOAP 特有的坑。第一,錯誤藏在 200 裡。SOAP 服務常常在出錯時照樣回 HTTP 200,錯誤寫在 body 的 Fault 元素裡——只 check 狀態碼,你會拿到一份全綠但全錯的報告(Day 11 除錯八成在腳本的老教訓,SOAP 版)。所以 check 一定要看 body。第二,信封不用手寫。跟 RD 要 WSDL 檔或一段實際請求的範例(用系統既有的工具或紀錄都抓得到),丟給 Claude Code:「照這個 WSDL/範例幫我產生 QueryBalance 的請求信封,帳號參數化」——XML 巢狀到天邊沒關係,那是它的工作。你的工作還是 Day 4 的五要素和 Day 16 的門檻。
五、gRPC:知道存在,需要時再深入
最後一個名詞用一頁講完。gRPC 是微服務之間常用的通訊協定——服務對服務的內部呼叫,追求高效,用二進位格式(Protocol Buffers)而不是 JSON。你在瀏覽器的網路面板看不到它,因為它多半活在機房內部,服務與服務之間。
關於它,QA 需要知道的就三件事。第一,k6 原生支援(k6/net/grpc 模組),寫起來和 http 模組的手感類似:連線、呼叫方法、check 回應。第二,需要 proto 檔——gRPC 的介面定義寫在 .proto 檔裡,相當於 SOAP 的 WSDL;沒有它腳本寫不了,而它在 RD 的 repo 裡,所以測 gRPC 天生就是協作題。第三,測試的發起點通常在內網——gRPC 服務很少直接對外,你的施壓位置要能碰到它,Day 25 借內網機器的做法在這裡是常態。
什麼時候需要深入?當你的團隊說「前台 API 很快,慢的是後面服務之間的呼叫」——那句話出現時,回來把 gRPC 撿起來,向 RD 要 proto 檔,讓 Claude Code 帶你寫第一支。在那之前,知道 k6 測得了它、知道要跟誰要什麼,就夠了。
六、注意事項:跨出 HTTP 的六個習慣
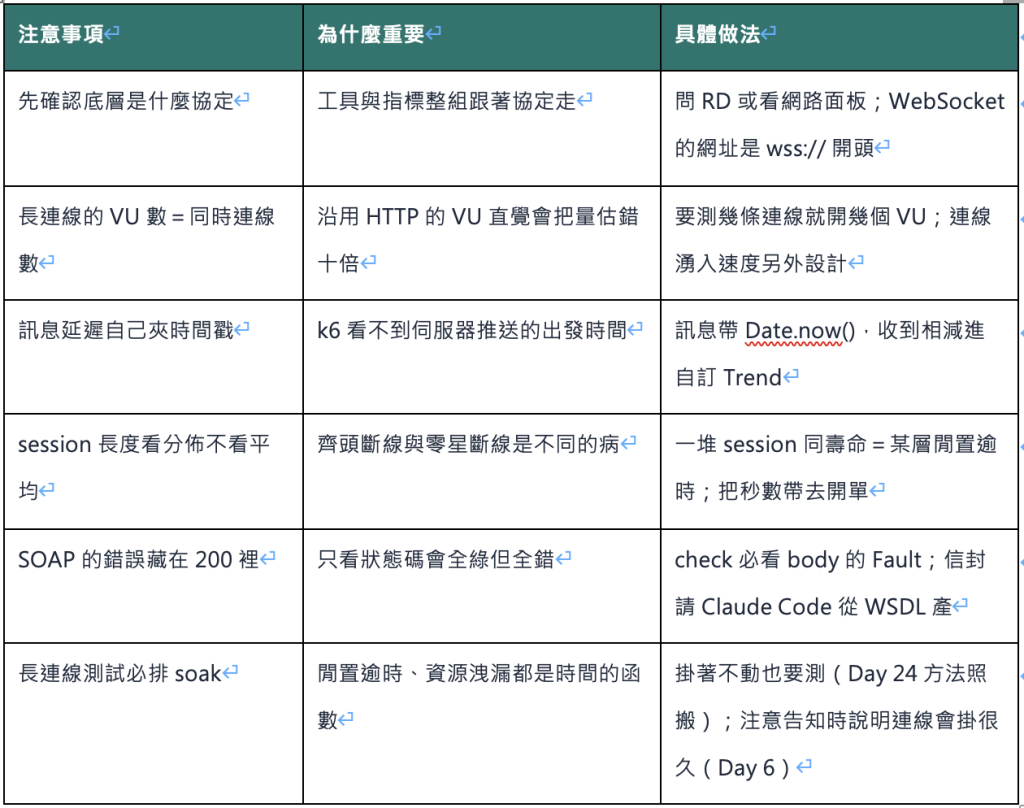
給 RD 的一句話:QA 拿著「session 大量集中在 60 秒左右結束」來找你時,那幾乎不是巧合——查一下 LB、反向代理、防火牆的 idle timeout,通常一小時內就能定位。SOAP 那邊他最需要的是 WSDL 或一段實際請求範例;gRPC 則是 proto 檔和一個碰得到服務的施壓位置。這三樣都是你舉手之勞、他自己生不出來的東西。
七、觀念驗證:三個問題確認你有帶走今天的重點
• HTTP 測試與長連線測試各自問什麼問題?VU 在兩種測試裡分別代表什麼?(第一、二節)
• 訊息延遲為什麼要自己夾時間戳?session 長度為什麼看分佈不看平均——齊頭的 60 秒暗示什麼?(第三節)
• 「k6 測 SOAP 就是 POST XML」這句話為什麼成立?SOAP 最容易讓報告全綠但全錯的坑是什麼?(第四節)
八、小結
跨出 HTTP,變的是世界觀,不變的是方法。WebSocket 把問題從「一次多久」換成「掛著多少、訊息多快、掛久了會不會被剪」——VU 變成連線本身,延遲要自己夾時間戳,齊頭的 session 壽命是最值錢的線索;SOAP 對 k6 而言就是 POST XML,台灣的金融保險政府環境用得再多也不用怕,只記得錯誤藏在 200 的 body 裡;gRPC 知道三件事就好——k6 支援、要 proto 檔、天生是協作題。而百分位、thresholds、負載模型、soak、開單——前面二十七天的每一課,換了協定一樣用。工具的部分到此全部走完。明天退一步看這三十天裡一直站在你旁邊的那位:Claude Code 到底能做什麼、不能做什麼——包括這一路上它錯過哪些、人是怎麼接住的——Day 29 見。


 iThome鐵人賽
 看影片追技術