
走過這麼多次的設計與迭代,PokeThreads 已經不是一個「單純」的系統了。
一個 GET /feed Request,背後可能經過:
API Gateway -> Rate Limiter -> Stateless Server -> Cache
    -> Sharded Database(也可能是 Search Index)-> Message Queue 的下游 Worker
當所有元件都正常運作時,一切都很美好。
但如果某天使用者 Pikachu 跳出來抱怨:「PokeThreads 的 Feed 怎麼變超慢?」
我們要怎麼知道問題出在哪裡:
在元件這麼多的系統裡,光憑猜測完全沒有效率,這正是 Observability(可觀測性) 要解決的問題。
Observability 通常會拆成三個互補的面向來討論,各自回答不同的問題。
Logging 是最直覺、大家最早開始用的工具,在程式關鍵的地方留下一筆筆帶時間戳記的紀錄,例如:
[10:03:21] INFO  Server-3  Received GET /feed for user=Pikachu
[10:03:21] ERROR Server-3  Database timeout on shard-7
Log 的好處是資訊很完整、很具體,出事的時候可以直接看到當下發生了什麼。
不過缺點也很明顯,只有一台 Server 時看 Log 很直覺,但現在 PokeThreads 有幾十台 Stateless Server、多個 Worker、多個 Database Shard,同一個使用者的一次 Request,Log 可能分散在完全不同的機器上,光是把相關的 Log 找齊、湊出完整的故事,就已經很費工。
Metrics 是把系統狀態轉換成隨時間變化的數字,通常拿來做成 Dashboard 觀察趨勢、設定告警閾值。常見的 Metrics 包括:
Metrics 很適合回答
但它天生是聚合過的數字,沒辦法告訴你「某次特定的 Request 到底發生了什麼事」。
Tracing 補上了 Logging 跟 Metrics 中間的空白:追蹤單一 Request 從進入系統到離開系統,究竟經過了哪些服務、每一段各花了多少時間。
做法是在 Request 一進到系統(通常是在 Gateway)時,就產生一個獨一無二的 Trace ID,接著讓這個 Trace ID 跟著 Request 一路傳遞下去,每個服務處理這個 Request 時都把自己這一段的耗時記錄下來(這一段通常稱為一個 Span),並且在自己的 Log 裡也帶上同一個 Trace ID:
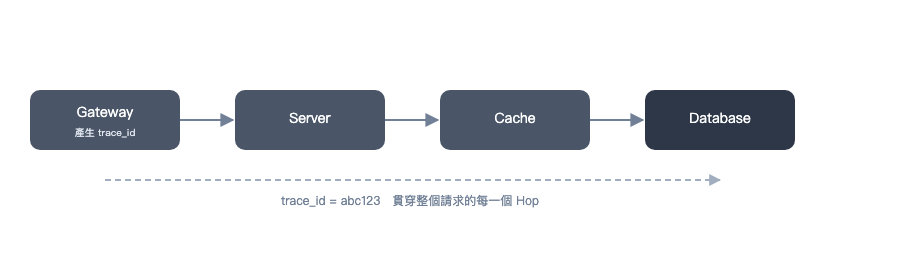
之後只要拿著這個 Trace ID,就能把 Gateway、Server、Cache、Database 在處理同一個 Request 時各自留下的紀錄全部串起來,清楚看到整段旅程裡,時間到底花在哪一段。
回到一開始的抱怨:「PokeThreads 的 Feed 怎麼變超慢?」
有了完整的 Observability,排查的過程大致會是:
1. 打開 Metrics Dashboard
   發現 GET /feed 的 p99 Latency 這一小時明顯飆高

2. 找幾筆 p99 附近的 Request,拉出它們的 Trace
   發現耗時幾乎都集中在「查詢 Database」這個 Span

3. 進一步看 Trace 細節
   發現這些變慢的 Request,Shard 都指向同一個 Replica

4. 到那台 Replica 上查 Log
   找到根因:磁碟 I/O 出現異常、或是這個 Replica 剛好在跑一個很吃資源的批次任務
因此這三者對整個系統是互補、缺一不可的。
剛才那個排查過程:看 Metrics -> 抓 Trace -> 翻 Log
本質上就是在做「關聯分析」,把三種格式、來源都不同的資料,串成一個因果故事。
這件事這幾年愈來愈常交給 AI 分擔,常見的應用方向:
這個領域現在有個統稱叫 AIOps,例如 Datadog 這類 Observability 平台這幾年都陸續加入了類似的 AI 輔助功能。
要注意的是,AI 在這裡扮演的是加速排查、縮小範圍的角色,它分析的原料就是 Logging、Metrics、Tracing 這三塊蒐集到的資料,若沒有紮實的 Observability 基礎建設,AI 也無米可炊。
值得一提的是,雖然現在才介紹 Observability,但它通常不是系統做到一定規模才「順便」加上去的東西,而是要盡早規劃:Trace ID 要在系統設計初期就決定好怎麼產生、怎麼在服務之間傳遞;哪些 Metrics 值得長期追蹤,也最好在元件剛上線時就一併定義,而不是等到出事之後才臨時想「早知道當初就該記錄這個數字」。
今天沒有替 PokeThreads 加上任何新的使用者功能,而是替整個系統裝上一雙眼睛。目前完整的架構長這樣:
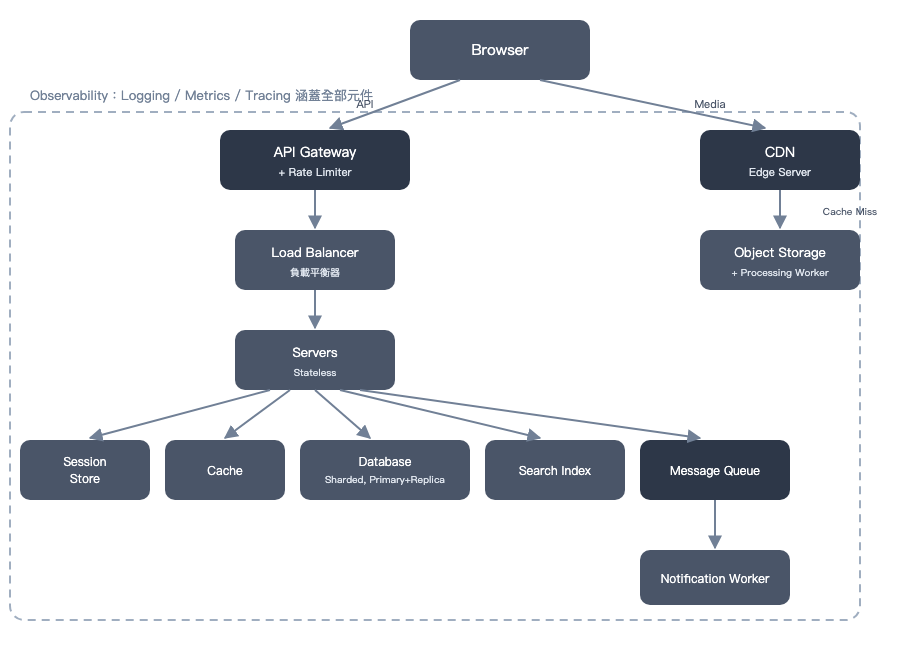
Observability 不是架構圖裡新增的一個方塊,而是像一層籠罩在所有元件之上的網,Logging、Metrics、Tracing 從 Gateway 一路貫穿到最下游的 Worker,才能在 Pikachu 抱怨「Feed 變慢」的時候,有能力回答「慢在哪裡」。
系統的元件越多,這雙眼睛就越重要。沒有 Observability,我們永遠只能用猜的方式除錯,而「猜測」從來不是可以長期依賴的除錯策略。


 iThome鐵人賽
 看影片追技術