
前面內容幾乎都在講後端,今天把視角切回前端。
回想 Day 3,我們的 Feed API GET /feed?cursor=abc123&limit=20,Server 每次回傳一批貼文,加上一個 next_cursor:
{
  "posts": [...],
  "next_cursor": "abc123"
}
這是後端的設計,但前端實際上要怎麼「用」這個 API,才能讓 Pikachu 滑 Feed 滑得順、不卡頓,還不會把記憶體吃光?今天就來討論這部分。
PokeThreads 的 Feed 給人的體驗是永遠有更多內容,使用者的操作也很單純:不斷往下滑。
前端要做的就是在使用者滑到底之前,把下一批資料準備好並接上去,讓這個過程感覺不到「分頁」的存在。
如果照 Day 3 的 Offset Pagination 邏輯,最原始的做法是在頁面下方放一個「下一頁」按鈕,使用者按了才載入下一批,像是 Blog 文章分頁一樣。
但這在 Feed 這種持續往下滑的場景裡很彆扭,所以幾乎所有社群平台都改用 Infinite Scroll(無限捲動):使用者滑到接近列表底部時,前端自動幫你打下一批 Request,不需要手動按任何東西,體驗非常流暢。
實作上常見的做法是在列表最後放一個看不見的「哨兵元素(Sentinel)」,用瀏覽器的 IntersectionObserver 盯著它有沒有進入畫面:
Feed 列表
├── Post 1
├── Post 2
├── ...
├── Post 20
└── Sentinel(哨兵,通常是空的 div)
一旦 Sentinel 進入畫面,就代表使用者快滑到底了,觸發:
GET /feed?cursor=abc123&limit=20
拿到新的一批貼文後接在列表後面,並把 Sentinel 移到新的列表尾端,如此反覆。
Day 3 討論 Offset 跟 Cursor Pagination 時,結論是 Feed 這種持續產生新內容的資料,比較適合 Cursor Pagination。
從前端的角度看,這個結論更明顯:
Infinite Scroll 本質上就是「不斷用上一批資料的 cursor,換下一批資料」。
如果後端用的是 Offset,使用者滑動時前面插入的新貼文,會讓後面每一批資料的 Offset 通通位移,重複或漏掉貼文的機率大幅增加。Cursor Pagination 沒有這個問題,因為它是「接在上次結尾繼續拿」,跟使用者滑動的方向天生契合。
Infinite Scroll 不是沒有缺點,跟傳統分頁比起來:
這些取捨在 Day 3 討論分頁方式時就已經埋下,Infinite Scroll 只是把 Cursor Pagination 的特性,直接體現成使用者看得到的互動方式。
Infinite Scroll 解決了「怎麼載入下一批」,但如果 Pikachu 是個滑手機停不下來的重度使用者,滑了半小時,列表裡可能已經塞了上千篇貼文。
即使畫面上同一時間只看得到 5~10 篇,瀏覽器的 DOM 裡卻真實存在著這一千多個 Post 元素,每一個都佔記憶體、每一個都要被瀏覽器排版(Layout)與繪製(Paint)納入計算。結果就是滑動開始變得卡頓,手機甚至可能因為記憶體吃緊而讓分頁閃退重載。
解法是 Virtualization:畫面上看得到的 Post 才真正渲染成 DOM 節點,看不到的(不管是已經滑過去的,還是還沒滑到的)就直接從 DOM 移除,只保留一個等高的空白佔位(Placeholder),確保捲動軸的高度計算還是正確的。
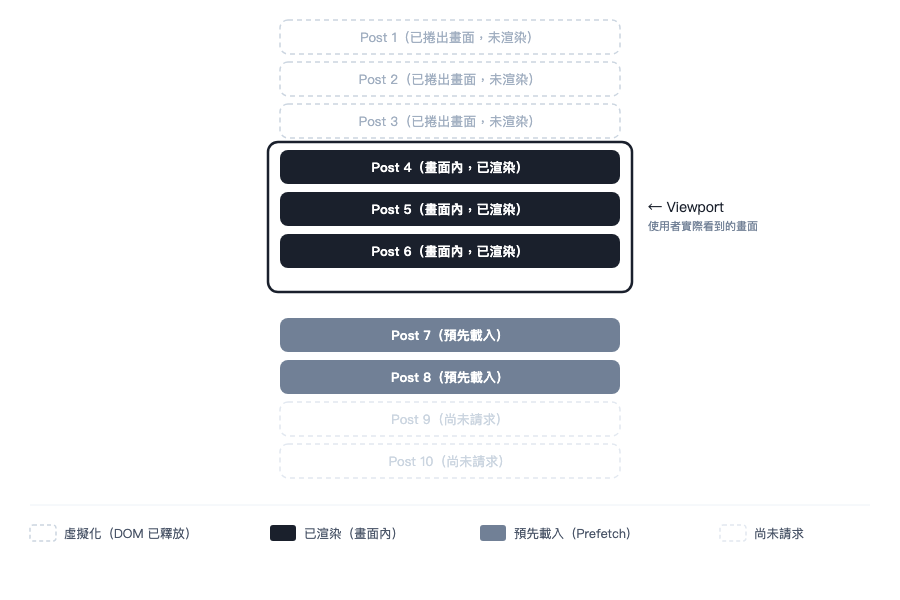
概念上就是一個會隨著捲動移動的「視窗(Viewport)」,只有落在視窗附近的內容才值得花資源渲染:
這正是 react-window、react-virtualized 這類函式庫在做的事,不需要知道特定框架的細節,反正核心概念都是 「只渲染看得到的東西,其餘的用佔位空間頂著」。
有了 Virtualization,不管 Pikachu 滑了 10 篇還是 10000 篇,DOM 裡實際存在的 Post 節點數量都能維持在一個固定的小範圍內,滑動效能不會隨著使用時間拉長而變差。
Infinite Scroll 加上 Virtualization 之後,還有一個體驗細節可以打磨:如果非要等使用者滑到 Sentinel 才發出 Request,中間網路來回的時間,使用者就會看到一個轉圈圈的 Loading 畫面,體感上就是「卡了一下」。
Prefetch(預先載入) 的做法是提早行動,在使用者實際滑到底之前,就先把下一批資料(甚至下一批貼文裡的圖片,讓 CDN 提前 Cache Warm)準備好,對應下圖裡灰色的 Post 7、8:
這兩篇貼文使用者根本還沒看到,但資料已經在前端手上待命,等使用者真的滑過去的那一刻,畫面幾乎是瞬間補上,感覺不到任何 Loading。
跟 Day 8、Day 9 討論的 Cache TTL 一樣,Prefetch 也不是越多越好:
實務上通常會抓一個平衡點,例如「畫面內容剩下最後 3~5 篇時就觸發下一批的 Prefetch」,而不是等 Sentinel 真的進入畫面才動作。
這裡也呼應了 Day 4 討論的 REST vs GraphQL:如果前端用的是 REST,一次 Request 通常會把整個 Post 物件的所有欄位都撈回來,即使畫面上暫時只需要作者名稱。
如果換成 GraphQL,Client 可以精準指定 Prefetch 階段只要哪些欄位(例如先只要文字與縮圖網址,圖片的完整解析度等真正捲到才補),用更小的流量換到一樣的體感效果。
API 設計方式的選擇,也會一路影響到前端效能優化的空間。
目前為止都在討論「讀」,關注在怎麼把 Feed 呈現得順暢,但使用者發文(POST /posts)的體驗,同樣值得拆開來看。
最單純的實作方式:使用者按下發布,前端顯示 Loading,等 POST /posts 真正回傳成功之後,才把新貼文插入畫面。
這個做法「正確」但體感很差,尤其網路不穩定時,使用者按下發布後要盯著一個轉圈圈的圖示好幾秒,這其實跟前面處理的是同一個問題的另一個面向。
實務上,社群平台幾乎都採用 Optimistic UI(樂觀更新):使用者一按下發布,前端立刻把這篇貼文塞進畫面最上方,看起來像是已經發布成功,但在這個當下,Request 可能都還沒送到 Server,後端也完全還沒把這筆資料寫進 Database。
也就是說畫面上這篇「看起來已發布」的貼文,其實只是前端 local state 裡的一份樂觀資料,跟 Day 8 討論 Cache 的邏輯有點像,先讓使用者看到一個「看起來是對的」結果,正確性留到之後才確認。
POST /posts 送出後,實際上有兩種結果:
id、created_at,前端把畫面上那份暫時的樂觀資料,換成 Server 回傳的正式版本,多數時候使用者根本不會注意到這個「掉包」的瞬間。如果 Request 送出後,因為網路狀況不好而逾時,前端沒辦法確定是「Server 根本沒收到」還是「Server 收到了,只是回應遺失了」,這時候如果自動重試,就可能造成同一篇貼文被建立兩次。
解法跟 Day 12 處理 Message Queue 重複訊息的邏輯是同一套:前端在使用者按下發布的當下,先產生一個獨一無二的 Idempotency Key(例如一組 UUID),跟著這次 Request 一起送出。即使因為重試同一篇貼文被送了兩次,後端只要對這個 Key 建立 Unique Constraint,就能確保最終只會產生一筆貼文,多餘的重試會被擋下來。
今天全部的討論,都建立在一個沒有明說的假設上:Feed 是照 created_at 由新到舊排序的,這也是這個系列從 Day 3 開始就一路採用的簡化模型。
但真正的社群平台,Feed 通常不是單純的時間序,實務上排在最前面的內容,往往是一個 Ranking Model 算出來「你最可能感興趣」的貼文,會綜合考慮過去的互動紀錄、跟發文者的關係、貼文本身的熱門程度等大量特徵,這本身是一個獨立的機器學習問題,複雜度超過本系列的範疇了。
這也是為什麼 Cursor 的設計要留有彈性:一旦排序不再是單純的時間序,Cursor 可能就不再只是「時間 + ID」,而是「這個 Ranking 結果裡的位置」。但今天討論的前端技巧,包括分批載入、Virtualization、Prefetch,概念上依然適用,差別只在於背後排出這個順序的邏輯,換成了 AI。
目前為止這個系列討論前端時,預設的都是 Browser,像是 fetch、IntersectionObserver 這些 API,都是瀏覽器的概念。
但這系列討論的 PokeThreads 如果同時要做 iOS / Android 原生 App,這些技巧還適用嗎?
好消息是,這次討論的三個核心概念,全部都能對應到原生開發,只是換一套實作方式:
| 瀏覽器 | iOS / Android |
|---|---|
IntersectionObserver |
自行判斷捲動位置(或系統提供的類似機制) |
| Virtualization | UICollectionView(iOS)/ RecyclerView(Android) |
| Prefetch | App 自己實作提前載入的邏輯 |
真正會不一樣的,其實只有前端怎麼呼叫 API 這一層——Browser 用 fetch / XMLHttpRequest,App 則是用各自平台的 HTTP Client(例如 iOS 的 URLSession、Android 的 OkHttp),程式語言、寫法都不同。
但只要之前設計好 REST API(單純的 HTTP + JSON),Browser 打的是 GET /feed?cursor=...,App 打的也是同一支 GET /feed?cursor=...,拿到的是同一份資料格式。
換句話說,API 這一層以下的所有元件——Load Balancer、API Gateway、Servers、Cache、Database、CDN——完全不需要為了「這是 Browser 還是 App 打來的」而做任何改動,這些元件本來就只認得 HTTP Request,不在乎背後是哪一種 Client。
今天把 Day 3 設計好的 Cursor Pagination API,串成一個使用者真正會用得順手的 Feed 體驗:
這三項技巧解決的都是同一個核心問題:
後端的資料是分批的,但使用者體驗要盡量讓它感覺是連續的。
除此之外,今天也把討論範圍拉大了兩個方向:確認了這些技巧不只限於 Browser,換一套實作方式在 App 上同樣適用,而 API 層以下的所有後端元件完全不需要因為 Client 平台而改動;另外也從「讀」延伸到「寫」,Create Post 靠 Optimistic UI 讓發文感覺是瞬間完成的,但也因此要處理樂觀資料失敗時的收回、以及重試造成的重複發文問題。
到目前為止,我們一直站在單一資料中心的角度討論架構,但如果 Pikachu 在亞洲,我們的 Server 卻全部蓋在美國呢?這是接下來要處理的問題。


 iThome鐵人賽
 看影片追技術