
在常見的工具呼叫模式中,任務往往是一問一答:使用者提出明確問題,模型呼叫一次工具取得資料,接著直接回答結束流程。如果任務需要的資料一開始就能確定,系統的控制流就是一條直線,寫成固定的工作流(Workflow)就能穩定運作。
但真實世界中的探索型任務——例如線上系統事故排查,往往只有模糊的初始症狀,無法在出發時就預先決定完整的執行步驟。
假設工程師收到一則事故通報:「10:00 起 checkout API 的 5xx 比例升高,顧客結帳時會在付款步驟逾時。」通報中只有症狀,沒有指出具體是哪一個下游依賴故障。在開始調查時,程式無法預先寫死排查步驟:
connection refused to redis-primary:6379,下一步就必須深入檢查 Redis 的健康狀態。database pool utilization 100%,下一步則應該改查資料庫連線池與慢查詢。第二步要查 Redis 還是 Database,完全取決於第一步工具執行的真實環境資料。在 Agent 架構中,將工具執行結果送回給模型感知的資訊稱為 Observation(觀察,在程式中即 ToolMessage)。
因為程式無法預知未來的 Observation,排查過程不能是一條直線走到底,而必須形成閉環:讓模型每執行一次工具,就停下來讀取環境回饋,再決定下一步。這種「執行動作 -> 觀察結果 -> 重新決策」的循環機制,就是 Agent Loop(自主決策迴圈):
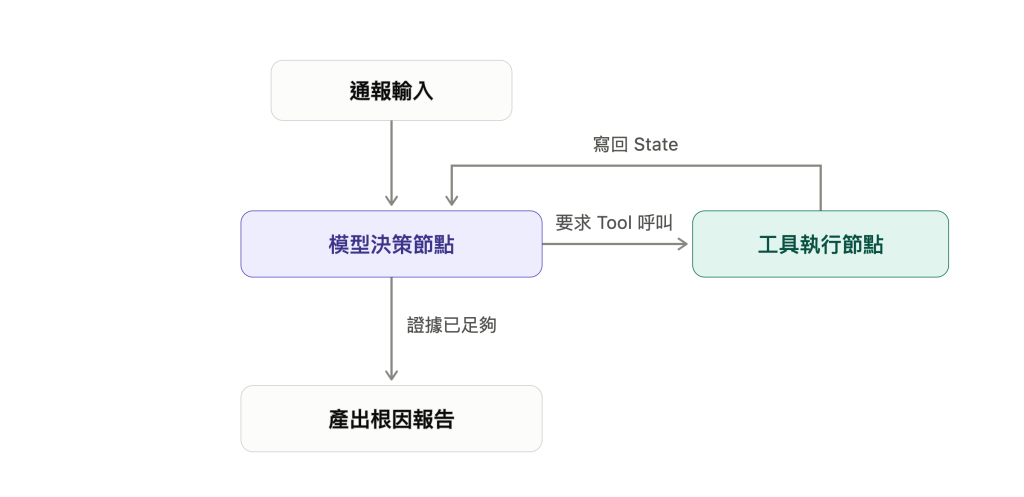
在 Agent Loop 中,排查路徑由模型與 LangGraph 分工推進:
ToolMessage 寫回 State,再將控制權交回給模型節點。只要模型持續要求呼叫工具,流程就會在模型與工具節點之間反覆循環;直到模型判定證據齊全、不再產生工具呼叫時,條件邊才會結束流程。
本篇對應的範例程式在 ai-agent-sample/langgraph/langgraph-incident-investigation。我們以「線上系統事故排查」為例,通報輸入固定為:
「10:00 起 checkout API 的 5xx 比例升高,顧客結帳時會在付款步驟逾時。」
範例在 tools.py 定義兩個唯讀查詢工具,使用內建資料模擬服務日誌與監控指標:
模型無法單靠通報判斷根因,必須先透過日誌取得線索,再依據 Observation 決定是否深入檢查特定服務,直到掌握充分證據才收斂出報告。
Agent Loop 需要清楚的系統提示詞規範其行為邊界。Prompt 確立分析目標與原則,要求模型根據真實證據推論,並在掌握充分因果後收斂報告:
SYSTEM_PROMPT = """你是負責排查系統線上事故的分析助理。

目前時間:2026-07-30T10:05:00+08:00

排查原則:
- 根據通報症狀追查故障根因,區分表面症狀與下游相依服務問題。
- 只能依據工具回傳的真實數據進行推論,不得假設未經證實的事實。
- 當從日誌發現可疑的相依服務時,應進一步驗證該服務的即時狀態。
- 掌握充分證據後停止呼叫工具,輸出結構化根因分析與處置建議。
- 不得要求執行部署、重啟、封鎖帳號、刪除資料或修改正式環境。
"""
Prompt 著重於原則性的指引(區分症狀與下游問題、發現可疑依賴時深入驗證),具體的工具參數與用法則留在工具本身的 Docstring 中。這讓模型在第一輪取得日誌線索後,能自主推導出下一步需要檢查相依服務的健康度。
在 tools.py 中,我們使用 @tool 裝飾器定義兩項查詢工具。模型只會讀取函式簽名、型別標註與 Docstring 來決定是否呼叫工具與如何填入參數,不會看到函式內部的實作細節:
from typing import Literal
from langchain_core.tools import tool

DependencyService = Literal["database", "redis"]
LogLevel = Literal["ERROR", "WARN", "INFO"]


@tool
def search_logs(level: LogLevel | None = None, minutes: int = 15) -> str:
    """搜尋時間窗內所有服務的日誌,不需要指定服務,用 trace_id 串接跨服務的紀錄。

    Args:
        level: 只回傳這個等級的日誌(ERROR、WARN 或 INFO)。不指定則回傳所有等級。
        minutes: 往回查詢的分鐘數(相對於目前時間)。
    """
    ...


@tool
def check_service_health(service: DependencyService) -> str:
    """查詢下游依賴目前的健康狀態,用來驗證日誌裡追到的服務是否真的異常。

    Args:
        service: 要查詢的下游依賴服務名稱。
    """
    ...
這兩個工具有兩項設計特點:
search_logs 允許跨服務探索:工具不需要指定服務名稱,模型只要根據通報時間帶入 level 或 minutes,就能一次取得時間窗內所有服務的日誌,從中找出帶有相同 trace_id 的關聯錯誤。check_service_health 限定依賴型別:service 參數使用 Literal["database", "redis"] 型別限制,模型在被日誌引導時,只能驗證這兩個下游相依服務,避免模型隨意填入不存在的服務名稱。定義好工具後,我們在 workflow.py 將模型與工具組裝成迴圈。
在 LangGraph 中,讓流程形成迴圈的核心在於兩個連線設定:一個條件分支決定是否需要呼叫工具,以及一條把工具結果送回模型的連線。只要模型持續發出 Tool Call,流程就會不斷把最新的 Observation 帶回模型手中,驅動下一輪決策:
# 1. 綁定排查工具清單至模型
tools = [search_logs, check_service_health]
model_with_tools = model.bind_tools(tools)


# 2. 模型決策節點:讀取累積的訊息歷史,決定下一步行動
def investigate(state: MessagesState):
    messages = [
        SystemMessage(content=SYSTEM_PROMPT),
        *state["messages"],
    ]
    response = model_with_tools.invoke(messages)
    return {"messages": [response]}


# 3. 建立 Graph 並註冊節點
builder = StateGraph(MessagesState)
builder.add_node("investigator_agent", investigate)
builder.add_node("tools", ToolNode(tools))

# 4. 設定流程連線
builder.add_edge(START, "investigator_agent")
# 條件分支:模型產生 Tool Call 則前往 tools;無 Tool Call 則前往 END
builder.add_conditional_edges("investigator_agent", tools_condition)
# 工具執行完畢後連回模型,帶入 Observation 進行下一輪決策
builder.add_edge("tools", "investigator_agent")

graph = builder.compile()
這段程式碼由三個部分組成:
*state["messages"] 展開完整歷史:每次進入 investigate 節點時,模型都能讀到最初的使用者輸入、前面幾輪模型提出的 Tool Call,以及工具回傳的 ToolMessage。tools_condition 路由分流:檢查最後一則 AIMessage 是否包含 tool_calls。有呼叫就導向 tools 節點;沒有呼叫就代表模型判定調查完成,導向 END。builder.add_edge("tools", "investigator_agent") 連回模型:ToolNode 執行完工具並產出 ToolMessage 後,藉由這條連線再次觸發 investigate,把 Observation 送回模型手中驅動下一輪決策。初始輸入為事故通報:
「10:00 起 checkout API 的 5xx 比例升高,顧客結帳時會在付款步驟逾時。」
接下來看模型如何在一輪又一輪的動作與 Observation 推進下收斂出根因。
通報中只有「結帳逾時」的表面症狀,模型決定先查詢跨服務日誌以尋找錯誤線索:
search_logs(level="ERROR", minutes=15)
[
  {
    "timestamp": "2026-07-30T10:03:06+08:00",
    "level": "ERROR",
    "message": "connection refused to redis-primary:6379; client fallback triggered",
    "trace_id": "trace-checkout-7f3a"
  },
  {
    "timestamp": "2026-07-30T10:03:08+08:00",
    "level": "ERROR",
    "message": "redis GET session-cache miss on checkout:session:7f3a timed out after 200 ms",
    "trace_id": "trace-checkout-7f3a"
  },
  {
    "timestamp": "2026-07-30T10:03:12+08:00",
    "level": "ERROR",
    "message": "payment request timed out after 5000 ms",
    "trace_id": "trace-checkout-7f3a"
  }
]
模型讀取第一筆 Observation。雖然表面症狀是付款逾時(10:03:12),但同一筆請求早在 10:03:06 就出現了 connection refused to redis-primary:6379。為了確認 Redis 是短暫網路抖動還是服務徹底斷線,模型發起第二個查詢:
check_service_health(service="redis")
{
  "service": "redis",
  "status": "down",
  "signals": {
    "connection_errors": {"value": 512, "baseline": 3},
    "timeout_percent": {"value": 100, "baseline": 0}
  },
  "detail": "所有連線嘗試皆失敗,redis-primary 目前完全無法連線,判定為 down。"
}
此時日誌與健康度證據互相印證,形成完整的因果鏈條(Redis 當機 -> 快取讀取逾時 -> 結帳逾時)。模型判定證據充足,不再呼叫工具,直接輸出結構化根因報告:
根因分析:
1. 10:03:06 起 checkout 服務嘗試連線 redis-primary:6379 失敗。
2. 健康度檢查確認 redis 服務狀態為 down,連線錯誤數達 512 次(基準值為 3)。
3. 顧客結帳時因 session cache 讀取逾時(200 ms)與付款請求等待逾時(5000 ms)而中斷。

處置建議:
優先重啟或切換 redis-primary 節點至備援實例,並檢查 session cache 連線池設定。
模型沒有發出工具請求,tools_condition 路由至 END,整個 Agent Loop 結束。
這篇我們建立了最純粹的自主決策迴圈:由模型根據 Observation 自主決定是否繼續查詢。然而,預設的 tools_condition 將終止決策完全交由模型掌控,在正式環境中存在明顯風險:
tools_condition 每輪都判定有 Tool Call,導致流程持續循環,直到觸發 LangGraph 的 recursion limit 拋錯崩潰。tools_condition 判定無 Tool Call 即導向 END,導致系統接受了未經健康度驗證的草率結論。要解決這三類問題,不能單靠調整 Prompt,必須在 State 中記錄工具呼叫計數與任務狀態,將工具失敗轉成可自我修正的結構化 Observation,並改用自訂 Router 與結果驗證節點進行剛性控制。
下一篇,我們會接著這個事故調查流程,在 State 記錄工具呼叫次數,執行前檢查是否超過,並在模型停手後確認日誌與健康度結果是否都已取得。


 iThome鐵人賽
 看影片追技術