

整個系列只有這一段有量測:43 次執行,一次通過 36/37,平均 10.9 分鐘。這篇把數字攤開,也講它們證明不了的四件事。
工廠的指標檔開頭寫著:
每次執行後追加一列。指標決定工廠是否健康、何時可擴張。
記的是三件事:
| 指標 | 意義 | 為什麼要看 |
|---|---|---|
| 耗時 | 從觸發到報告產出 | 拿去跟人工比較的基準 |
| 一次通過率 | 首輪即全綠的比例 | 最核心的指標 |
| 人工修正量 | 產出之後,人還改了多少 | 品質的真實反映 |
三個裡面,人工修正量最難作假。一次通過率可能很好看,因為 AI 會自己修到綠燈;但如果人拿到之後還要改兩百行,代表驗證抓不到真正的問題,驗證的形狀有洞。
| 項目 | 數字 | 出處 |
|---|---|---|
| 執行次數 | 43 次 | 指標檔 |
| 一次通過率 | 36 / 37 | 指標檔;分母怎麼算沒寫(見下) |
| 平均耗時 | 10.9 分鐘 | 指標檔沒算平均,是我拿 38 列能解析的耗時算的;另 5 列是 — 或多份合跑 |
| 耗時區間 | 1.5 ~ 40 分 | 指標檔 |
| 人工修正量 | 42 / 43 次是 0 | 指標檔 |
| 測試成長 | 101 → 350 條全綠 | 指標檔 |
分母是 37 不是 43,因為前面幾筆被排除了:
最容易灌水的地方就在分母。只要把「人工打造的那兩筆」也算進去,數字馬上變 38/39。沒有這麼做,這個數字才可以信。
但這個分母有一筆對不起來:照上面的備註扣,我數到 36,指標檔寫 37,多的那一筆沒有交代。這一篇在講分母的誠實,它自己的分母就差了一筆,所以表格照抄指標檔的 36/37,不自行改成 36/36。
register-employee v3(眷屬改為子實體)
~8 min | ❌(1 輪修正)| 人工修正 0
備註:整數口數改為物件清單;批次替換漏 1 處編譯錯誤,
      1 輪修復後 103 條測試全綠
一個資料結構從「數字」改成「物件清單」,要批次替換很多處,漏了一處,修一輪就全綠。
比失敗本身更重要的是,這一列有被記下來。一份只有成功紀錄的指標檔是可疑的;有這一列,另外 36 列才可信。
43 列裡有三筆備註,記的是 AI 犯錯之後自己抓到:
AI 產碼瑕疵 1 處(斷言混入無意義的三元式),於測試前的自我審查修正
AI 自我攔截 switch 分類錯誤 1 處
AI 自我攔截 2 處筆誤
這三筆證明審查層有作用。如果沒有那道自我審查,那個「斷言混入無意義三元式」會直接進到測試裡。而它會通過。一個永遠為真的斷言不會讓測試變紅,它只會讓覆蓋率數字變好看,然後守不住任何東西。
Day 22 說過 L3 審查是機率性的,這三筆是它真的抓到東西的實例:它抓到的東西,L1 和 L2 都抓不到。
這三筆的一次通過率仍然標 ✅,因為自我審查是流程的一部分,不是人工介入。
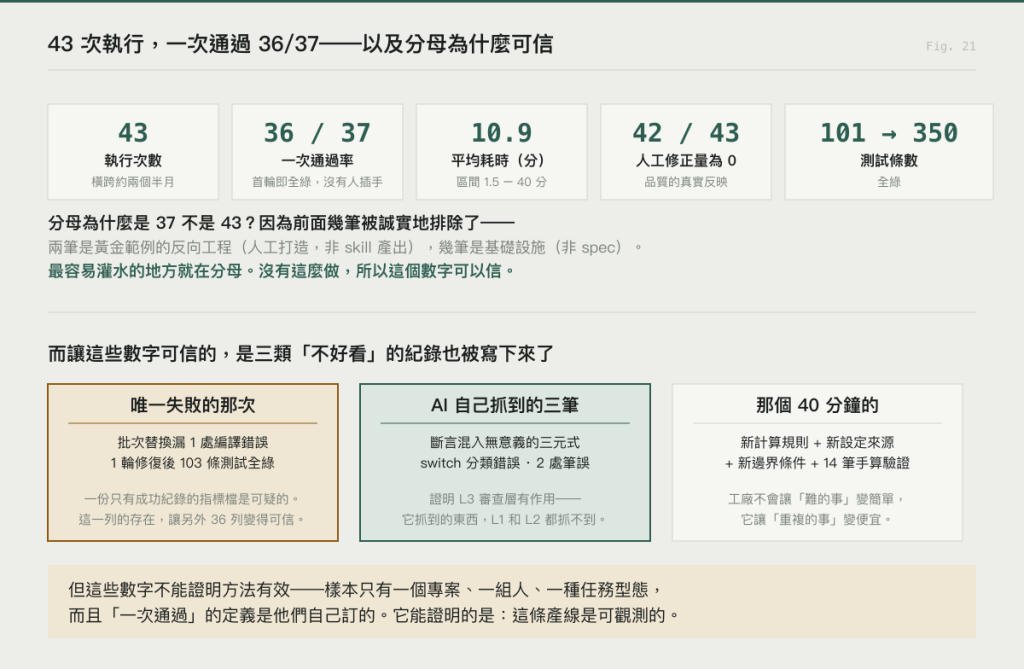
平均 10.9 分鐘,區間 1.5 到 40 分鐘。
短的那些是同型規則。已經有兩三條類似的規則做過了,第四條就是 1.5 分鐘。這就是工廠的價值:邊際成本遞減。長的那些是新形狀:第一個牽涉外部檔案讀寫的、第一個牽涉真實加密的、第一個組合多個流程的。
最長的 40 分鐘那筆,一次處理了新的計算規則、新的設定來源、新的邊界條件,還做了十四筆手算驗證。工廠不會讓「難的事」變簡單,它讓「重複的事」變便宜。
如果你的專案裡每個功能都是新形狀,那 10.9 分鐘的平均值不會出現在你身上。這也呼應 Day 20 那條入場條件:沒有重複,就沒有工廠。
一、它不能證明這套方法「普遍有效」。
這是一個系統、一種任務類型、一個人。43 次執行是不錯的樣本,但它證明的是「在這個條件下這樣做會成立」。
「這個條件」還要加一項(Day 01 提過):工具是 Claude Code,模型是各次執行當下的預設模型。這 43 次橫跨約兩個半月,期間預設模型改過版,而我沒有逐次記錄。
所以這批數字是一段期間的觀察,不是一次可複現的實驗。同一套流程換個模型跑,一次通過率會是多少,這裡答不了。
二、它不能證明產出的程式碼「好」。
一次通過率量的是「有沒有通過我自己定義的檢查」。如果檢查設計得鬆,通過率就會虛高。檢查沒有鬆掉的旁證是:這個系統跑的是真實的薪水,每個月二十幾個人的錢,算錯會有人來問。
但這個旁證只存在於這個案子。換一個沒有真實使用者的系統,同樣的指標可能什麼都不代表。
三、它不能證明「AI 寫得比人好」。
沒有做過對照組,也就是「同樣的功能人工寫一遍,比較品質和時間」的實驗。
所以那個 10.9 分鐘只能跟「我印象中人工要多久」比,而印象是不可靠的。
四、350 條測試全綠,不代表沒有 bug。
它代表「我想到要測的東西都測了」。我沒想到的部分,測試不會告訴我。
即使有這四條限制,有量測還是比沒量測好。理由不在數字本身,而是量測這個動作會逼出三件事:
一、逼你定義「完成」。 你要填「一次通過」,就得先定義什麼叫一次通過。而那個定義本身就是一種紀律。
二、逼你記下失敗。 一份指標檔如果只記成功,填的人自己會不好意思。那個 ❌ 之所以會被記下來,是因為表格裡有那一欄。
三、讓「感覺變好了」變成可以檢驗的話。 沒有數字的時候,「導入 AI 之後效率提升」是一句信仰。有數字之後,它至少是一個可以被質疑的宣稱。
要開始量,從最小的版本開始:一個 markdown 表格,四個欄位。
| 日期 | 做了什麼 | 一次過嗎 | 人工改了多少 |
不要一開始就設計儀表板。那個薪資工廠的指標檔就是一個 markdown 表格,四十三列,手動追加。
它之所以有價值,不是因為工具好,是因為它每次都被填。


 iThome鐵人賽
 看影片追技術