

Day 9 把 Shared Skill 的版本、release 與 consumer adoption 拆開之後,流程變得比以前可靠。
但也更容易出現另一種問題。
如果每次 Agent 開工,都完整跑一遍:
讀規則
→ 掃 Repository
→ 重建 Context
→ 檢查 working tree
→ 判斷風險
→ 比對版本
→ 重新確認 Plan
→ 決定 verification
→ 才開始做事
安全感會提高。
成本也會一起提高。
尤其當任務只是已知範圍內的一個 governance-only 修改,前一輪已經把架構、scope 與風險釐清,下一輪卻又從頭重新分析一次,原本用來降低風險的流程就開始變成固定稅。
這也是我後來把 Preflight 拆成不同深度的原因。
但做了一段時間後,我發現問題不只是:
FULL 還是 FAST?
更前面還有一個需要先回答的問題:
這一步到底需要 Agent 判斷,還是應該直接固定成 deterministic Workflow?
如果這個邊界沒有拆清楚,FULL / FAST 很容易只剩「檢查多一點」和「檢查少一點」。
更值得處理的是:
不要讓 Agent 每一輪都重新思考那些已經可以被程式精確執行的事情。
Day 3–7 先把規則、Project State、Decisions、Handoff 與 Durable State 留進 Repository;Day 8–9 再把重複能力抽成 Skill,並補上 Shared Skill 的版本與 rollout 邊界。
這些改動都在降低「每個 Session 從零重建工作環境」的成本。
但 Context 與共用能力穩定後,另一種浪費反而更清楚:Agent 仍可能每一輪重新執行、重新判斷同一套固定步驟。
問題開始從「它知不知道前面發生什麼」,往下一層移動:
哪些事情根本不值得再讓模型思考一次?
Day 10 處理的是這個 Workflow 邊界:保留需要語意判斷的地方,把可以重複、可以驗證、答案不該漂移的步驟固定下來。
早期做法很直覺。
只要在 Prompt 或規則裡告訴 Codex:
修改前先確認 repo
先看 git status
先讀 AGENTS.md
確認沒有 collision
檢查 Skill version
確認 scope
判斷這次要跑哪些 verification
Agent 就會照著做。
這比完全不檢查好很多。
但它有一個隱性成本:
同一個 deterministic 問題,每一輪都在消耗模型推理。
例如:
HEAD 是什麼?
manifest 裡宣告哪一版 Skill?
snapshot 的 metadata.version 是否一致?
路徑有沒有越出 Repository?
working tree 有哪些 changed files?
release tag 是否已存在?
這些問題都有明確答案。
它們不需要創造性。
也不需要 Agent 幫我「理解一下」。
如果每次都讓模型重新讀、重新比、重新描述,會付出:
而且還有一個更麻煩的問題。
同一套檢查由 Agent 自己每次重新執行,細節可能會漂。
今天先看 git status,明天可能先讀 Skill;這次記得檢查 tag,下一次可能漏掉;某次把「有 dirty files」直接判成危險,另一次又覺得可以繼續。
這讓「安全流程」本身也開始不穩定。
後來 Shared Skill governance 的實作開始出現一個很明顯的分界。
例如 preflight evidence tool 會收集:
canonical / consumer repository root
HEAD
current paths
expected paths
changed-file ledger
profile / depth
risk flags
它輸出固定 schema 的 JSON。
另一個 bounded lifecycle runner,則可以在一個已經被分類為低風險的 GOVERNANCE_ONLY / FAST 任務裡,依固定順序處理:
preflight
→ canonical verification
→ release resolution
→ canonical commit
→ immutable local tag
→ consumer sync
→ post-sync verification
→ consumer commit
而且它刻意不做幾件事:
不自己判斷風險
不自己決定 FAST 是否適用
不替 consumer enhancement 做 semantic classification
不 push
不 deploy
這個切分留下了一個很實用的界線:
有些事情適合自動做,但不適合自動決定要不要做。
Anthropic 在《Building Effective Agents》裡把兩者分得很清楚:
這個分類很適合拿來看這套 Preflight。
因為很多步驟可以直接放進 Workflow。
例如:
| 問題 | 比較適合 |
|---|---|
| manifest schema 是否合法? | Deterministic Workflow |
| Skill version 是否完全一致? | Deterministic Workflow |
| path 是否在 Repository 內? | Deterministic Workflow |
| Git HEAD 是否和 evidence 一致? | Deterministic Workflow |
| tag 是否已存在且 immutable? | Deterministic Workflow |
| changed files 是否包含 runtime code? | Workflow 先分類,必要時 Agent 判斷 |
| 既有修改是不是和本次需求衝突? | Agent decision |
| 這個需求是否真的需要新增一套 trust workflow? | Agent decision |
| consumer 的差異是 local drift,還是值得 upstream? | Agent decision |
兩者的差異不在「簡單/困難」。
而在:
這個問題有沒有一個可以被明確編碼、重複執行、產出一致 Evidence 的答案。
如果有,優先固定。
如果沒有,才把判斷留給 Agent。
這是我後來對 FAST Preflight 最大的修正。
一開始很容易把它理解成:
FULL
→ 很完整

FAST
→ 跳過一些東西
但如果只是刪檢查,FAST 很快就會變成「比較不安全的模式」。
更接近實作的邏輯是:
FAST 不是省略必要安全檢查,而是只在前置條件已經足夠明確時,縮掉不需要重新探索的部分。
例如 verification contract 裡,FAST 只允許在一組條件全部成立時使用:
Repository root / manifest / paths 已完整確認
沒有 target collision
沒有 unrelated / unowned change
scope 完整屬於 GOVERNANCE_ONLY
沒有 runtime-impact evidence
沒有 high-risk signal
release / tag / repo boundary 正常
deterministic tools 可用
capability probe 沒有 required UNKNOWN
先前 verification 沒有 unresolved mismatch
任何一個 gate 失敗,都不能因為「想快一點」硬留在 FAST。
它必須升級。
所以 FAST 真正省掉的是:
它省的是重複推理,不是必要 Evidence。
在我的上層工作流裡,FULL 比較像:
當任務還沒有被充分分類時,重新建立足夠的 Context、Scope 與 Risk 判斷。
例如:
新的 architecture change
未知或 mixed scope
碰到 runtime behavior
既有變更是否衝突還不確定
出現 auth / identity / migration / data-integrity signal
前一輪留下 unresolved mismatch
這些情況的問題不是「要多跑幾個 command」。
而是 Agent 還必須先回答:
這次到底在改什麼?
哪些行為真的屬於需求?
哪些變化只是順手擴張?
哪些 Evidence 才足夠?
是否應該停下或升級處理?
也就是說,FULL 的成本主要花在重新理解與重新分類。
這正是 Agent 有價值的地方。
而一旦判斷完成,其中能固定的步驟就應該重新落回 Workflow。
這變成一個很實用的檢查方式。
每當 Preflight 又想增加一條規則,我會先問:
1. 這一步有唯一或有限個可驗證答案嗎?

2. 輸入是否可以結構化?

3. 失敗條件能不能明確定義?

4. 結果能不能留下 machine-readable Evidence?

5. 同樣輸入重跑一次,理論上應不應該得到同樣結果?
如果大多數答案都是「可以」,
那它很可能不應該繼續放在 Agent 的自由推理裡。
例如:
版本一致性
路徑安全
Git HEAD
tag identity
manifest validation
changed-file ledger
這些都很適合 deterministic。
反過來,下面這類就比較難完全拿掉模型:
這個需求的 minimum product intent 是什麼?
某個額外 workflow 是 correctness requirement,還是 scope drift?
一份 pre-existing change 是使用者正在做的工作,還是不完整狀態?
一段 consumer-specific 規則是否值得泛化 upstream?
因為這些問題需要語意。
而且答案會依任務意圖改變。
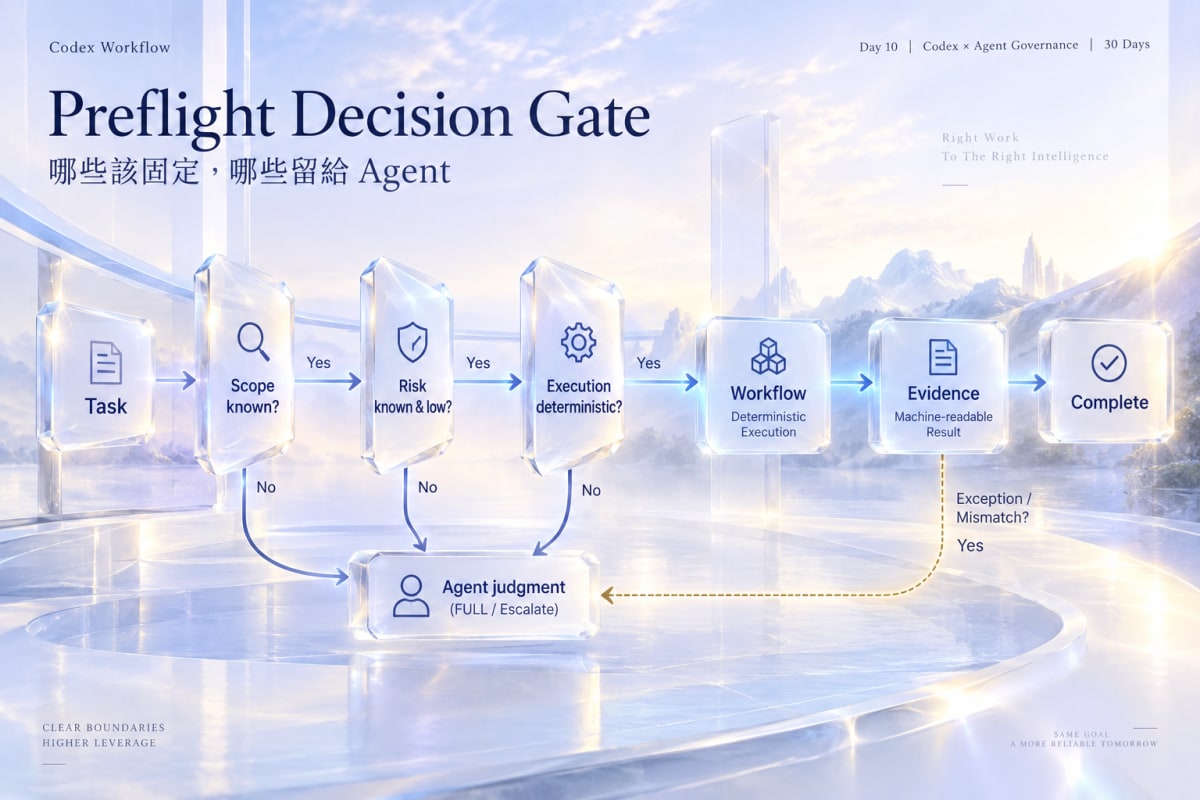
要決定走 FAST 還是進入更完整的 Preflight,可以先把問題壓成三層。
已知、單一、可列出 affected paths
→ 繼續

未知、mixed、需要重新探索
→ FULL / escalation
governance-only
沒有 runtime impact
沒有 high-risk signal
→ 可以評估 FAST

auth / identity / migration / data / irreversible
→ 不可 FAST
manifest / Git / version / path / sync / tag
→ Workflow

scope intent / collision semantics / complexity approval
→ Agent decision
最後的結果比較像:
Known scope
+ Known low risk
+ Deterministic execution path
= FAST candidate
而不是:
任務看起來很小
= FAST
「看起來很小」不是 Evidence。
以前 Agent 很容易出現這種行為。
一個 deterministic runner 已經完成:
canonical commit
tag
consumer sync
post-sync verify
consumer commit
並輸出完整 machine-readable summary。
Agent 接著為了「確認」,又跑:
git status
git rev-parse HEAD
git show tag
compare blobs
verify consumer
結果只是把 runner 已經證明過的事情再證明一次。
這看起來保守。
只是把:
已有 Evidence
錯當成:
還需要更多 Evidence
verification contract 因此明確加入一條:
runner 若以一致的
COMPLETEsummary 結束,就直接 consume summary;除非 summary 不完整、矛盾或 runner failure,否則不要重跑 deterministic checks。
它背後的判斷是:Verification 不是越多越安全;重複驗證同一個已被 deterministic 證明的事實,只是在增加 orchestration cost。
不過把步驟 deterministic 化,也不是一路加 script 就對。
因為 Workflow 本身也有成本。
每多一個 runner、schema、profile 或 classification,就會多出:
所以我不會因為「這件事可以寫 script」就一定寫。
比較值得固定的通常是:
高頻
+
重複
+
有明確輸入輸出
+
出錯有實際成本
+
結果需要被查證
如果只是半年做一次、每次情境都不同、Agent 幾十秒就能處理完的事情,硬做成 Workflow 可能只是把彈性換成 maintenance debt。
這一點和 Day 8 抽 Skill 時很像。
差別是 Day 8 問:
這個能力值不值得重用?
Day 10 問:
這個能力裡,有多少步驟不應該每次都交給模型重新決定?
以前談 Agent autonomy,很容易想成:
給 Agent 更多權限
→ 它可以自己做更多事
可以把它拆成:
Decision autonomy
+
Execution automation
兩者不必一起提高。
有些地方可以:
低 decision autonomy
高 execution automation
例如:
版本比對
tag 檢查
snapshot sync
manifest validation
這些最好不要讓 Agent自由發揮,卻非常適合自動執行。
另一些地方則是:
高 decision autonomy
低 automatic mutation
例如:
判斷 scope 是否漂移
判斷複雜度是否超過需求
判斷既有變更是否構成 collision
Agent 可以協助分析。
但分析完不代表自動取得更多 mutation authority。
這兩個維度一拆開,Workflow 設計就清楚很多。
FULL 與 FAST 都只是結果。
前面更重要的是:
先把可預測的步驟固定,再把需要語意與風險判斷的部分留給 Agent。
對這套 Codex Workflow 來說,比較合理的順序是:
先分類 task
↓
Agent 處理 ambiguity / scope / risk
↓
能 deterministic 的部分交給 Workflow
↓
Workflow 產出 Evidence
↓
Agent 只處理 exception / escalation
而不是:
Agent
→ 每次重新思考全部事情
這讓 FULL / FAST 不再只是速度選項。
它開始變成一個更清楚的治理問題:
哪些事情值得花模型判斷成本,哪些事情應該被固定到不能漂移?
當這條線畫出來之後,下一個麻煩也會很自然地出現。
如果前一輪已經把 scope、architecture 與 execution plan 核准了,下一個 Session 還要不要重新把它們打開?
有些時候需要。
但有些時候,重新設計本身就是新的風險。


 iThome鐵人賽
 看影片追技術