
上一篇我們比較了不同模型的 representations。即使兩個模型的 activation 維度不同、座標不同,我們仍然可以比較它們如何組織相同的輸入,或學習一個簡單的 mapping,把一邊的表徵轉換成另一邊的表徵。但如果另一邊不再是語言模型,而是人腦呢?想像一個人正在聽故事,我們把故事的逐字稿輸入語言模型。一邊記錄人腦的反應,另一邊取出模型的 activations。接著問:
只看模型讀到這段話時的 activation,我們能不能預測這個人的腦部反應?
如果可以,那就很有意思了。這個語言模型沒有接受過腦訊號訓練,也不是照著人腦的接線方式打造的,卻可能形成某些能用來預測人類語言處理的表徵。當然,「可以預測」還不等於「用同一種方式思考」。但它讓我們有機會把原本很模糊的問題——「語言模型和人腦到底像不像?」——變成可以實際測量、比較,也可以被反駁的研究問題。這就是今天要介紹的 Brain–LLM Alignment。這裡的 alignment 指的是模型表徵與腦部反應之間的對應,不是讓模型遵守人類偏好的 alignment。
在模型這一邊,我們可以直接讀取某一層、某個 token 位置的 activation。但在人腦這一邊,事情沒有這麼直接。例如,fMRI 測量的是與神經活動相關的血氧變化,通常稱為 BOLD signal。資料中的一個 voxel,可以想成腦部影像裡的一小塊三維空間;它不是一個生物神經元,也不是某個概念的專屬位置。因此,我們不是在做這種配對:
模型的 Neuron #315 = 人腦的 Voxel #315
我們比較的是:面對相同的語言內容,模型的表徵和實際量到的腦訊號之間,有沒有穩定的關係?其他研究也會使用 MEG,量測神經活動產生的磁場;或使用臨床情境下取得的顱內電極紀錄。不同工具能看見的空間尺度、時間尺度都不同,因此「和人腦對齊」的結果,必須連同測量方式一起理解。今天先用 fMRI 說明最基本的實驗。
先從單一 voxel 想起。假設受試者讀了許多句子,我們已經估計出這個 voxel 對每一句話的反應。同時,也讓語言模型讀取相同的句子,為每句話抽取一個固定方式取得的表徵,例如最後一個非 padding token 的 activation。現在,我們有一組配對資料:
句子 1 的 model activation → 句子 1 的 voxel response
句子 2 的 model activation → 句子 2 的 voxel response
句子 3 的 model activation → 句子 3 的 voxel response
...
接著訓練一個簡單的線性模型:
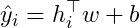
其中,h_i 是第 i 句話的 model activation,y_i 是這個 voxel 的實際反應;w 和 b 則是需要學習的參數。這個線性模型正在問:要怎麼組合 activation 裡的數值,才能預測這個 voxel 面對不同句子時,反應會比較高還是比較低?
對每個 voxel 都做同樣的事情,就能把它寫成:
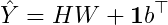
H 的每一列是一個刺激的模型表徵,Y 的每一列則是同一個刺激引發的多個 voxel responses。這種用刺激的特徵來預測腦部反應的方法,叫做 neural encoding model。這裡使用 LLM activations 作為特徵,並且通常會使用 Ridge Regression,限制線性模型的權重,降低高維資料過度擬合的風險。[2][3] 注意,語言模型本身保持 frozen。我們訓練的是 activation 到腦訊號的 mapping。這和 Day 4 的 Linear Probe 有一個熟悉的共同點:我們都把 frozen model 的 activation 當成資料,再訓練一個簡單的讀取工具。不同的是,當時預測的是 Positive/Negative label;今天預測的是另一個系統實際量到的反應。
只在訓練資料上預測得準,沒有太大說服力。我們真正想知道的是:當受試者接收一段沒有拿來訓練 mapping 的內容時,這個 mapping 還能不能預測腦訊號?例如,對某個 voxel,我們可以計算:
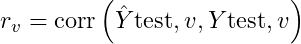
也就是在測試資料中,比較這個 voxel 的預測值與實測值是否一起變動。再對不同 voxels、腦區與受試者整理結果。這裡的 correlation 不是「模型理解了多少比例的人腦」。例如,(r=0.4) 不能直接讀成「解釋了 40% 的大腦」。它是特定資料、測量方式與評估設定下的預測指標。如果比較不同 layers,我們就可以問:模型哪一層的表徵,最能預測這個腦區的反應?如果比較不同模型,則可以問:哪一種模型表徵,在同樣的資料與評估方式下,提供了更多可用的預測資訊?這樣的結果比「兩個系統看起來很像」具體得多,但它首先支持的仍然是預測關係。
前面的句子例子,假設我們已經取得每句話對應的腦部反應。但自然故事實驗通常是一段連續的時間序列。這時不能直接把「第 100 個 token」和「第 100 筆 fMRI 紀錄」配在一起。首先,一個 word 可能被 tokenizer 拆成多個 tokens,需要決定怎麼整理成 word-level representation。接著,要知道每個 word 在故事的什麼時間被說出來。更重要的是,fMRI 的血氧反應不是聽到一個字就立刻出現,而是會延遲、延續一段時間。因此,研究者還需要建立從文字時間到腦訊號時間的對應。例如,用血氧反應函數處理 word-level features,或加入不同時間延遲的 features,再對齊 fMRI 的取樣時間。直覺上,一筆腦訊號要對應的,可能是前幾秒接收到的語言內容,而不只是當下正在出現的那個字。這也意味著:encoding score 不只取決於模型好不好,還取決於我們有沒有把兩邊的資料正確配對。
上一篇介紹的 RSA,在這裡也能使用。[1] 假設我們有一組相同的句子。在模型這邊,計算每兩句話的 activation 距離;在人腦這邊,計算每兩句話引發的腦部反應 pattern 之間的距離。接著比較兩邊距離矩陣中,相同句子配對的數值。通常取不含對角線的上三角,避免重複計算。例如,兩個系統是否都把某兩句話放得比較接近、把另外兩句話分得比較遠?這裡不需要指定哪個 artificial neuron 對應哪個 voxel,也不需要把腦部反應轉成模型的維度。但它和 encoding model 回答的是不同問題:
前者不保證原始 geometry 相同;後者也不保證兩邊使用相同的計算步驟。
有,而且不只一項研究。Schrimpf 等人在 2021 年比較多種模型,發現在他們測試的模型與資料中,next-word prediction 表現較好的模型,往往也較能預測語言相關腦訊號。[2] Caucheteux 與 King 在 2022 年比較模型表徵與 fMRI、MEG 紀錄,則發現模型的中間層,往往比輸入層或輸出層更能預測腦部反應。[3] 這個結果值得停一下:最接近模型最終答案的表徵,不一定最適合拿來描述人腦處理語言時的反應。
Goldstein 等人的研究則把問題推向處理過程:人在聽自然故事時,是否和語言模型一樣,利用 context 預測接下來的詞,並對不符合預期的詞產生不同反應?他們的行為與顱內紀錄提供了支持這些共同處理原則的證據。[4]
後續工作也研究了模型的層級結構,與人腦語言處理時間進程之間的對應。[5] 這些研究的價值,不只是宣布「某個模型比較像人腦」,而是讓我們開始檢查:模型透過語言訓練學到的哪些表徵或處理方式,也能用來描述人類的語言處理?
如果一路讀到這裡,你可能會想到前面分析模型時遇過的問題:只知道「第 12 層很好」,還是不知道裡面到底發生了什麼。一個 Transformer block 裡,不只有一份 hidden state。我們還可以取得 attention 的 Q、K、V、各個 head 讀出的內容、attention output,以及 MLP 的中間 activation 和 output。它們雖然都屬於同一個 block,卻是不同計算步驟的結果。2026 年的 The Mind’s Transformer 就把這個問題帶進 Brain–LLM Alignment:[6] 與其只比較哪一層,不如進一步比較:block 裡的哪一種中間狀態,最能預測不同腦區的反應?
研究者分析了五個模型家族、共 21 個模型,將 block 內的表徵細分成 13 種狀態,再建立 voxel-wise encoding models。讀者不需要記住全部 13 個名稱。最重要的改變是,原本只有:
第 12 層的 hidden state → 預測腦訊號
現在可以進一步比較:
第 12 層的 Query            → 預測同一批腦訊號
第 12 層的 Attention Output → 預測同一批腦訊號
第 12 層的 MLP Activation   → 預測同一批腦訊號
研究報告,不同中間狀態的優勢並不是均勻分布:部分 attention-related states 對聽覺/感覺區域的預測較有優勢,而 FFN-related states 則較常在高階聯合區域表現突出。[6] 這讓「哪一層比較有用」變成了一個更細緻的問題:模型在哪一步形成的表徵,對預測哪一類腦部反應特別有幫助?
The Mind’s Transformer 裡一個特別有意思的比較,是加入 RoPE 前後的 Query。[6] RoPE 是 Rotary Positional Embedding。它會根據 token position 旋轉 Query 與 Key,讓 attention 的計算可以利用位置關係。在研究報告的最佳狀態分析中,加入 RoPE 的 per-head Query,在約 74% 的聽覺皮質 voxels 上成為最佳 predictor;未加入 RoPE 的 Query 則約為 8%。
這個百分比的意思是逐個 voxel 比較候選表徵後,有多少比例的 voxels,是由這一類表徵取得最佳預測表現。它不是「RoPE 解釋了人腦 74% 的活動」,也不是「74% 的人類聽覺皮質在使用 RoPE」。不過,這個比較仍然提供了一條具體線索:在這套實驗設定下,加入位置資訊後的 Query,更適合用來預測某些聽覺腦訊號。接下來值得追問的就是:它提供了什麼額外資訊?是文字順序、故事進度,還是與說話節奏相關的訊號?在控制這些因素之後,優勢還存在嗎?注意,這些是由結果引出的後續問題,不是這個百分比本身已經回答的問題。
假設某個表徵很能預測聽故事時的腦部反應。我們很容易直覺地認為:「它一定捕捉到了人腦理解故事的方式。」但先想一個比較簡單的可能性:故事裡有些地方說話很密集,有些地方停頓比較久。如果模型特徵與腦訊號都跟這些時間結構有關,即使沒有捕捉高階語意,也可能得到不錯的預測。另一個問題,是怎麼切 training 與 test data。假設腦訊號來自一段連續故事。相鄰時間點的反應通常不是彼此獨立的,模型看到的上下文也可能高度重疊。如果把時間點隨機打散,就可能出現:
Training:第 100 秒、第 102 秒
Test:第 101 秒
這不等於我們真的測到了「遇到一段新的內容,還能不能預測」。測試資料可能只是夾在兩筆非常相似的訓練資料中間。
Hadidi 等人在 2026 年檢查三個常用神經資料集,發現某些既有結果會受到 shuffled split、activation extraction 方法,以及位置訊號、word rate 等因素影響。在他們測試的資料與設定中,這些簡單變數甚至足以解釋未訓練模型的 neural predictivity。[7] 這不是說所有 Brain–LLM Alignment 都不可靠,而是提醒我們:如果想把預測能力解讀成語言理解的共同結構,就要先確認它不只是靠位置、節奏或資料切分方式取得的。同樣地,當我們從很多 layers、heads 和中間狀態中挑選最佳 predictor 時,也必須把「挑選」和「最後評估」分開。不能先看過 test scores、選出最高的那個,再把它當成完全未經挑選的泛化結果。
先不急著比較 21 個模型,或抽取所有中間狀態。一個清楚的起點是:固定一個模型、一種 activation extraction 方式,以及一份具有語言刺激和真實腦部紀錄的資料。
以故事資料為例:
在資料已經完成時間對齊、設定也已用 validation data 決定之後,核心程式其實很熟悉:
encoder = Ridge(alpha=selected_alpha)

encoder.fit(H_train, Y_train)
Y_pred = encoder.predict(H_test)
接著逐個 voxel,比較預測與實測反應:
scores = [
    pearsonr(Y_pred[:, v], Y_test[:, v]).statistic
    for v in range(Y_test.shape[1])
]
這裡省略了資料前處理、時間對齊、有效 voxels 的篩選,以及統計檢定;不是完整實作。標準化等需要從資料估計參數的步驟,也必須只使用訓練資料擬合。真正值得比較的,不只是「LLM 的分數是多少」,而是:
另外,如果只是為了練習流程,人工合成的 responses 可以幫助我們檢查程式是否正確;但它不能回答模型和真實人腦是否對齊。尤其當合成訊號本來就是從某一層 activation 產生時,最後發現那一層預測得很好,只是成功找回我們自己放進去的關係。
到目前為止,我們主要在做的是用模型提出一套表徵,再檢查它能不能描述人腦的反應。要進一步主張兩邊使用相似的 mechanism,就不能只看哪個 mapping 分數比較高,還需要提出更具體、可能出錯的預測。例如,假設我們認為某一段上下文,是模型與人腦理解後續句子的共同關鍵。那就可以設計成對的語言刺激,只改變這段上下文,再檢查:
如果多種不同計算方式都能得到同樣的預測分數,就需要設計它們會給出不同預測的實驗,而不是只繼續提高同一個 benchmark 的分數。模型端的 intervention,也可以幫助我們確認:被拿來預測腦訊號的表徵,是否真的參與了模型自己的語言行為。但即使確認了這件事,也只證明它在模型中的作用。人腦端是否存在相同的因果關係,仍需要人腦的證據。這就是從「兩邊有對應」走向「兩邊可能共享某項計算原則」時,需要補上的工作。
當然,用模型 activation 預測腦訊號,只是比較模型與人腦的一個切入點。還有很多值得探索的角度:例如,模型的不同能力的表徵是否像人腦的腦區一樣,具有某種分區功能分工?人類心理測量中不同特質的關係,是否也反映在模型的表徵幾何裡?
這些比較不只是為了判斷模型「像不像人」。它們也可能幫助我們理解模型的能力如何互相依賴、為什麼出現某些行為偏差,以及介入一項能力時,可能連帶影響什麼。人類與神經科學的研究,可以提供新的問題與實驗思路,而不只是另一份讓模型追求高分的 benchmark。
從 Day 1 開始,我們一直想知道語言模型內部發生了什麼。走到今天,方向稍微反過來了:如果我們能把模型內部的表徵與計算拆得更清楚,它們也可能成為研究人類智慧的工具。我們不只可以問「模型的回答像不像人」,還可以問:
這裡最吸引人的,不是終於能宣布「Transformer 就是人腦」,而是我們有了一個能執行、能檢查、能介入的人工系統,可以用它把關於人類語言處理的假說寫得更具體。兩個系統可能共享部分處理原則,也可能用很不一樣的方式完成相似任務。它們相似在哪裡、不同在哪裡,都是值得研究的結果。
下一篇,也是這個系列的最後一篇,我們會把視角拉回來:走過這麼多工具與研究,我們現在究竟能可靠地知道什麼?哪些問題還沒有解決?如果想自己開始做 interpretability,又該從哪裡出發?Day 1,我們問的是「為什麼要打開黑盒子?」走到最後,該問的是:
這些工具,究竟能讓我們多理解了模型什麼?
[1] Kriegeskorte, N., Mur, M., & Bandettini, P. A., “Representational Similarity Analysis — Connecting the Branches of Systems Neuroscience”, Frontiers in Systems Neuroscience, 2008. https://www.frontiersin.org/journals/systems-neuroscience/articles/10.3389/neuro.06.004.2008/full
[2] Schrimpf, M., Blank, I. A., Tuckute, G., et al., “The Neural Architecture of Language: Integrative Modeling Converges on Predictive Processing”, Proceedings of the National Academy of Sciences, 2021. https://www.pnas.org/doi/10.1073/pnas.2105646118
[3] Caucheteux, C., & King, J.-R., “Brains and Algorithms Partially Converge in Natural Language Processing”, Communications Biology, 2022. https://www.nature.com/articles/s42003-022-03036-1
[4] Goldstein, A., Zada, Z., Buchnik, E., et al., “Shared Computational Principles for Language Processing in Humans and Deep Language Models”, Nature Neuroscience, 2022. https://www.nature.com/articles/s41593-022-01026-4
[5] Goldstein, A., Ham, E., Schain, M., et al., “Temporal Structure of Natural Language Processing in the Human Brain Corresponds to Layered Hierarchy of Large Language Models”, Nature Communications, 2025. https://www.nature.com/articles/s41467-025-65518-0
[6] Chen, C.-Y., & Sivakumar, R., “The Mind’s Transformer: Computational Neuroanatomy of LLM-Brain Alignment”, International Conference on Learning Representations(ICLR), 2026. https://openreview.net/forum?id=PgIlCCNxdB
[7] Hadidi, N., Feghhi, E., Song, B. H., Blank, I. A., & Kao, J. C., “Spurious Alignment Between Large Language Models and Brains Can Emerge from Non-robust Methods and Overlooked Confounds”, Nature Communications, 2026. https://doi.org/10.1038/s41467-026-72253-7



 iThome鐵人賽
 看影片追技術