
「如果手裡只有一把名為 AI 的重槌,眼前所有東西看起來都會是釘子。」
走進可行性評估的戰場,我給自己的鐵律向來很死:十四天內,必須拍板定案這案子到底「做」還是「不做」。
這十四天我用的核心原則是「排除法」。我不急著去證明這套演算法未來會有多偉大,而是瘋狂在現場排雷——只要沒有看到明顯無法跨越的物理死穴,而且商業效益在損益表上確實顧得上,這案子就接;反之,只要踩到底層不可逆的致命雷區,那就毫不留戀地及早撤案止損。
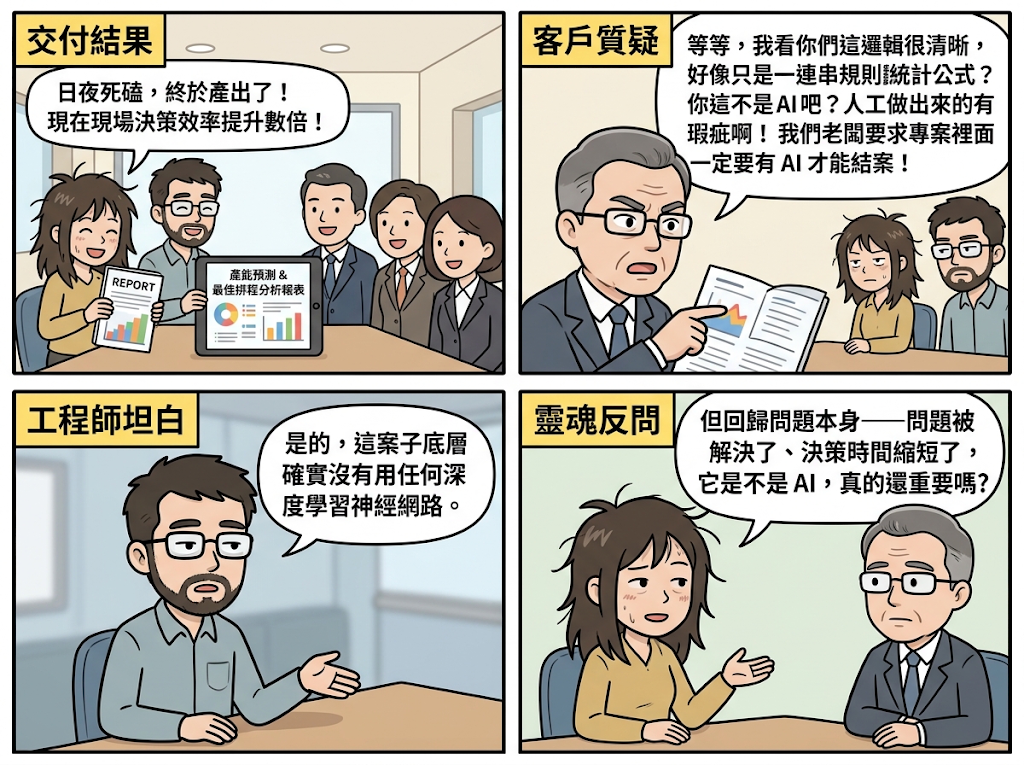
然而,當我走進廠區的會議室,白板筆都還沒拿起來,對方的窗口或長官往往第一句就丟出這個帶著焦慮與期待的靈魂拷問:
「工程師,你們這套到底有沒有 AI?底層是用哪種演算法?是不是最新、最前瞻的那種?」
每次聽到這句話,我不會急著搬出技術名詞去迎合他,反而會先收起筆,小心翼翼地向對方確認一句:
「如果……這題我們最後不用 AI 的做法,也能把問題解決,這樣可不可以?」
對方的反應往往極具戲劇性:有些人愣在原地答不上來,有些人甚至會面露難色地坦承:「不行啊,老闆交代這專案一定要有 AI 才能結案……」
這就是專案最滑稽的自嗨起點。艾倫·圖靈(Alan Turing)在提出著名的「圖靈測試」時問的是:如果隔著一道牆與機器對話,你分不分得出對方是真人還是電腦?
把這套邏輯搬回製造業與工業現場,標準其實一模一樣:當系統正式上線、工廠已經能做到全自動控制、產出的產品品質穩如泰山時,坐在中控室的操作員與廠長,到底「分不分得出」眼前這個穩健的控制迴路,是工程師熬夜寫的一連串防呆規則與統計公式,還是上千萬參數的大模型算出來的?
我通常會這樣反問對方:這算不算 AI?
如果工廠自動控制跑得極度順暢、品質波動肉眼可見地被壓平,現場根本分不出差別,那你到底是在買「能解決痛點的有效解法」,還是在買「演算法的行銷標籤」?那它底層到底是不是深度神經網路,真的還重要嗎?
如果你有接觸過早期的 AI 發展,你可能會有印象:當年的 Google 非常堅持使用「機器學習(Machine Learning)」這個詞,極度不喜歡張口閉口泛稱「AI」。
回過頭來看那段歷史,我非常能理解背後的原因。學術上名詞怎麼界定是一回事,但從一線工程實務來看,Google 當年是想把整個產業的注意力拉回冰冷、扎實且具備因果邊界的「數學與工程實踐」,而不是讓人們漂浮在名詞包裝的科幻泡泡裡自我催眠。
一旦把名詞炒成信仰,現場就會迎來最經典的盲區:「當你只會 AI,什麼都是 AI;當你手裡只有鐵鎚,看什麼東西都像釘子。」
「不要為了 AI 而 AI」,這句話出處不知道,但業界應該都聽到爛掉了。只是口號喊得震天響,現場硬套演算法的鬧劇卻從未停過,最後往往不是帶來智慧(AI),而是落得滿地雞毛的悲哀(BI)。
特別是隨著生成式 AI(GenAI)的爆發,大家越來越發現:靠著現成工具把前 80 分拼出來變得極度容易。隨便拉個 API、寫個 Prompt,就能生出漂漂亮亮的圖表和看似頭頭是道的結果。
但在殘酷的工業現場,80 分恰恰是最致命的毒藥。在商業簡報裡 80 分叫作「瑕不掩瑜」,但在每秒幾十公升原料高壓流動的反應爐旁、在動輒牽涉上億元交期的連續產線上,80 分代表的是「每控制五批貨就要失控一次、每天都在無預警報廢」!
想要攻克最後那要命的 20 分,重點從來不是開口閉口比拼最新最潮的演算法名詞,而是工程師懂不懂得看清現場的物理邊界,並且懂得在現場提出關鍵的問題。
實務上,真正能落地的工業系統絕大多數都是「混合式(Hybrid)」架構——在評估與架構初期,先把能用規則引擎(Rule-based)與統計製程防線(SPC)卡死的物理邊界穩穩架好,把常態工況牢牢鎖死;剩下的未知非線性擾動,才是演算法真正該揮棒的攻堅戰場。連基礎邊界防線都沒搭好,就妄想單靠一個黑盒子模型通吃全場,機台跳車只是早晚的事。
在十四天摸底期的會議室裡,下次當客戶或長官再次焦慮地追問「這東西到底有沒有 AI、是不是老闆要的 AI」時,請收起無謂的名詞爭辯,直接拿起白板筆,在會議室正中央寫下這道極簡的式子:
「長官,我們能不能先看看,現場到底存不存在這個 Y = f(X)?」
數位轉型的本質,是解決具體的業務痛點,而不是演算法選秀大會。如何將現場遇到的跳車、報廢、排程延誤等真實痛苦,精準轉化為一道能被數學與工程定義的命題,本身就是一門極深的真功夫。
很多專案之所以在啟動的十四天內就注定走向往生,不是因為算力不夠、不是因為資料庫太小,而是在這條極簡的公式上,從一開始就犯了致命的根本錯誤。
在急著敲鍵盤寫程式、盲目訓練模型之前,我們必須先啟動雷達,排查接下來這三個最常讓專案死無葬身之地的危險徵兆:
在專案剛破局的這兩週,最危險的念頭就是「先找演算法,再找題目」。
演算法不過是代工的工具,現場真正買單的,永遠是那個被確實解決的痛點。如果拋開 AI 這個詞,我們用扎實的混合式架構就能讓產線少跳車兩次、品質穩健提升,那這就是最高明的解方;反之,若連 Y=f(X) 的物理因果與商業邊界都說不清楚,硬塞進十層類神經網路,也只是一場昂貴的公關鬧劇。
在排除掉「為了 AI 而 AI」的虛榮雜音後,接下來的十四天生死線,我們要拿著手術刀,正式切入這道公式的第一個核心坐標——你的目標變數Y。
排除掉了「為了 AI 而 AI」的名詞狂歡,接下來的十四天生死線,我們要拿著手術刀,正式切入Y = f(X)的第一個核心坐標——你的目標變數Y。
很多團隊開口閉口談指標,抓著一堆欄位便稀哩嘩啦刻了一堆特徵X,卻連自己要打的靶到底長什麼樣都沒看過一眼。
如果目標的數值根本常年不動,甚至 KPI 是一條毫無變異的死平線,你的模型到底是在學規律,還是在學寂寞?當平均值的假象被戳破、甚至在知名醫學數據裡看到「血壓是負數」的活人時,你手裡的標籤(Ground Truth)究竟是客觀事實,還是荒謬的笑話?
更可怕的是,即便資料看起來都對,你敢保證眼前的訓練集真的具備「代表性」,能代表未來的世界嗎?等到硬體一次例行改版、現場環境稍微晃動,舊模型當場宣告報廢——廠商冷笑著遞上一張比硬體本身還貴的「重新訓練報價單」時,你才會深刻體會到什麼叫真正的痛!
站在使用者的角度,後台塞了幾百個模型他根本不在乎,他要的只是一個能在未知現實中穩健運行的一般性解法。
下一篇,我們來抓出專案暴斃的第二個元兇:《第十二章|危險徵兆 2:你的 Y 歪掉了嗎?——談數據的代表性與 Ground Truth 的代價》。


 iThome鐵人賽
 看影片追技術