

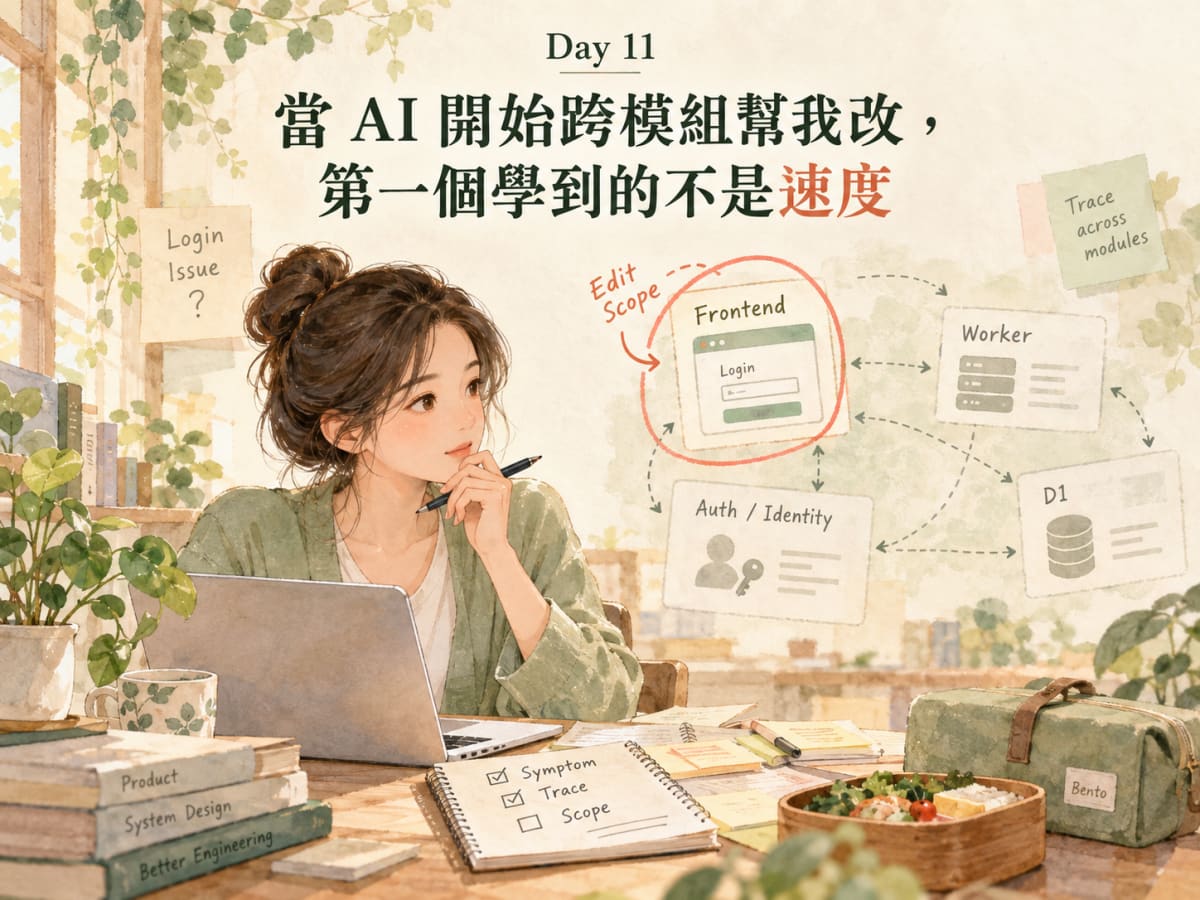
Day 10 把 Calendar 拉回 Domain 之後,這套便當系統已經很難再用「改一個畫面」來理解一個需求。
一個看似單純的登入問題,可能同時經過:
Frontend
→ Session / Auth State
→ Worker
→ D1
→ User / Role
第一版 GAS 時期,AI 就已經參與開發;差別是到了這個階段,它面對的已經不再只是單一功能,而是會互相牽動的多個 Layer。
它可以讀程式、改 Frontend、補 Worker、調整資料存取,甚至一次把幾個相關模組都整理掉。
「能改」的範圍,開始比「這次應該改」的範圍大得多。
AI 進入真實系統後,第一個需要被工程化的不是生成速度,而是先把問題定義清楚,決定這次到底允許改到哪裡。
便當系統同時支援員編與 LINE 入口後,曾經出現過一個很典型的問題。
使用者用員編 fresh login,登入本身已經成功,畫面卻又被導向 LINE 綁定流程。
從使用者看到的結果來看,很容易得到一個直覺:
登入流程有問題。
如果把這句話直接丟給 AI,可能的修改範圍非常大。
它可以開始檢查:
每一層看起來都「可能有關」。
AI 越有能力,越容易很勤奮地把整條路一起碰一遍。
但這次要先回答的,不是「哪裡可以改」,而是:
哪一層已經證明是錯的?
這次問題最後沒有先從 Backend 重寫。
先把登入後的狀態一路往前追。
概念上可以縮成:
員編登入成功
    ↓
Worker 回傳登入後狀態
    ↓
Frontend 取得 identity state
    ↓
Frontend 決定下一個畫面
追到這裡後,問題開始縮小。
Worker 端的 canonical user、session 與 bootstrap 並沒有直接證據顯示出錯;異常落在 Frontend 對某一種登入狀態的解讀。
當畫面收到類似「員工入口已成立,但 user 尚未以原本預期形式出現」的狀態時,前端把它當成「尚未完成註冊」,於是把使用者送去 LINE 綁定。
也就是說,使用者看到的是 Auth 問題,Root Cause 卻落在 Frontend state mapping。
如果一開始因為「登入怪怪的」就同時修改 Worker、D1 與身份模型,反而會把原本正常的部分也變成變數。
AI 能快速搜尋整個 Repository、跨檔案理解呼叫關係,再一次產生多個 patch。「順手把相關地方一起整理」的成本因此變得很低。
修改成本降低,不代表每個合理的修改都該在同一輪發生。
假設登入 Bug 最後只需要改 Frontend mapping,這一輪的目標應該收斂成:
確認登入後狀態
→ 找到錯誤 mapping
→ 修正 Frontend 行為
Auth 重構、User schema、LINE binding 也許都有改善空間,但不是同一個問題。
這次之後,一個變更在進入實作前,我會先做一個很小的切割。
先不要問:
要改哪些檔案?
先問四件事:
| 問題 | 這次要回答什麼 |
|---|---|
| Symptom | 使用者實際看到什麼錯誤? |
| Trace | 這個狀態經過哪些 Layer? |
| Affected Layer | 哪一層已有 Evidence 支持它是問題來源? |
| Non-goal | 哪些相關東西這一輪先不動? |
拿 fresh 員編登入來看,會比較像:
Symptom
登入後被帶去不該出現的 LINE 流程

Trace
Login → Worker state → Frontend identity mapping → Route

Affected Layer
Frontend state mapping

Non-goal
不重做 canonical user
不改 D1 schema
不重寫整套 Auth flow
這張小小的 Change Map 做的事情很單純:
先把「問題的邊界」固定,再讓 AI 進入實作。
它還不是完整規格,也不是後面會談到的驗收標準。
但少了這一步,AI 很容易從「幫我修這個 Bug」一路擴張成「把附近看起來不夠漂亮的東西一起修掉」。
這裡還有一個容易混在一起的概念。
找出 Root Cause 在 Frontend,不代表這一輪只能看到 Frontend。
為了確認問題,仍然可能需要唯讀檢查 Worker response、Session 狀態甚至 D1 資料。
差別在於:
可以檢查
≠
可以修改
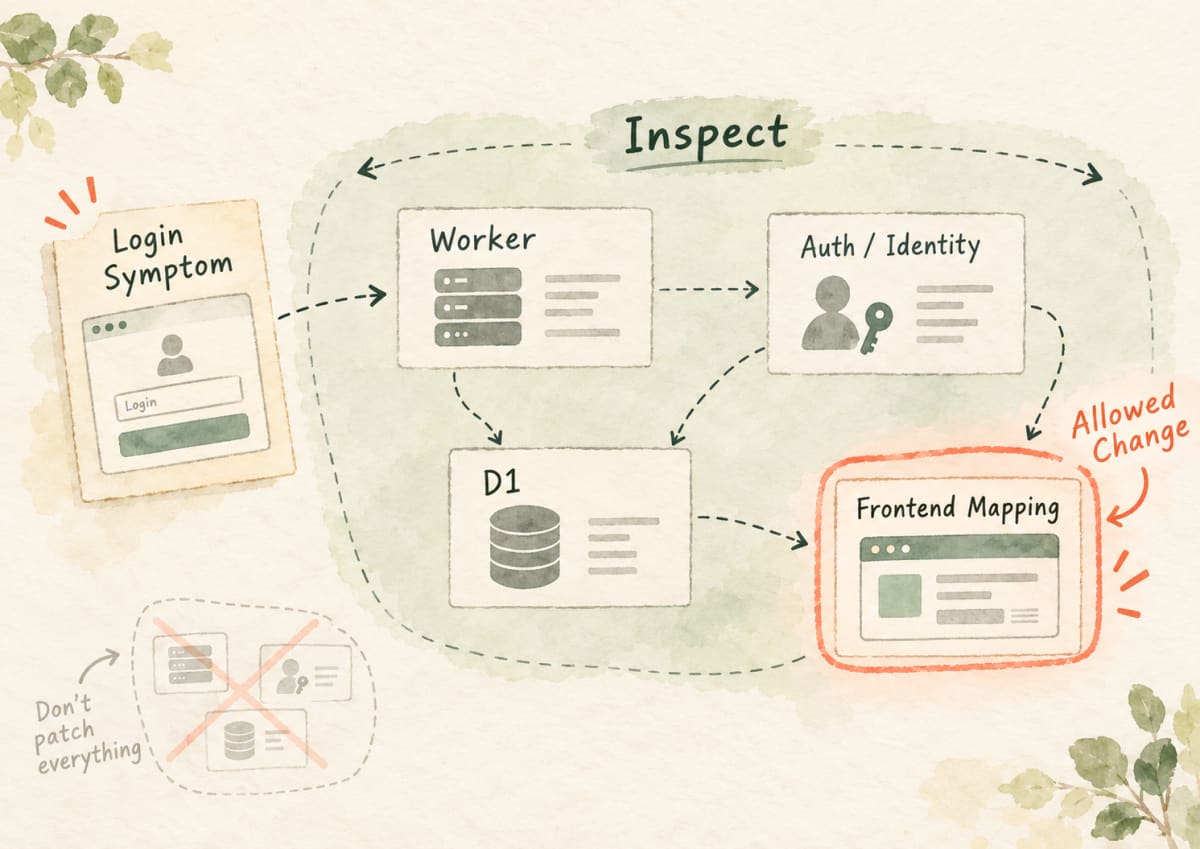
例如這次可以讓 AI:
但最後的修改授權仍然可以只落在 Frontend。
這對跨模組系統很重要。
如果「讀得到」自動等於「可以改」,Agent 能理解越多 Repository,反而越容易讓一次變更失去邊界。
早期我也很容易把 Scope 理解成:
這次只改
App.jsx。
但檔名不是最穩定的邊界。
一個功能可能本來就跨兩三個檔案;反過來,一個 4000 行的大檔案裡也可能同時混著很多不同責任。
比較有用的 Scope 是描述「責任」。
例如:
修正員編登入後 Frontend 對 identity state 的 mapping,使已成立的員工登入不再被誤導向 LINE onboarding;不改 Backend identity semantics、資料模型與綁定政策。
這種寫法比「只能改某一個檔案」更接近工程上的真實需求。
AI 可以因為實作結構需要碰兩個 Frontend component,卻仍然沒有跨出這次問題的責任邊界。
只告訴 AI「請小心修改,不要影響其他功能」也不夠。Auth、LINE、員編與 User 本來就互相關聯;如果沒有寫出 Affected Layer、Allowed Scope 與 Non-goals,「小心」沒有可操作的邊界。
AI 不需要被限制成只能改一小段 Code,但需要知道哪些相鄰責任不屬於這一輪。
邊界不是越窄越好。
如果 Root Cause 真的跨 Frontend 與 Worker,卻硬規定「只能改前端」,只會把錯誤藏起來。
例如 Frontend 收到的狀態本身就不一致,那麼只在畫面加一個 if,可能只是把底層的契約問題遮住。
因此 Scope 應該是 Trace 的結果,不是開工前憑感覺猜出來的限制。
合理順序比較像:
先描述 Symptom
        ↓
Trace 真實資料流
        ↓
定位 Affected Layer
        ↓
才決定 Allowed Scope
        ↓
進入 Implementation
不是先決定「今天只准改一個檔案」,再想辦法把所有問題塞進那裡。
早期 AI 協作最容易感受到的是速度:需求描述下去,很快就能看到畫面、API 與資料流。
系統變大後,速度仍然有價值,但開工前確認問題落在哪一層,開始比第一版 patch 多快出現更重要。
一次修 Bug 時如果多改了兩層,下一輪 Debug 就得重新確認:到底是原本的問題,還是上一輪順手修改造成的新變數?
AI 把產碼成本壓低之後,Scope 錯誤的成本反而更容易被低估。
這個做法也有邊界。純 UI 文案、明確 typo、沒有跨層影響的小改動,不需要每次都畫完整 Trace。問題越局部,流程就應該越輕;真正需要先做 Scope 定義的,是表面症狀和實際責任可能落在不同 Layer 的工作。
走到 Day 11,AI 已經可以碰 Frontend、Worker、D1 與 Auth。
這件事本身不是問題。
問題出現在我們把「它看得懂多少」直接當成「這次可以改多少」。
fresh 員編登入那次 Bug 最後留下來的教訓很具體:
先 Trace,再決定 Scope;不要從症狀直接跳到 Patch。
當問題被縮到正確的 Layer,AI 的速度才真的有用。
否則產出越快,只是更快地增加新的變數。
這不是純概念示範,而是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app
Scope 把「這次要處理到哪裡」先畫出來,但它還沒有回答另一個問題:
改到什麼狀態,才算真的完成?
當 AI 能很快交出一個看起來合理的結果,下一步就得開始把「完成」寫得比感覺更明確。


 iThome鐵人賽
 看影片追技術