
昨天讓 Claude Code 依規格修改程式,再把測試結果送回去。七個單元測試通過了,但使用者不會直接呼叫取消邏輯,他收到的是 API 回應,下游收到的是通知。
取消邏輯算出 RefundRequested=true,通知裡也一定是 true 嗎?
今天分兩半回答這個問題。前半不動任何程式,只讓 Claude 唯讀追一次這個值經過哪些地方。沒有人為錯誤,看它自己能不能指出缺口。 後半才把 Day 11 的閉環往外接一段:讓它真的啟動服務、送出取消請求,換一個負責修正的呼叫處理失敗,最後重新驗一次。用的仍是同一份訂單教學程式,不接真實金流。
動手之前先不改任何程式,我把 plan.md 第三列原樣貼給 Claude Code。材料是 API、Domain、規格與計畫,工具只有 Read、Grep、Glob,不能改檔。十五個回合、八十一秒、US$0.20。
它把路徑列了出來,每一格附行號:
| 經過哪裡 | 它給的位置 |
|---|---|
| 算出來 | Cancellation.cs:19 |
| API 拿到 | Program.cs:69 |
| 寫進 HTTP 回應 | Program.cs:89 |
| 寫進 log | Program.cs:88 |
| 放進通知 | Program.cs:79 |
| 送到接收端 | 非同步 :84 → POST body :231;同步分支 :200 |
這跟 Day 10 設計時查出來的那條資料流對得上,不是新結論。真正有意思的是另外兩件事,而且兩件都不是我安排的。
它拒絕了一個我給錯的檔名。 我的提示裡叫它讀 src/FakeSink/Program.cs,但這個包裡根本沒有這個檔,FakeSink 是另一個範例包的東西,是我貼提示時想錯了。它沒有裝作讀到,回的是「如果你要驗的是一個獨立的 src/FakeSink 專案,這在目前的材料裡不存在」。Day 9 那次的毛病是把沒提供的說成不存在;這次是提示給錯,它照實說不存在。同一條界線,兩個方向都要站得住。
然後它抓到一個我沒發現的東西。 它去讀了 verify-integration.py,指出第 57 行那個檢查只比對兩個欄位:
check('notification-ids-and-flags',
      sorted((x.get('order_id'), x.get('refund_requested')) for x in payload)
      == [('paid', True), ('unpaid', False)], payload)
看檢查的名字,再看括號裡實際比了什麼:它叫 notification-ids-and-flags,卻沒有驗 notification_id。 只比對了 order_id 與 refund_requested。
我核了那一行,它說得對。這一輪先不改,但它進了「待決與停止條件」:一個會亮綠燈的檢查,名字承諾的比它真的做的多。 這正是 Day 8 那件事換個地方又出現:出考卷的人也要被驗。
上面那六個位置現在只是行號。要讓它們能被反覆驗,得先變成程式跑得動的檢查。
verify-integration.py 會建置 API、啟動本機服務與測試接收端,等服務可用後送請求,最後保存結果、停止這次啟動的程序。接收端把收到的 JSON 留下再回成功,不寄信、不退款。它位在 Python 腳本內,和前面那個不存在的 src/FakeSink 專案路徑不同。
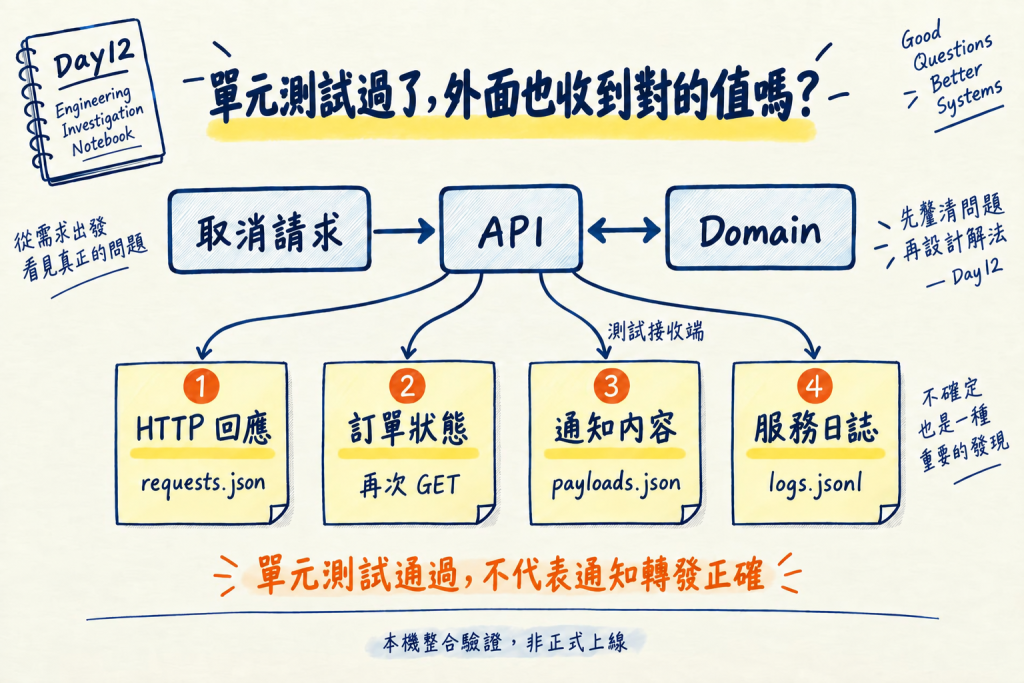
四格是觀察位置,不是執行順序:回應看 requests.json、狀態要再 GET 一次、通知看 payloads.json、首次與重送的差別看 logs.jsonl。只看 HTTP 200 的話,四格裡有三種漏法:內容錯、訂單沒改、通知帶錯旗標。本篇驗本機 API 整合,沒有瀏覽器操作或真實金流。
獨立副本裡另寫一份本輪的 CLAUDE.md,只交代三件事:測試命令、正常輸出長什麼樣、誰能改哪個檔(驗證者不能改程式,實作者只准改 src/Api/Program.cs)。
Anthropic 的 AI-native SDLC Playbook 把兩件事分開:開發中的 feedback loop 讓檢查結果持續回到修正;verifier 則用新的上下文啟動應用、檢查行為,只回報,不直接修正。本篇照這個分法切三段:
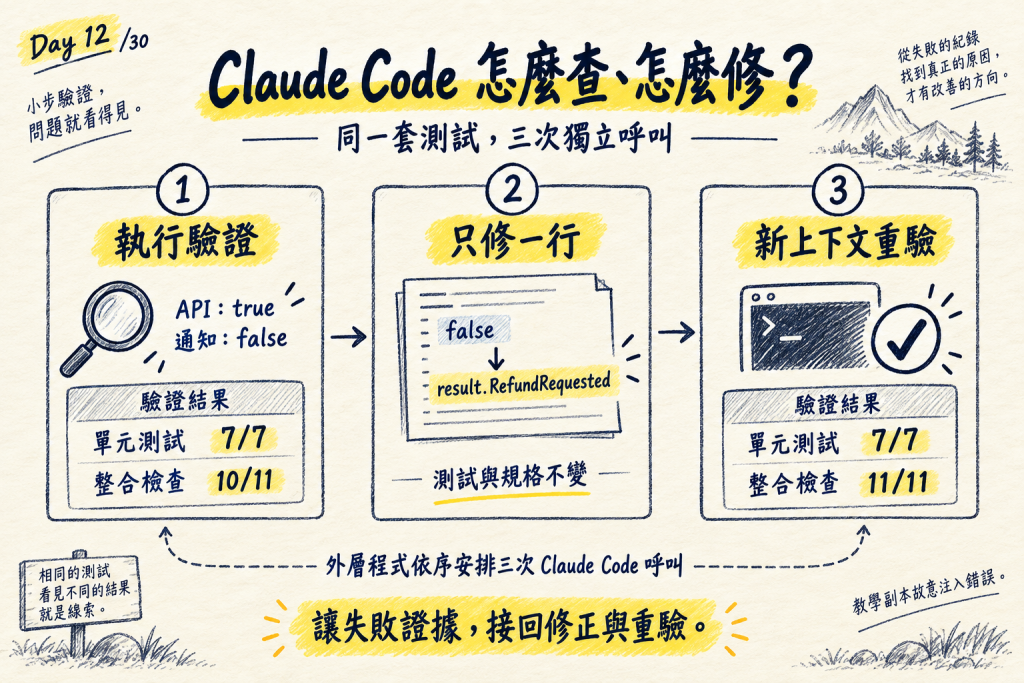
教學副本故意注入通知旗標錯誤,三次 Claude Code 呼叫由外層程式依序安排。7/7 是單元測試;10/11 與 11/11 是修正前後的整合檢查結果。
Day 11 談的是閉環怎麼接,今天擴大它能觀察的範圍:每次驗證都帶規格、版本與結果進來。
本輪用 agents.json 定義 order-verifier,透過 --agents 與 --agent order-verifier 啟動。三段呼叫由一支我自己寫的排程腳本(下面稱 runner,即「外層」:不是模型,是決定誰先跑、跑完檢查什麼的那層程式)依序發動。以下是角色指令的中文節錄,完整英文定義由 runner 保存。要看的是最後兩句,它們把「不修」與「建置失敗不算產品錯誤」寫成指令,而不是靠我事後提醒:
讀取 CLAUDE.md、plan.md 與 specs/rules-v2.md。
執行本輪指定的單元與整合測試命令。
讀取 report、requests、payloads、logs,對照規格。
回報命令、觀察到的失敗、程式位置與未驗範圍。
不要修改程式、測試或規則;只回報,不修復。
建置或環境失敗須分開,不直接當成產品錯誤。
工具權限跟著角色走:驗證呼叫有 Bash 可以跑測試,修正呼叫只有 Edit、沒有 Bash,不能自己跑一次再宣布好了。runner 另外比對來源檔案雜湊,驗證階段不得改來源,修正階段只接受 API 檔案變動。
但這些都不是強制防線。 沒有 OS 沙箱,權限設定不等於路徑隔離,雜湊是事後核對、證明不了途中沒有改過又還原。所以這次只動無正式資料的教學副本。
為了讓驗證有一個可核對的目標,runner 先在獨立副本故意把通知旗標改成固定 false,Domain、測試與規格都不動。這叫負對照:錯誤是我事先種下去的,不是 Claude 自然犯的,所以它抓到只證明「這種錯抓得到」,不證明它會自己發現未知的錯。前半那個只比兩個欄位的缺口,才是它自己找出來的。
// 正確:通知轉發 Domain 算出的結果
var n = new Notification(Guid.NewGuid().ToString("N"), id, rid,
    runId, "order_cancelled", result.RefundRequested);

// 實驗起點:只把通知這個值接錯
var n = new Notification(Guid.NewGuid().ToString("N"), id, rid,
    runId, "order_cancelled", false);
兩段是前後對照,不要一起貼進程式。第一次 verifier 真正執行單元與整合測試,而不是只閱讀舊的 pass/fail。
第一次查驗時,Claude 找到同一張已付款訂單的三份結果:HTTP 回應與日誌是 true,接收端收到的通知卻是 false。它再追到 API 建立通知的位置,指出這裡把值寫死了。
| 階段 | Claude 實際做了什麼 | 工具結果 |
|---|---|---|
| 第一次驗證 | 跑單元與整合測試,核對回應、日誌、通知及程式 | 7 個單元情境全過;11 項整合檢查只有通知旗標那項失敗 |
| 修正 | 將固定 false 改回 result.RefundRequested |
diff 只有 API 一行,測試與規格未變 |
| 新上下文重驗 | 重新執行同一套命令,讀取新產生的結果 | 7 個單元情境、11 項整合檢查全部通過 |
三次呼叫合計約 219 秒,模型費用約 US$0.527。這是呼叫經過時間與模型費用,人工準備、核對時間未記錄,不能拿來算省時。重驗曾嘗試額外查工具版本,被權限設定拒絕;兩項必要測試已執行,不把這個拒絕隱藏成零異常。
不過這裡要先說清楚一件事,因為它決定了上面那張表能證明多少:新上下文仍共用同一份規格與驗證器,所以它不是獨立的真值來源。 斷言本來就漏掉的東西,重驗一百次也還是綠的。這正是 Day 8 的方法在開發裡的用途:檢查我們拿來判斷的依據,而不只是多問一次 AI。
這次真正接起來的是:驗證者拿出不一致的輸出,實作者修正接錯的地方,再用沒有被放寬的檢查重驗。 三個角色由外層程式依序呼叫,不是讓同一段對話自行宣布修好了。
正常整合情境仍是三張訂單加一次重送:
| 操作 | HTTP | 回應的退款旗標 | 本次是否改變狀態 |
|---|---|---|---|
| 已付款首次取消 | 200 | true | true |
| 同一張再次取消 | 200 | false | false |
| 未付款取消 | 200 | false | true |
| 已出貨取消 | 409 | false | false |
這張表也說明為什麼不能只看 200。首次與重送都成功,但只有首次 transitioned=true,才會建立通知;再由接收端紀錄核對觀察期間沒有新增第三筆。無測試身分標頭得到 401,只代表範例標頭檢查,不是正式認證或訂單授權已驗完。
把今天證到哪裡整理成一張表,連同沒證到的一起交出去。前半那個「只比對兩個欄位」的缺口就列在第二列。它被指出來了,但這一輪沒有補檢查。
| 檢查內容 | 本篇證據範圍 |
|---|---|
order_id、refund_requested 與通知筆數 |
驗證器有比對;故意改錯退款旗標已實跑被抓到 |
kind、notification_id、request_id、run_id 的通知內容 |
這項斷言沒有涵蓋;依程式判讀,未逐欄另做變異實驗 |
| 並行取消、重啟、真實下游與正式權限 | 不在這次本機順序測試範圍 |
一個負對照,證明的是這種錯誤抓得到。 其他欄位是否必要,要依通知契約決定,再補檢查;不能只看 notification-ids-and-flags 的名稱就假設全部驗過。
取得完整開發包後,需要 Python 3、.NET 9 SDK。開發包與 Day 11 共用,位在配套 repo 的 days/day11/lab-dev/;本次新增的 run-verifier-cycle.py 與 runs/verifier-cycle-01 隨本篇一起推上去。
在完整新版的包根目錄執行:
# 不呼叫模型:正常整合驗證
python verify-integration.py reader-integration-02

# 需要已安裝並登入 Claude Code,會消耗模型用量
python run-verifier-cycle.py reader-verifier-01
第二個命令會建立獨立副本、注入同一個教學錯誤,再依序呼叫驗證、修正與新一輪驗證。每個角色只跑一次;修正後仍失敗、來源範圍不符或模型執行失敗就停止,不無限重試。每次使用未用過的名稱,原件不覆蓋。
跑完看三處:
runs/reader-verifier-01/report.json:**總結每個階段、費用、來源變動與結果;status=VERIFIED 只表示本輪指定檢查成立。verify-red、repair、verify-green:**各自的 prompt、trace 與回答。核對模型是否真的呼叫工具,不只看摘要。workspace/runs/verifier-red、verifier-green 與 repair.diff:**實際測試輸出、通知內容與修正差異。測試沒被放寬,修正才有可比性。用到自己的專案時,先固定規格與驗收,再提供能一鍵啟動、檢查、清理的命令。Verifier 的回報交回實作者;遇到需求衝突、越出範圍或需要正式權限,就交回負責人。可執行的驗證建立好了,才適合減少人在中間反覆轉貼結果。
想再往外走的話,三份公開材料的方向是一致的:讓 AI 看得到系統實際運行的結果,再決定下一步:Anthropic 的評估 agent 透過 Playwright MCP 操作應用並檢查 UI、API 與資料狀態;OpenAI 的 harness 讓每個 worktree 都能啟動應用、查該環境的 log 與 trace;Uber 的 DragonCrawl 則配合故障注入檢查使用流程。三者是各自公開的實驗,不是同一套標準流程;本篇只用本機 API 與測試接收端,規模與它們不同。
今天完成的是開發計畫中的 API 整合查驗,後面還有審查、封裝與交付。
明天把這份修改與結果交給 review-kit:工具驗過、Claude 也核對了,哪些決定仍要 Owner 接住?
參考資料:
本文實作紀錄
examples/sdlc-development,由訂單教學快照 885e521 延伸。Day 10 分析包與可建置開發包分開保存,不接真實金流。runs/verifier-cycle-01;新角色設定、三次提示、trace、回答、修正 diff、原始整合輸出與總結均保存。模型選項 sonnet、medium effort,trace 記錄實際模型為 claude-sonnet-5;不同階段為不接續的 CLI 呼叫,未宣稱父 agent 自主委派 subagent。外層 runner 排定三段工作,verifier 由 Claude 實際呼叫測試工具。boundary-01 唯讀分析;integration-01 11 項通過;ci-local-01-integration 本機流水線;boundary-negative-01 缺 VERSION 建置失敗;boundary-negative-02 由外層直接注入與還原。這些不是新 verifier 的成果。reader-negative-01,10 回合、40 秒、US$0.154,僅唯讀分析;通知斷言只檢查兩欄的結論有程式依據,不把其他欄位的靜態推論寫成全數實跑。days/day11/lab-dev/;本次新增 run-verifier-cycle.py 與 runs/verifier-cycle-01,隨本篇一起公開。官方文件與工程經驗


 iThome鐵人賽
 看影片追技術