
程式測試通過,多半只能說明單一服務本身沒問題。上線前,身分、路由、事件、ERP 介接、監控和回退要串起來一起驗過,才比較能放心上線。所以今天我會把完整流程再走一次。
本機測試完成是重要的一步,但還有幾件事要另外安排驗證:服務之間的 API 和事件格式有沒有保持相容、程式有沒有違反架構規範、指標超過門檻時告警會不會通知到人、備份能不能真的還原。其中最要緊的是出了問題時,能不能回到原本可以運作的狀態。
上線 SOP 裡的「退回舊版」看起來只是一個步驟,但如果資料庫 migration 已經跑過、或事件 schema 已經改了,換回舊版程式時,資料庫裡的資料和已經送出的事件還是新格式,舊程式讀取時可能找不到欄位,或解析事件時直接失敗。所以回退這一步,我會在上線前實際演練一次,確認舊版程式遇到新格式的資料時還能正常運作。
這些驗證範圍不同,我會分成下面六層來安排,每層抓的是不同類型的問題:
| 層次 | 驗證什麼 |
|---|---|
| Unit | mapping、規則、錯誤轉換 |
| Contract | API/事件 schema 相容性 |
| Integration | DB、broker、Keycloak、ERP 模擬服務 |
| End-to-End | 一筆訂單跨服務完成 |
| Architecture | 禁止跨 Schema、禁止繞過 Adapter |
| Operational | 告警、備份還原、容量、回退 |
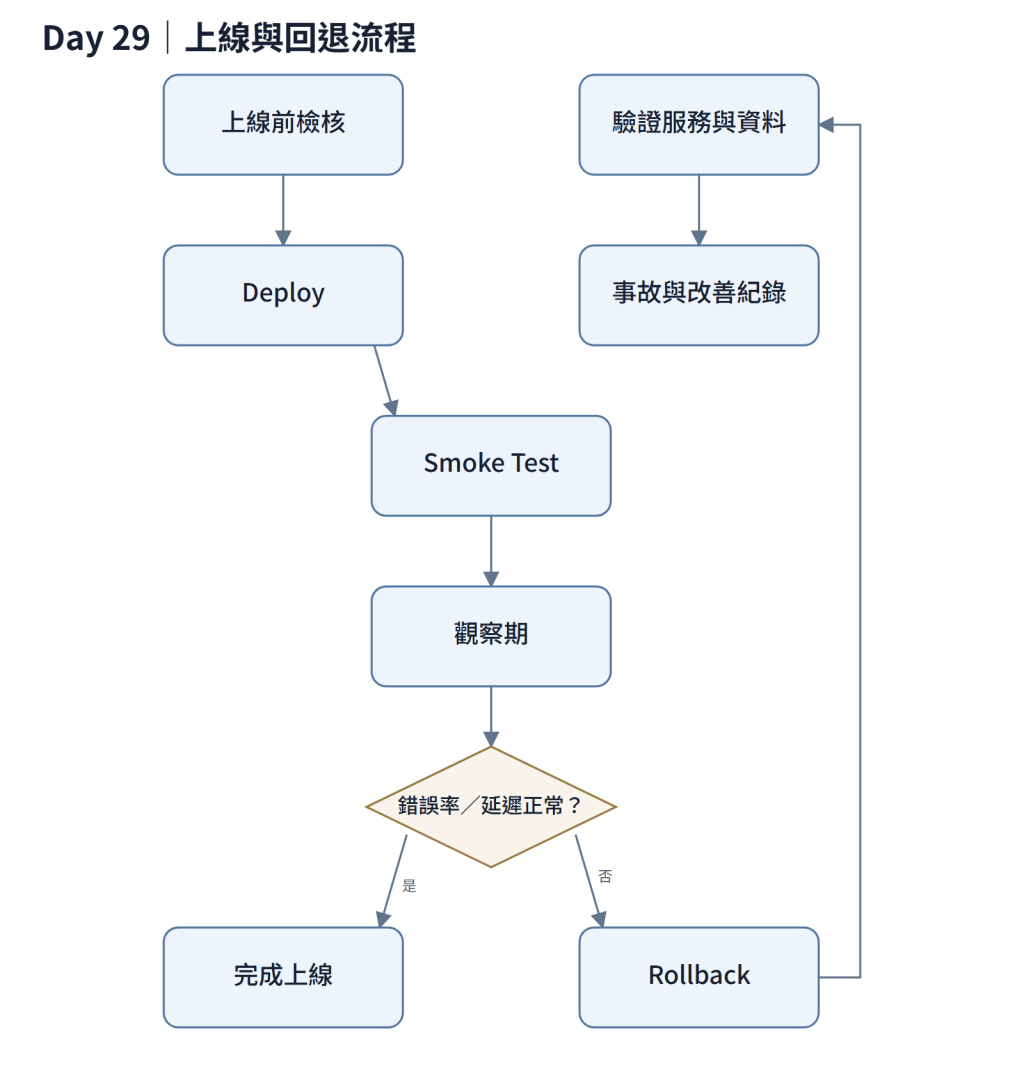
圖 Day 29-1:上線與回退流程。
有些問題不會在部署當下出現。例如程式有連線沒釋放時,連線池會隨著請求累積慢慢耗盡,smoke test 當下通過,過一段時間錯誤率和延遲才開始升高。所以 smoke test 確認基本功能之後,還要留一段觀察期,持續看錯誤率、延遲與業務指標。看這張流程圖,我會把 Deploy 後面的 smoke test 和觀察期都算進上線工作,觀察期結束、指標正常,才算上線完成。
回退也不是退完就結束。照圖上的順序,退回之後先確認服務已經恢復、資料沒有缺漏或寫錯,再寫事故與改善紀錄,記下這次為什麼出錯、之後要改什麼,同樣的問題下次才比較不會再發生。
至於表格裡的 Architecture 這層,是用測試確認程式碼沒有越過前面幾篇劃好的服務邊界,例如服務不能跨 Schema 存取別人的資料、不能繞過 Adapter 直接呼叫 ERP。因為這類違規靠人工審查容易漏看,所以我會把規則寫成測試放進建置流程,只要有程式碼違反規則,建置就會失敗。這樣問題在建置階段就會被發現並修正,不用等到上線後,才察覺邊界已經被越過。
上線前要確認的項目很多,我會照下面的清單逐項核對,不靠記憶。部署後的 smoke test 已經寫進部署腳本,容器健康檢查通過、路由也載入完成,才算部署完成;接著才進入前面提到的觀察期。
應用程式、資料庫與訊息 schema 的回復方式不一樣。應用程式通常換回舊版 image 就能恢復,但資料庫裡的資料和已經送出的訊息,不會跟著一起退回。所以不能只寫一個退版指令,就當作全部都能恢復;Rollback 文件我會把這三部分分開寫,各自列出步驟和確認方式。
資料庫最麻煩的是破壞性變更,例如刪欄位、改欄位名稱。這類 migration 如果無法反向執行,換回舊版 image 只會換掉程式,資料庫還是維持新的結構;如果是刪欄位,資料只能靠備份找回,而且只找得回備份時間點之前的部分,這段缺口能有多大,就是 RPO 要限制的範圍。所以我會至少分兩次上線:第一次讓新舊欄位並存,新舊版程式都能運作;確認沒問題後,第二次才刪舊欄位。這樣每次上線都還能退回前一版。過渡期間如果新舊欄位都要寫入,還要安排對帳:比對兩邊的資料,不一致的就修正回來。
訊息這邊,Producer 和 Consumer 不一定同時升級、同時回退,佇列裡也可能有另一個版本送出、還沒處理的訊息。所以事件 schema 的相容性要測兩個方向:新版 Consumer 能不能解析佇列裡還留著的舊版訊息;舊版 Consumer 能不能解析新版送出的訊息,不管是 Producer 先升級,還是 Consumer 回退,都會遇到這種情況。
把上面這些整理成清單,我會分成上線前、部署後、需要回退時三段。後面的「測試證據完整率」是拿這些紀錄來算的,所以每一項做完都要留下紀錄。
上線前
部署後
需要回退時
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 驗證與核准依風險分級 | 低風險變更不必承擔全部流程成本 | 分級標準與實際事故分佈不符時 |
| 回退能力必須演練確認 | 沒演練過,就無法確定真的退得回去 | 無 |
| 破壞性 migration 分階段執行 | 每次上線都還能退回前一版 | 無 |
| 部署後保留觀察期 | 像連線池耗盡這類問題,部署當下看不出來 | 無 |
驗證與核准可以依風險分級,低風險變更走比較輕的流程。回退演練則是例外:資料庫回復的步驟多,環境只要有調整,例如資料庫升版或權限變更,原本寫好的操作就可能做不下去,而且只有實際再跑一次才知道。所以就算變更風險低,我也會保留回退演練。
| 指標 | 計算方式 | 想回答的問題 |
|---|---|---|
| 回退時間 | 從決定回退到服務恢復的實際時間 | 回退能不能在 RTO 內完成? |
| 演練結果 | 完成的演練次數與發現的問題數 | 方案是否隨環境變動而失效? |
| 測試證據完整率 | 三份清單每一項都有紀錄的上線次數/全部上線次數 | 每次上線是否可追溯? |
| 上線後事故率 | 上線後引發事故的次數/上線次數 | 上線前檢核有沒有擋下問題? |
只記次數,看不出演練到底測了什麼。所以演練完,我會把測了哪些情境、花了多久、發現哪些問題一起記下來。如果一次問題都沒發現,不一定代表方案沒問題,也可能是情境沒涵蓋到重要風險,這時要回頭檢查演練的情境。
今天的結論是:上線前除了確認功能能跑,監控要能在出問題時發現異常,回退也要真的演練過、確定退得回去。下一篇是系列的最後一篇,我想回頭整理這一路的重點,以及接下來還可以繼續做哪些事。


 iThome鐵人賽
 看影片追技術