
Pod 預設是沒有資源上限的,一個程式如果寫壞了無限吃記憶體, 就會把整台 Node 的記憶體吃光,然後同一台上面的其他 Pod 跟著一起死
K8s 用兩個欄位處理這件事,requests 跟 limits
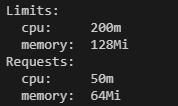
改 deployment.yaml,在 container 下加入:
          resources:
            requests:
              cpu: "50m"
              memory: "64Mi"
            limits:
              cpu: "200m"
              memory: "128Mi"
CPU 超過 limit 的時候,Container 會被 throttle,會覺得這服務怎麼有點卡,不會有任何錯誤訊息
記憶體超過 limit 的時候,Container 會被直接砍掉,狀態變成 OOMKilled
套用之後看看
kubectl apply -f manifests/base
kubectl describe pod -n ithome-lab -l app=web
也可以從 Node 的角度看資源被分掉多少
kubectl describe node
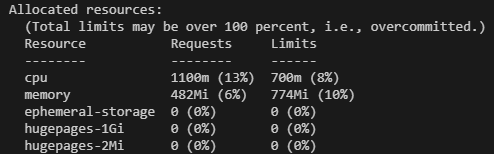
這裡顯示的是已經被預約掉的比例,不是實際用量,一台 Node 可能 requests 已經被訂滿了排不進新 Pod,但實際 CPU 使用率只有 5%
describe pod 的最下面還會看到一個 QoS Class 欄位
kubectl get pod -n ithome-lab -l app=web -o jsonpath="{.items[0].status.qosClass}"

這是 K8s 自己算出來的分類,決定 Node 記憶體不夠的時候先砍誰。requests 跟 limits 完全相等是 Guaranteed,最不容易被砍;有設但不相等是 Burstable;兩個都沒設是 BestEffort。我這裡兩個數字不一樣,所以是 Burstable
今天先這樣,明天見 :D


 iThome鐵人賽
 看影片追技術