
上一篇把記憶接上了:模型開口要,你的程式碼負責存。收尾那句話是記憶越寫越多,窗口跟帳單都不會等你。
今天處理相反的動作:把東西丟掉。先講結論:忘記是一個要設計的動作。 壓縮是一次你沒有親手寫的寫入,清除要留下一行紀錄,而「把最舊的砍掉」是最糟的做法,因為它挑的是唯一一個跟重要性無關的條件。
找一段跑了一陣子的 Claude Code 工作階段,前面有你交代過的規則,中間有試過但失敗的做法。
/compact,一件一件問它那三件事。/compact 保留:我交代過的約束、試過但失敗的做法與原因,再問一次。我預期第一次掉最多的是「試過但失敗的做法」:摘要的本能是留結論、省略過程,而失敗的嘗試就是過程。第二次多出來的那一句,就是你的寫入規則。
| 面向 | 壓縮(compaction) | 清除 | 先進先出(first in, first out) |
|---|---|---|---|
| 做了什麼 | 把一段換成摘要 | 把某一類內容整段拿掉 | 從最舊的開始砍 |
| 誰決定丟什麼 | 摘要模型 | 你(按內容種類) | 時間 |
| Claude 上的對應 | Claude Code 的 /compact、API 的伺服器端壓縮 |
API 的脈絡編輯(context editing) | 聊天介面可以這樣滾動管理 |
| 要不要多一次模型呼叫 | 要 | 不用 | 不用 |
壓縮是一次有損的寫入。 它跟第 12 篇的滾動摘要是同一個動作,差別只在寫的人:你沒交代,就照摘要模型自己的判準。第 12 篇引過 LongMemEval(Wu et al., ICLR 2025):把記憶壓成事實,表現會變差。一段對話被壓過兩次,第一次掉的東西,第二次連「曾經有過」都不會留下。
所以交給 /compact 的那一句,我直接從第 12 篇的寫入規則改過來:
/compact 摘要時一定保留四種東西,每條一行,照原話不要改寫:
1. 約束:我明確說過的規則(包括「不要做什麼」)
2. 結論:已經定案的決定,以及定案的理由
3. 教訓:試過但不行的做法,以及為什麼不行
4. 線索:讀過、改過的檔案路徑與指令,不用內容
其餘的討論過程可以濃縮成一兩句。
「照原話」是為了約束:我最怕摘要把「不要動 migration」寫成「migration 要小心」,前者是規則,後者只剩提醒。第 4 項的理由在下一節的圖裡。不想每次手打,就把這四條寫進 CLAUDE.md 的 # Compact instructions 段落。
/compact 按下去之後,實際發生了什麼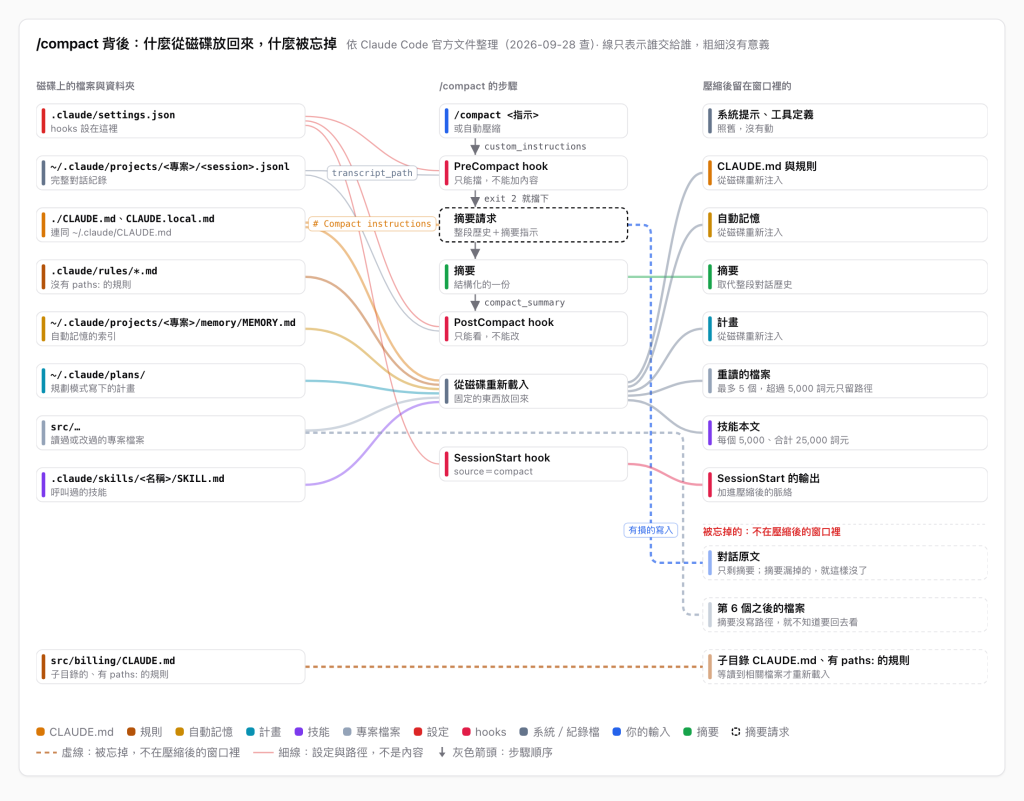
這張圖照 Claude Code 的提示詞快取、脈絡窗口與 hooks 三頁官方文件整理(2026-09-28 查),線只表示誰交給誰。左欄是磁碟上的檔案,中欄是 /compact 做的事,右欄是壓縮完窗口裡剩下的。重點有三個:
/compact 最貴的時候。paths: 的規則要等它再讀到相關檔案才回來。中欄兩個 hook 設在 .claude/settings.json:PreCompact 拿得到你的 custom_instructions 與對話紀錄的 transcript_path,但只能擋(結束碼 2),不能替摘要加東西;PostCompact 拿得到剛寫好的 compact_summary,官方文件舉的用途正是把摘要記下來。後面講「丟掉的要留一行紀錄」,在 Claude Code 裡這就是現成的位置。
MemoryAgentBench(Hu, Wang, McAuley, 2025)整理出記憶代理的四項核心能力:精準取回、測試時學習、長程理解,以及選擇性遺忘(selective forgetting),並指出既有基準沒有一個涵蓋全部四項。該忘的沒忘,跟該記的沒記一樣,是量得出來的失敗。
這個系列的評估集就缺這一項。第 4 篇那十題裡,第 5、6 題量的是記不記得,沒有一題在量它會不會忘。假設團隊把規則改成「review 可以寫風格意見,但要標成 nit」,你照第 12 篇把舊約束 DELETE 掉;可是舊的那句早被壓進某一版摘要,還在窗口裡。代理照哪一條做,第 6 題量不出來。
第 11 篇提過 StreamingLLM(Xiao et al., ICLR 2024):只留最近那一段,模型會壞掉,因為它把很強的注意力放在最前面幾個詞元上,也就是注意力沉降(attention sink)。H2O(Zhang et al., 2023)補上另一半:鍵值快取(KV cache)裡一小部分詞元貢獻了大部分的注意力價值,作者叫它們 Heavy Hitters。兩篇指向同一件事:重要性集中在少數詞元上,新舊不是判斷它的標準。
這兩篇量的是模型內部的鍵值快取,不是你送出去的
messages。 我借的只有結論:連模型自己挑東西丟,都不能照時間順序來。
回到應用這一側,理由更直接:最舊的那一段通常就是任務本身與你交代的約束;時間是唯一跟內容無關的條件;砍掉的東西不留任何痕跡。Claude 的官方文件寫明,claude.ai 這類聊天介面可以用滾動的先進先出管理窗口(2026-09-17 查)。文件說的是「可以」;但如果長聊天裡它不再照你一開始交代的格式回答,這是值得先懷疑的原因。
壓縮:Claude Code 接近上限會自動壓縮,也可以自己下 /compact;要重新開始而不是延續,/clear 不花錢(官方文件,2026-09-17 查)。API 的伺服器端壓縮分兩種(2026-09-28 查):依詞元門檻(compact-2026-01-12,預設 15 萬詞元觸發)與隨需(compact-2026-09-04,你決定什麼時候壓),官方建議能用隨需就用隨需。用門檻版要記得把回應的整個 content 接回 messages,只存文字的話,壓縮區塊會悄悄消失。
清除是 API 的脈絡編輯(2026-09-28 查):不做摘要,直接把舊的工具回傳(tool result)或思考區塊(thinking block)拿掉。
response = client.beta.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    betas=["context-management-2025-06-27"],
    context_management={"edits": [{"type": "clear_tool_uses_20250919"}]},
    tools=tools,
    messages=messages,
)
clear_tool_uses_20250919 預設在輸入超過 10 萬詞元時,從最舊的開始把工具回傳換成佔位文字,保留最近 3 組;exclude_tools 指定哪些永遠不清。清思考區塊的是 clear_thinking_20251015。兩個都還是 beta,介面可能會改,所以你的做法最好寫成一個改得動的函式。
兩個開關的分工,照丟掉的東西能不能拿回來分:
| 窗口裡的東西 | 拿得回來嗎 | 怎麼處理 |
|---|---|---|
| 工具回傳:讀過的檔案、跑過的指令輸出 | 重跑一次就好 | 清除 |
| 討論的過程、中間的推理 | 拿不回來,但細節多半不需要 | 壓縮,並說要保留什麼 |
| 約束、定案的決定、失敗的教訓 | 拿不回來,而且錯不得 | 先寫進記憶(上一篇的記憶工具),再讓它被壓 |
| 任務本身、系統提示 | 不該丟 | 放在系統提示或第一則訊息 |
能重拿的就清除,拿不回來的才壓縮,錯不得的先寫進記憶。
上一篇講過:記憶錯了,它不會告訴你那句話是哪天寫進去的。遺忘更難查:模型突然不知道某件事,你分不出它是從來沒看過,還是看過但被清掉了。
所以我清東西一定留兩份痕跡:窗口裡一行佔位(placeholder),讓模型知道需要時可以重拿;窗口外一行紀錄,讓你查得到清了什麼。
import json

def find_call(messages, tool_use_id):
    for m in messages:
        if m["role"] == "assistant":
            for b in m["content"]:
                if b["type"] == "tool_use" and b["id"] == tool_use_id:
                    return b

def forget_tool_results(messages, keep_last, today, log):
    results = [b for m in messages if m["role"] == "user" and isinstance(m["content"], list)
               for b in m["content"] if b["type"] == "tool_result"]
    for block in results[:max(len(results) - keep_last, 0)]:
        if block["content"].startswith("[已清除"):
            continue  # 清過的不要再清一次
        call = find_call(messages, block["tool_use_id"])
        what = f'{call["name"]} {json.dumps(call["input"], ensure_ascii=False)}'
        log.append(f'{today}\t清除\t{what}\t原長 {len(block["content"])} 字元')
        block["content"] = f"[已清除 {today}:{what},需要時重新呼叫]"
    return messages
拿一段假的除錯對話跑它:代理依序讀了三個檔案,只保留最後一個工具回傳,而且故意呼叫兩次。本機 Python 3.13 的輸出:
[已清除 2026-09-28:read_file {"path": "src/refund.py"},需要時重新呼叫]
[已清除 2026-09-28:read_file {"path": "src/pricing.py"},需要時重新呼叫]
def test_partial_refund():
---
2026-09-28	清除	read_file {"path": "src/refund.py"}	原長 979 字元
2026-09-28	清除	read_file {"path": "src/pricing.py"}	原長 657 字元
上半是窗口裡剩下的,前兩個變成佔位;下半是紀錄檔,第二次呼叫沒有重複記。檔案內容是假資料,長度用字元數;要知道省下多少詞元,用第 11 篇的 count_tokens 量前後各一次。改用脈絡編輯讓 API 替你清,我一樣在自己這邊記一筆:從哪天開始清、清哪一類。
第一,每清一次,快取就斷一次。 快取認的是一模一樣的前綴,改了第 3 輪,之後全部重寫。所以累積到一個量再清;脈絡編輯的 clear_at_least 就是為這件事留的。
第二,壓縮多花一次呼叫,而且寫錯了沒人知道。 摘要漏了什麼,你只有在它照著錯的摘要做事時才會發現。
第三,忘記的範圍要自己畫。 平台只給開關,界線是你的。第 12 篇的寫入規則管什麼能進來,這一篇的判準表管什麼能出去,兩份要一起維護。
我現在的習慣是:任務寫在系統提示裡;約束與教訓一出現就寫進記憶;工具回傳累積到一個量就清,清之前先記一筆;真的要壓縮,一定附上「要保留什麼」。
多了什麼能力:你的代理可以跑得比窗口還長,而且丟東西有依據。你分得清壓縮、清除與先進先出,知道
/compact背後放回了什麼、忘掉了什麼,也有一張按「拿不拿得回來」決定怎麼丟的判準表,和一個清除前先記一筆的函式。多付了什麼代價:一次次斷掉的快取、壓縮時多花的呼叫,以及一個你必須自己畫的遺忘範圍。摘要寫錯的東西,會變成之後唯一的版本。
這一篇處理的是「該忘的,怎麼忘」。反過來,如果記住的那一句本身就是錯的呢?
前面那個例子其實已經露出一角:你把「review 不寫風格意見」刪掉了,舊的那句卻還躲在某一版摘要裡。錯的記憶不只來自你寫錯,也可能是更新時判錯、留下了該刪的那條,甚至是別人跟代理聊天時寫進去的。
第 6 篇對付錯話的辦法是開一個新對話,讓它留在舊窗口裡。記憶打開之後,這條退路就沒了:錯的那一句會跟著你進到每一個新對話,被一次次讀出來當成依據。下一篇把寫入這條線收尾:記錯的東西留下來會怎樣、怎麼發現它,以及整個第四層到底讓你多付了多少。
/compact 的摘要請求為什麼大多讀快取。


 iThome鐵人賽
 看影片追技術