
第 6 篇畫過一條界線:這一層管這一次呼叫的窗口裡放什麼,跨對話留下什麼是第四層。 今天起進第四層「記憶」。
一個貼心的代理,會記得你三輪前順口提過的那件小事。它是怎麼記得的? 答案很不浪漫:那句話每一輪都被重新送了一次。
所以這一層的第一篇不談記憶,談算術。上一篇結尾那張帳單,還沒有人替你算過。
說穿了,你以為自己在「對話」,其實你每一輪都在把前面說過的話重打一遍寄出去。今天就把這張帳單攤開來看。
有 API 最順,沒有也做得起來,只要五輪對話。
第一步:開一段新對話,連續問五個有來有回的問題,每一題都接著上一題講。
第二步:每一輪都把回應裡的 usage.input_tokens 抄下來。走介面的話,就在每一輪之前把整段對話貼給 count_tokens 量一次。
第三步:把五個數字並排看。
你會看到一條往上長的線,而你這五輪打的字其實差不多一樣多。多出來的不是你新講的東西,是你前面講過的東西又被送了一次。
第 5 篇講過,權重是凍結的,會變的只有這一次推論的輸入。上一篇把它推到底:這條管線上沒有任何一個地方記得上一輪發生過什麼。
所以「它記得我剛剛說的話」這件事,機制上只有一種做法:把剛剛說的話,連同這一次的問題,一起再送進去。 API 上很直白,messages 是一個陣列,你每一輪都要把整個陣列重新送出:
第 1 輪   messages = [ 你的問題 1 ]
第 2 輪   messages = [ 你的問題 1、它的回答 1、你的問題 2 ]
第 3 輪   messages = [ 你的問題 1、它的回答 1、你的問題 2、它的回答 2、你的問題 3 ]
介面幫你做掉了這件事,所以你看不到。但帳單看得到。
這就是短期記憶的全部:沒有儲存、沒有回憶,只有一份每一輪都變長的稿子,重念一次。
拿一組好算的數字來看。假設系統提示 1,000 個詞元,每一輪一問一答加起來 500 個詞元,而你這一次打的問題是 250 個。
| 輪次 | 這一輪送進去的輸入詞元 | 其中你已經送過的 |
|---|---|---|
| 第 1 輪 | 1,250 | 0 |
| 第 2 輪 | 1,750 | 86% |
| 第 5 輪 | 3,250 | 92% |
| 第 10 輪 | 5,750 | 96% |
| 第 20 輪 | 10,750 | 98% |
(這幾個數字是我用上面那組假設自己乘出來的,你的比例會不一樣,但形狀一樣。)
看最後一列:到第 20 輪,你付的每 100 個輸入詞元裡,有 98 個是你早就送過的東西。
二十輪加起來,輸入總共是 12 萬個詞元。以官方定價表上 Claude Opus 5 的輸入價 每百萬詞元 5 美元(2026-09-25 查)算,這段對話的輸入大約 0.6 美元。
重點不是 0.6 美元,是形狀:你新講的東西是線性成長的,帳單是平方成長的。
一個人聊二十輪沒事。一千個使用者每天各聊一段二十輪的對話,就是 1.2 億個輸入詞元,同一個價目表算下來一天大約 600 美元。 真正咬人的從來不是單一對話,是這個形狀乘上使用量。
想通這件事,兩個現象就解開了:
那張表算的是詞元,不是字,而這兩件事差很多。第 4 篇那張圖量過:61 個字元被切成 38 個詞元,中文多半一個字一個詞元,英文常常整個單字連同前面的空白算一個。
詞元這個東西本身是有出處的。現在這一套切法的源頭是 Sennrich et al.(ACL 2016):他們把**位元組對編碼(byte pair encoding,BPE)**這個壓縮演算法拿來切詞,讓模型用「子詞單位」處理沒見過的字,從此固定詞彙表也能處理開放詞彙。你帳單上的每一個詞元,都是那篇論文那個做法的產物。
而這件事對中文使用者不是中性的。Language Model Tokenizers Introduce Unfairness Between Languages(Petrov et al., NeurIPS 2023)量的就是這個:同一段文字翻成不同語言,切出來的詞元數最多可以差 15 倍,而且即使是刻意為多語訓練的分詞器也還是有差;連字元級與位元組級的模型,在某些語言配對上也有 4 倍以上的落差。
論文自己列出這種落差的三個後果,每一個都直接打在這一篇的題目上:用商業語言服務的成本、處理時間與延遲,以及能放進脈絡的內容量。
不過 15 倍是他們在全世界的語言之間量到的最大落差,不是你的落差。所以我自己量了一次:拿《世界人權宣言》第一條的六種聯合國官方語言版本,用公開的 o200k_base 分詞器各切一遍。
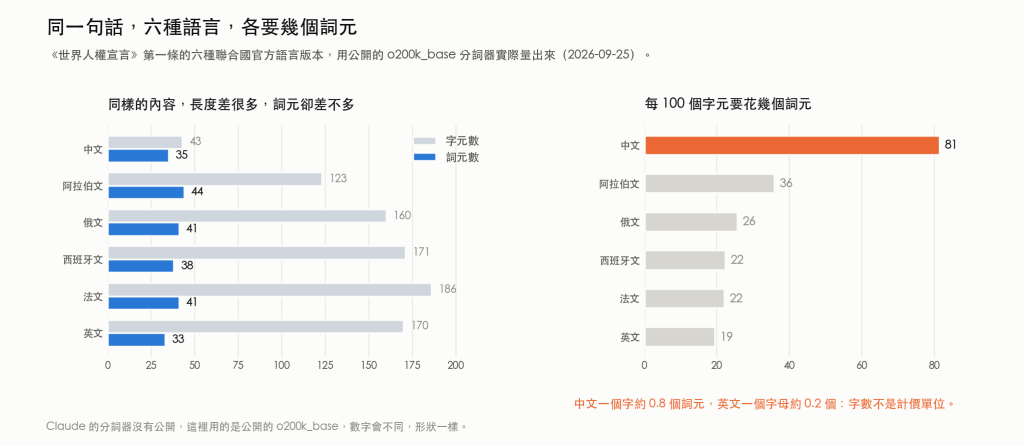
結果跟我原本以為的不一樣,有三件事值得記:
兩個要打折的地方:這用的是公開的 o200k_base,不是 Claude 的分詞器(官方沒有公開),數字會不同;而 Petrov 那篇的 15 倍是含低資源語言在內量出來的,不要拿去套在這六種語言上。
所以估成本不能靠數字數,要真的去量。官方文件講了三件實用的事(2026-09-25 查):
count_tokens 免費,但有自己的每分鐘請求上限,而且跟送訊息的上限是分開算的,所以量成本不會吃掉你正式呼叫的額度。model 重量一次。這一層剩下的篇幅不會再回來講詞元,但帳單上的每一格都是它。
帳單的形狀改不掉,但單價可以。這就是第 4 篇那個快取在這一層真正的用途。
官方定價表上,Claude Opus 5 是這樣(2026-09-25 查):
| 項目 | 每百萬詞元 | 相對於基本輸入 |
|---|---|---|
| 基本輸入 | $5 | 1x |
| 5 分鐘快取寫入 | $6.25 | 1.25x |
| 1 小時快取寫入 | $10 | 2x |
| 快取命中 | $0.50 | 0.1x |
| 輸出 | $25 | 5x |
官方自己給了回本的算法:5 分鐘那個版本命中一次就回本,1 小時那個要命中兩次。 對一段連續的對話來說,這個門檻低到可以直接當預設。
文件裡那個試算也很說明問題:Opus 5 吃掉 50,000 個輸入詞元,原價是 0.25 美元;如果其中 40,000 個是快取命中,那一段就變成 0.05 加 0.02,輸入的成本掉到原來的三成不到。
而快取能不能命中,取決於上一篇講的順序:穩定的在前,易變的在後。 對話歷史剛好是往後長的,所以它天生適合被快取,你要做的只是讓斷點跟著對話往後移,而不是讓前面那一段每輪都被你動到。
照上面那組假設,每一輪多 500 個詞元,要填滿 100 萬詞元的窗口得聊到兩千輪,聊不到。所以在純聊天的場景,先咬你的是錢,不是窗口。
但把場景換成代理就不一樣了:每一輪不只有一問一答,還有工具回傳的結果、檢索回來的那幾塊、貼進去的檔案。一輪吃掉一萬個詞元很常見,一百輪就滿了。
而且這件事在服務端也是個難題,不是只有你的帳單在痛。StreamingLLM(Xiao et al., ICLR 2024)開頭就點名多輪對話的兩個挑戰:快取前面那些詞元的鍵值狀態很吃記憶體,以及模型無法自動推廣到比訓練長度更長的文字。
那篇論文還有一個對我們很有用的發現:直接只留最近的那一段、把最舊的丟掉,會壞掉。他們觀察到模型會把很強的注意力放在最前面那幾個詞元上,即使那幾個詞元根本不重要,這個現象叫注意力沉降(attention sink);把那幾個留著,效果就回來了。
所以「歷史太長就砍掉最舊的」不是想砍就能砍。 這一層後面會專門處理這件事。
把這幾件事放在同一條長度軸上看,會比較清楚它們是怎麼對上的:
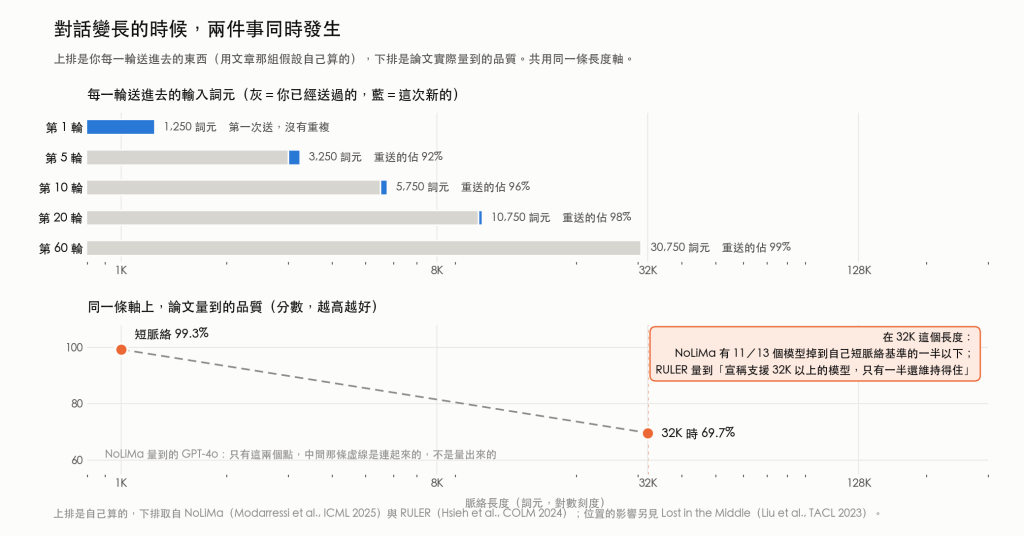
上排是你的工作流,下排是它的品質,兩排共用同一條刻度。 上排每一條的灰色部分就是這一篇在算的東西:重送的比例從第 5 輪的 92% 一路到第 60 輪的 99%。下排是第 9 篇引過的那兩份量測(RULER 與 NoLiMa)實際量到的分數,而它們量到落差的地方,剛好就是一段代理對話跑個幾十輪就會到的長度。
一句話:你付錢買的那條線一直往右長,而它用得好不好的那條線,在同一段路上是往下走的。(下排中間那條虛線是把兩個實測點連起來的,不是量出來的,別把它讀成一條平滑的衰退曲線。)
便宜不等於免費,更不等於不佔位置。 第 4 篇講過一句容易被忽略的話:快取的前綴仍然佔著窗口。快取改變的是你付多少錢,不是它算不算進窗口。上面那個代理的例子就是這樣撞牆的:錢還好,窗口先滿。
而且長對話本身就會讓品質變差。 第 6 篇的長度退化、上一篇引的那幾份長脈絡量測,講的都是同一件事:東西越多,它用得越差。所以「反正快取很便宜,就讓對話一直長下去」是一個會同時付兩次錢的做法:錢是小的那一份,品質是大的那一份。
所以長對話我現在的做法是這幾條:
| 做法 | 為什麼 |
|---|---|
| 系統提示定稿之後就不要再動 | 動一次,那一輪之後的快取全部重來 |
| 快取斷點跟著對話往後移 | 歷史是往後長的,斷點不跟著走,等於只快取到最前面那一小段 |
| 一段任務結束就開新對話 | 不是為了省錢,是為了第 6 篇講的長度退化 |
| 開新之前,把結論自己抄一份出來 | 這一條就是下一篇的題目 |
最後一列才是這一層真正的問題:這段歷史裡,有多少是值得留的? 二十輪對話裡,可能只有三句話之後還用得到,而你現在的做法是把那三句跟另外九十七句一起重送,每一輪都送。
多了什麼能力:你看得懂對話的帳單了。你知道輸入詞元為什麼會平方成長、98% 是重複的、快取命中一次就回本,也知道要用
count_tokens量而不是數字數。多付了什麼代價:一個隨著對話長度增加的成本,還有一個更難處理的:窗口會先滿。快取只讓重送變便宜,沒有讓它變短。
二十輪對話裡,真正值得留下來的可能只有三句話。
既然全部重送又貴又髒,那就只能挑。下一篇處理的就是那個挑法:哪一種東西值得留到下一次,哪一種留了反而礙事,以及為什麼「全部存起來」跟「全部重送」一樣不是答案。
count_tokens 免費、額度分開算、回傳是估計值,以及換模型要重量一次。


 iThome鐵人賽
 看影片追技術