
系列:30 天用 Google AI 打造臺灣防災速報 App(Day 14/30)
第二週完成 AI 核心的四項功能:速報摘要、警報分級、問答、多語速報;其中問答拆成工具查詢與知識庫兩個部分。這一篇整理它們目前的狀態、這週最重要的一條教訓,以及用實測的 token(模型計算文字量的單位,一個中文字大約一到兩個 token)數算出來的費用。
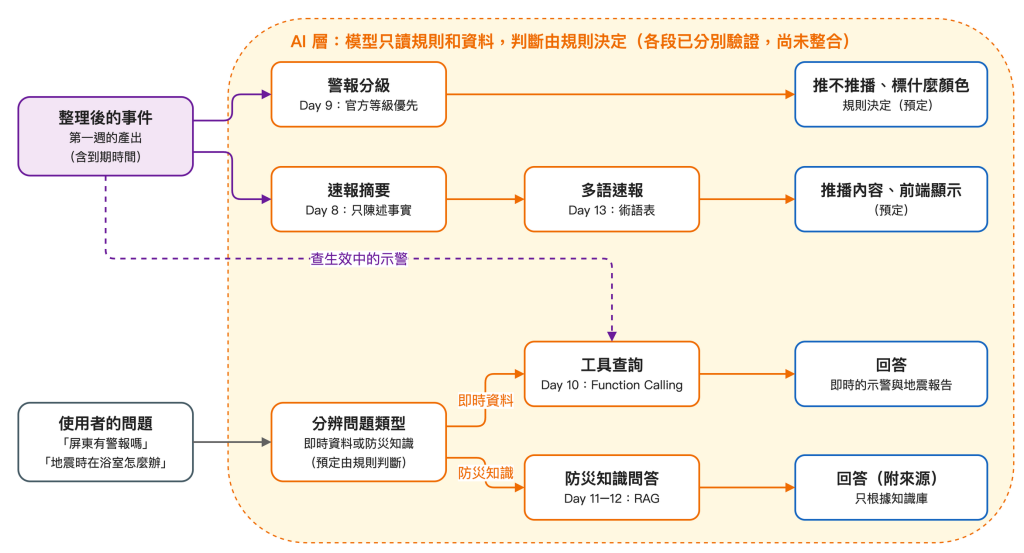
圖上是預定的串接方式。一則新示警進來,先分級,決定要不要推播、標什麼顏色;要推的話產生速報,再寫成多語版本。使用者的問題先分辨類型:問即時的示警或地震報告,走工具查詢;問防災知識,走知識庫。目前這幾段各自驗證過,還沒有接在一起,「推不推播」的規則和「分辨問題類型」的規則也還沒寫。四項功能都在同一個原則下:模型只讀規則和資料,判斷由規則決定。
問答拆成工具查詢和知識庫兩列,所以四項功能有五列。「主要的缺口」只列重點,各篇文末的清單更完整。
| 功能 | 做到的 | 主要的缺口 |
|---|---|---|
| 速報摘要(Day 8) | 四版 prompt,定稿版連續五次輸出相同,47 字,沒有原文以外的內容 | 官方有海嘯判定時由程式附加,還沒寫 |
| 警報分級(Day 9) | 六大類對照表寫進 prompt;CAP 電文有官方等級時直接採用,模型只在沒有時補位 | 水庫放流的影響縣市要另建對照表;只測了三個案例,還不算品質評估 |
| 工具查詢問答(Day 10) | 兩個工具(生效中示警、近期地震),五個問題全部正確;順帶補上示警的到期時間過濾 | 縣市用文字比對,之後改用行政區代碼;「比較大的地震」的門檻要寫進工具說明;伺服器忙碌時只做了簡單重試 |
| 防災知識問答(Day 11–12) | 29 塊官方語料,門檻 0.75,查不到就說查不到;情緒類問題由規則固定順序 | 只涵蓋地震、海嘯、災後心理;門檻只靠九題決定;情緒詞清單是手寫的,有漏判和誤判 |
| 多語速報(Day 13) | 一次產生四種語言;英文術語依中央氣象署英文網頁、格式依美國國家氣象局的白話標題與時區標示,日文、韓文依臺灣官方媒體日、韓文版的慣用寫法;數字與日文縣市由程式核對 | 日文、韓文還沒有請母語者逐句審核;韓文「大雨」與「豪雨」的區分還沒有找到權威寫法 |
每一項都有程式和實測紀錄,也都有明確寫下來的缺口。第三週上線時,這張表加上各篇文末的清單就是待辦事項。
同一件事這週發生了四次:
四次的修法不同,原則一樣:不要讓和這一次無關的固定文字出現在模型看得到的規則或資料裡。Day 8 刪掉那條規則,官方判定改由程式附加;Day 13 的標記改由程式加上;Day 13 的術語表只附原文用得到的條目;Day 12 則是把情緒類問題的求助電話另外寫清楚,不讓它和查無資料的規則混在一起。
另外兩條也是這週實測出來的:
9/24 把五項功能各呼叫一次,讀 API 回傳的 usage_metadata(每次呼叫的用量):
| 功能 | 輸入 token | 輸出 token | 每次費用(美元) |
|---|---|---|---|
| 速報摘要 | 307 | 49 | 0.00015 |
| 警報分級 | 508 | 148 | 0.00035 |
| 多語速報 | 297 | 245 | 0.00044 |
| 知識庫問答 | 631 | 132 | 0.00036 |
| 工具查詢問答(含一次工具來回) | 745 | 60 | 0.00028 |
單價依 Google 官方定價頁(2026-09-23 更新)的標準付費層:gemini-3.1-flash-lite 每百萬輸入 token 0.25 美元、輸出 1.50 美元。這五種呼叫每一次都不到 0.0005 美元。
用兩種情境估算:
防災速報的模型呼叫都很短,一次幾百個 token。還沒算進去的費用有 Cloud Functions 每 10 分鐘的執行和 Firestore 的讀寫,小流量可能落在免費額度內,第三週上線後再用帳單核對。
另外兩項也沒有算:知識庫建向量是一次性的(29 塊,可以忽略);每一次知識庫問答要把問題算成向量(gemini-embedding-2 每百萬 token 0.20 美元,一個問題約十幾個 token,可以忽略)。
第三週上線:把這兩週在本機上執行的程式搬上 Cloud Functions 與 Firestore,然後做 App 的畫面。明天 Day 15 從 Firestore 的資料模型開始。


 iThome鐵人賽
 看影片追技術