
Day 8 講過用一個團隊去想架構,那次的團隊是唯讀性質的,負責分析跟討論,全程不碰任何一行程式碼。今天想仔細講的是另外一種團隊,會真的動手改程式碼,而且是同時、平行地改,改的是完全不同、彼此不相關的功能。這件事聽起來非常誘人,一個人卻能像帶著好幾個工程師同時開工,實際做起來,真正卡住的地方,從來不是能不能開得起這麼多條線,是這些線彼此之間,會不會互相打架、互相拖累。
這兩種團隊的差別,我覺得值得先講清楚,免得混為一談。唯讀的團隊負責的是想法層面的事,幾個角色各自從不同角度分析同一個問題,最後產出的是一份給人看的判斷或規劃,過程中不會真的去動任何一行程式碼。今天要講的這種團隊,產出的是真正會被提交進版本庫的改動,風險完全不一樣,唯讀團隊想錯了,最多是白花一些時間重新想一次,動手改程式碼的團隊一旦處理不好,留下的卻是真的會影響到系統運作的東西,代價完全不在同一個等級上。
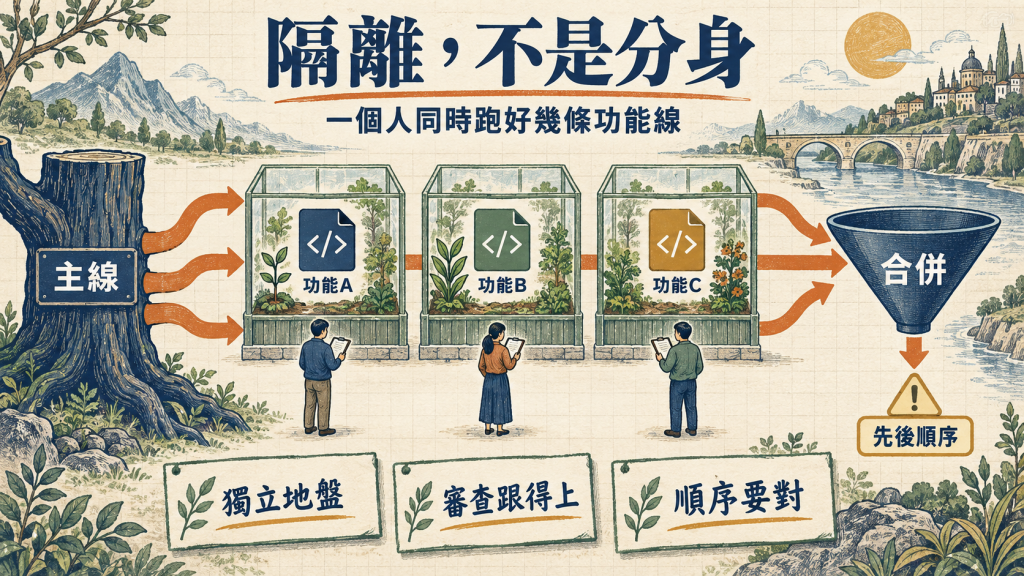
第一次嘗試同時跑兩個獨立的 Claude Code 工作階段,我犯了一個很直覺、事後想想卻相當低級的錯,兩個都硬是塞在同一個工作目錄裡跑。結果可想而知,一邊在改一個檔案,另一邊也在動同一批檔案,兩邊的改動互相覆蓋,最後誰也說不清楚,現在這個檔案的狀態,到底是哪一輪留下來的。
發現這個問題的當下,我第一個反應是覺得自己一定漏看了什麼警告或提示,回頭仔細檢查過整個過程,才發現根本沒有任何提示會主動告訴我,兩個工作階段正在同一批檔案上互相踩踏。這件事讓我深刻意識到,這種隱性的衝突,不會有任何系統跳出來主動提醒,完全得靠自己事先想清楚架構該怎麼設計,才能避免掉進這個陷阱,出了問題也只能靠自己回頭拆解,沒有現成的錯誤訊息可以直接指出問題根源,只能一步一步倒推回去,慢慢拼湊出真相。
後來反覆想過好幾次才真正想通,平行工作的前提,是每一條線都得有自己完全獨立的地盤,不能共用同一份正在變動的檔案狀態。實際做法是幫每一個功能開一個獨立的工作目錄,各自對應到同一個版本庫底下不同的分支,彼此的檔案系統完全分開,互不干擾,一邊怎麼改,都不會影響到另一邊正在看的內容。這種做法讓每個工作階段都活在自己完全獨立的世界裡,直到真的要合併的那一刻,才需要正面處理彼此的交集。
這種獨立工作目錄的機制,本質上是把同一個版本庫,同時攤開成好幾份完整的副本,每一份都指向不同的分支,彼此互不影響,卻又共用同一份底層的版本歷史。這件事一開始聽起來有點反直覺,同一個版本庫怎麼會同時存在好幾份可以獨立修改的副本,實際理解之後才發現,這正是它最巧妙的地方,不用真的複製整份程式碼,也能做到完全隔離的效果,省下的磁碟空間跟同步的麻煩,比想像中大很多。
第一次設定這種獨立工作目錄的時候,我還特地多花了點時間確認過,這些看起來獨立的副本,最後合併回去的時候,會不會因為底層共用同一份歷史而出什麼問題。實際反覆用過幾次之後才真正放心下來,共用歷史反而是件好事,因為合併的時候,系統能夠準確追蹤每一條線各自是從哪個時間點分岔出去的,這種追蹤能力,是靠複製整份程式碼、各自獨立維護版本紀錄的做法完全比不上的,這也是我後來越用越安心的原因。
這件事聽起來像是基本常識,實際踩過一次才真正記住教訓。獨立的地盤解決的從來不是效率問題,是正確性問題,沒有這道隔離,平行帶來的不是加速,是製造混亂,兩條本來各自進展相當順利的功能線,會因為共用同一份檔案狀態,變成誰都不完整、誰都不可信、誰也說不清楚真相。
這件事也讓我想起前面反覆講過的一個判準,遇到共用狀態的地方,出手前要先確認清楚,不能想當然耳地以為對方一定已經處理完了。第一次踩到這個坑,就是因為我以為另一條線已經告一段落,才放心地在同一個地方動手,結果對方其實只是暫時停下來思考下一步,並沒有真的收工。這種誤判造成的混亂,比單純技術上的錯誤更難排查,因為表面上看起來程式邏輯完全沒問題,問題出在兩份不該混在一起的狀態被攪和到了一起。
決定好隔離的做法之後,下一個問題是要同時開幾條線。我自己一開始很興奮,覺得既然可以平行,那就盡量開,開到五條、六條,看看極限到底在哪裡,好像開得越多就代表這套做法越成功。實際跑下來才發現,真正的瓶頸從來不是能不能開得起這麼多個工作階段,是自己有沒有辦法把每一條線的產出都認真、仔細地看過一遍。
開到三條線以上,我就開始很明顯感覺到自己在切換注意力上的損耗,這條線剛看完,換去看另一條,腦子還沒完全切換過來,很容易漏掉一些原本一眼就能看出的明顯問題。這種損耗不會反映在任何進度指標上,表面上看起來每一條線都在往前推進,實際上審查的品質已經在悄悄下滑。
這種切換的損耗特別隱蔽,是因為它不會讓任何一條線明顯卡住不動、徹底停擺,每條線都還是持續有進展,只是每一次審查看得沒那麼仔細。這種隱蔽性讓人很容易忽略問題正在累積,直到某一條線真的出了明顯的錯,回頭檢視才發現,早在好幾輪之前,審查的時候其實已經有跡象,只是當時注意力被分散到別的線上,沒有認真看進去,那個跡象就這樣被輕輕放過了。
從那次經驗之後,我會把自己能穩定跟上的線數,控制在兩到三條之間,這不是一個絕對的數字,是我自己審查能力能負荷的範圍。真正該問的問題,不是這個工具允許我開幾條線,是我自己有沒有辦法對每一條線的產出負起責任。答案是負不起,就該收斂線數,不該為了展示自己能同時做多少事,硬撐著開更多。
這個上限,我覺得每個人都會不太一樣,也不是一個能直接抄過來用的固定數字,跟對這個系統的熟悉程度、跟這幾條線本身的複雜度都有關係。熟悉的系統、單純的改動,能同時跟上的線數自然可以拉高一點,陌生的系統、牽涉複雜邏輯的改動,就算只開兩條線,都可能已經超出自己審查得過來的範圍。這個數字不是一次定下來就不變,得依照當下的狀況隨時調整,過度自信地照搬上一次覺得游刃有餘的線數,換一個更複雜的場景,很容易就撐不住。
我自己現在會用一個很簡單、也很容易重複執行的方式測試自己當下的上限,先只開一條線,看自己能不能一邊做著手上原本的其他事、一邊還能輕鬆跟上這條線的進度。如果連一條線都覺得吃力,那天顯然就不是適合開平行線的狀態,勉強加開只會讓整體的品質一起往下掉,得不償失。反過來,一條線覺得游刃有餘,再嘗試加開第二條,用這種漸進的方式,慢慢摸出當下這個狀態、這個系統、這批任務,真正適合的線數,而不是憑著上一次的印象直接套用,硬把不同情境當成同一種情境來處理。
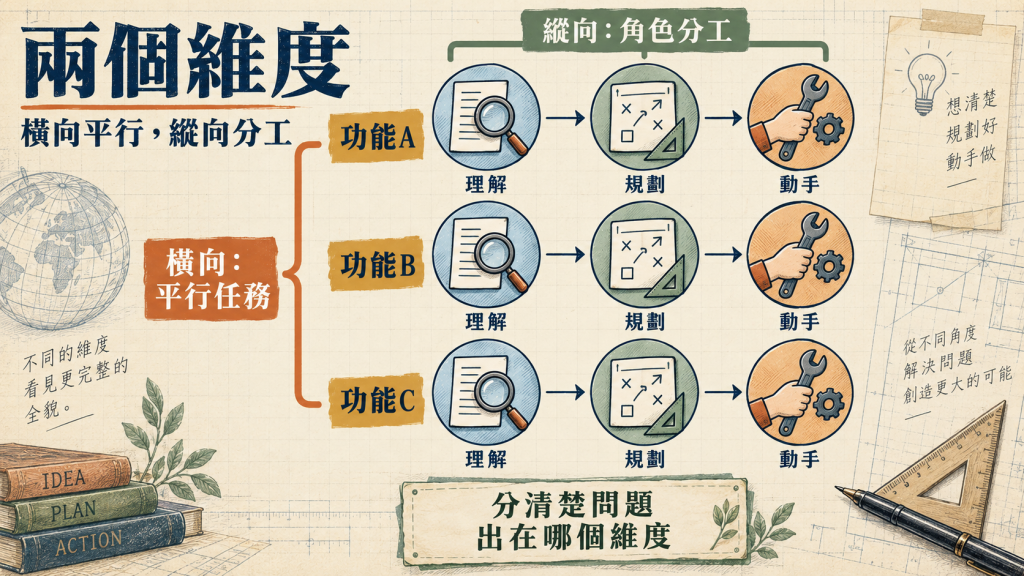
平行開的這幾條線,彼此之間各自獨立,但每一條線裡面,其實還是可以套用團隊分工的做法,這件事一開始並不是我刻意設計出來的,是實際做的時候自然而然發現的。一條負責新功能的線,動手改程式碼之前,還是可以先讓一個角色去讀懂現有的程式碼結構,再讓另一個角色根據理解去規劃步驟,最後才是真正動手實作跟自我驗證。這件事跟 Day 8 講的團隊分工是同一套邏輯,只是規模縮小到單一條功能線裡面,換了個場景重新套用一次。
有意思的是,把角色分工塞進單一條線裡之後,整個系統看起來的層次感一下子變得清楚很多,最外層是好幾條平行的功能線,各自處理不相關的任務,往裡看,每一條線內部又有各自的角色分工,負責理解、規劃、動手這幾個階段。這種層層套疊的結構,讓我想起前面反覆講過的模型資源分層,資源該花在哪裡、花多少,永遠取決於當下這一層要處理的是機械性的事、還是需要判斷力的事,不管拉到多高的層次去看,這個判準始終適用,不會因為換了場景就失效。
我第一次刻意這樣套用的時候,其實是抱著半信半疑的實驗心態,想確認縱向的角色分工,在橫向平行的環境裡會不會因為資源更緊繃而變得不管用。實驗下來得到的結果是,縱向分工不但沒有變得不管用,反而在平行的情境裡更顯得必要,因為每一條線裡如果沒有先做好角色拆分,直接讓單一個角色從頭做到尾,出錯的機率反而會比單獨一條線在跑的時候更高,因為整體的注意力本來就已經被拆分給了好幾條線,每一條線內部更需要有自己一套把關的機制,不能只靠外部的人力去補這個缺口。
這種巢狀式的分工讓我理解到,平行開發跟團隊分工,其實是兩個不同維度的事,一個是橫向的,同時處理幾件不相關的事,一個是縱向的,把單一件事拆成幾個角色分頭做。這兩個維度可以同時疊加,橫向開三條線,每條線內部又各自有縱向的角色分工,前提是自己得清楚知道現在在哪個維度上做判斷,不要把兩個維度的問題混在一起想。
混在一起想最容易出現的狀況,是把橫向線數不夠的問題,誤判、錯當成縱向分工不夠細緻的問題去解決,或者反過來。舉個實際發生過的例子,我曾經覺得某一條線做得特別慢,直覺反應是這條線裡面的角色分工還不夠細,於是又多拆了一層,結果多拆一層之後,那條線非但沒有變快,反而因為多了一道切換的成本而更慢,回頭一查才發現,慢的真正原因,其實是我自己同時開了太多條橫向的線,分身乏術才拖慢了這一條,跟縱向分工細不細一點關係都沒有。分清楚問題到底出在哪個維度,才不會用錯方向的解法,去修一個原本就診斷錯的問題。
隔離工作目錄解決了檔案層面的衝突,但還有一種共用資源,比檔案更容易被忽略,像是本機跑著的開發伺服器、或者瀏覽器裡開著的分頁,這些東西通常只有一份,沒辦法像檔案一樣輕易複製出好幾份獨立的版本,也很容易被誤以為已經跟其他線徹底隔開了。
我自己吃過一次虧,兩條線同時在跑,其中一條正在測試一個牽涉到前端畫面的改動,我在另一條線還沒確認狀態的時候,就手動切換了同一個開發伺服器指向的分支,結果那條線接下來測出來的畫面,其實是兩邊改動混在一起的產物,我卻把這個混亂當成一個新發現的錯誤,花了不少時間想查出一個根本不存在的問題。
回頭想這次經驗,最讓我在意的其實不是切換分支這個動作本身,是我當下完全沒有意識到,這麼一個看似無害的動作會影響到另一條線。獨立的工作目錄給了我一種錯覺,覺得兩條線已經徹底隔開了,這種錯覺讓我忽略了還有一些資源,是兩條線共用的,工作目錄的隔離管不到這些地方。這種盲點特別危險,因為它藏在一個看起來已經做對了的安全感底下,隔離做得越徹底,越容易讓人放鬆對共用資源的警覺,覺得自己已經把該防的都防住了。
這件事讓我養成一個新習慣,動共用資源之前,先確認每一條平行線目前的狀態,是真的停下來了,還是只是暫時沒有動作,看起來安靜不代表真的可以放心去動它。真的需要做這種跨線的對照測試,我會另外開一個完全獨立的環境,不會直接借用某一條線正在使用中的資源,這個習慣看起來麻煩一點,換來的是不會把自己的操作誤判成程式的問題。
這個習慣也延伸出另一個更具體的做法,我會事先把哪些資源是每條線各自獨立、哪些資源是全部共用的,列成一張清單,心裡有數。獨立的部分可以放心讓每條線自由發揮,共用的部分,動手前一律多想一步,先確認會不會影響到正在跑的其他線。這張清單一開始列起來有點瑣碎,但列過一次之後,之後每次要開新的平行線,都可以直接照著檢查一遍,不用每次都重新想一遍到底哪些東西是共用的。
老實講清楚一點,平行開發並沒有讓任何一條線本身變得更快,一條功能線需要多久做完,還是差不多的時間,平行真正省下來的,是原本得排隊等待的那段空檔。以前一條線做著做著卡在等驗證結果、或者等某個外部流程跑完,這段等待的時間如果只做一件事,就是純粹浪費掉了,開了平行的線之後,這段空檔可以拿去推進另一條線,等待不再是純粹的浪費。
這個發現一開始讓我有點意外,原本抱著很直覺的期待,以為平行開發的價值在於加速,後來才明白它真正解決的是資源閒置的問題,而不是縮短單一任務本身需要的時間。這兩種效益聽起來很像,實際帶來的期待完全不同,如果抱著「開了平行線,事情就會變快」這種期待去用,很容易在某條線本身進展緩慢的時候感到挫折,因為那條線本身的速度,從頭到尾都沒有變。真正該關注的指標,是自己整體一段時間內總共完成了幾件事,而不是單一件事到底花了多久。
換成用整體完成的件數當指標之後,我對「進度緩慢」這件事的焦慮感明顯降低不少,因為就算其中一條線卡在等待,只要另外幾條線還在往前推進,整體來看,這段時間並沒有被浪費掉。這種心態上的轉變,某種程度上也讓我更能忍受單一件事本身的不確定性,不會因為一條線暫時卡住,就急著介入催促,反而更願意讓它照著自己該花的時間走完,同時把心力放到還有進展空間的其他線上。
這個道理讓我重新理解,平行開發真正該用在什麼場景,不是用來讓單一件事變快,是用來把原本分散在時間軸上、彼此不相關的多個任務,塞進同一段時間裡一起處理。如果手上只有一件事、而且這件事沒有明顯的等待空檔,硬要開平行線,只會讓自己多一份管理的負擔,換不到真正的效率提升。
判斷值不值得開平行線,我現在會先問自己一個很具體的問題,手上這幾件事之間,有沒有明顯的等待空檔可以互相填補。如果每件事都是連續不斷需要盯著的,中間沒有留白,開平行線只是把自己逼成同時盯著好幾個畫面,注意力被拆得更散,反而比一件一件做還要沒效率。反過來,如果每件事都有一段需要等待的時間,平行開好幾條線,正好可以把彼此的空檔填滿,這種情況下平行開發才真正划算。
實務上判斷有沒有等待空檔,其實不難,我會回頭看這件任務裡有沒有那種丟出去之後,自己暫時插不上手、只能等結果的環節,像是等一段比較長的驗證跑完、或者等某個外部服務回應。這種環節越多,代表這件任務本身留白的機會越大,越適合搭配其他任務一起平行處理。反過來,一路都需要自己盯著、隨時介入判斷的任務,留白很少,硬要湊進平行的組合裡,效果通常不會太好。
平行開的每一條線各自完成之後,最後都得合併回同一個主線,這一刻才是真正檢驗這整套做法有沒有做對的時候。如果每條線在隔離的環境裡都改了同一批共用的核心邏輯,合併的時候免不了要處理衝突,衝突處理得好不好,直接反映出當初分工的時候,有沒有把每條線的邊界劃清楚。
這件事也讓我體會到,隔離的環境會製造一種很容易讓人放心的假象,讓每一條線在自己的世界裡看起來都完成得很順利,測試也都通過,一切正常。這種順利感容易讓人誤以為合併回去也會一樣順利,實際上每一條線通過測試,測的都只是它自己那個孤立的版本,沒有人能保證幾條線的改動疊在一起之後,還是一樣正確、一樣不出岔子。合併這一刻,才是第一次真正檢驗這幾條線放在同一個世界裡,彼此相容不相容的時候,過程中出現摩擦,反而是正常的,不代表當初哪一步做錯了,只代表這幾條線終於第一次真正碰面。
分配任務給哪一條線之前,我也會先粗略估算一下,這幾件任務彼此之間到底有多獨立,這個估算做得準不準,會直接影響到後面合併時的順不順利,估算得越仔細,後面省下來的麻煩就越多。完全不相關的功能,像是一條線在處理介面呈現、另一條線在處理後端資料邏輯,這種組合平行起來風險最低,因為兩邊本來就不太會碰到同一批檔案,天生就是適合平行的一組搭配。反過來,兩件任務如果本質上都圍繞著同一段核心邏輯在做調整,就算表面上看起來是兩個不同的功能,實際平行開發起來,衝突的機率會高出很多,這種情況我會傾向讓其中一條先做完、確認穩定之後,另一條再接著開始,而不是勉強湊在一起平行,硬湊出來的平行只會讓兩邊都做得綁手綁腳。
我自己現在分配線的時候,會特別留意每條線牽涉到的檔案範圍,重疊的部分越少越好。真的沒辦法完全避開重疊,我會刻意排出合併的先後順序,讓比較核心、比較容易牽動其他部分的那條線先合併回去,其他線再回頭根據合併後的最新狀態調整。這個順序安排,某種程度上跟前面講過的先確認機械性基礎、再處理判斷性問題,是同一種思路,先讓最底層、最多人會依賴的東西穩定下來,再讓其他部分往上疊加。
決定順序的時候,我會特別留意有沒有哪一條線動到了其他線都依賴的共用邏輯,這種線通常最該優先合併,因為它一旦合併進去,其他還在進行中的線很可能都需要重新對照最新的狀態,越晚合併,其他線要重新對照的落差就越大,處理起來也就越麻煩。反過來,範圍完全獨立、不影響任何共用邏輯的線,合併順序放在後面也沒什麼風險,可以留到最後再處理,不用急著搶第一個進去,先後順序對它來說沒什麼太大的差別。
回頭把這幾件事全部串起來看,我發現自己真正想講的,不是平行開發這個技巧本身有多厲害,是這個技巧反而讓我更清楚意識到,能力上限跟該用到什麼程度,是兩回事。工具允許我同時開很多條線,不代表我就該一路開到工具所允許的極限,真正該問的問題,是自己審查得過來嗎、共用資源管理得住嗎、合併回去的時候真的處理得乾淨嗎。這幾個問題的答案,決定了合理的線數究竟是多少,而不是工具本身的技術上限,這件事怎麼強調都不為過。
這種區分讓我想起自己在其他很多場景也反覆遇到的同一種誘惑,工具能力越強、看起來越好用,越容易讓人不自覺地想把它用到極限,好像不用滿就是浪費,就是沒有把工具的價值發揮到底,白白辜負了它的能耐。實際上工具的能力上限跟自己該負責的範圍,從來不是同一條線,工具能做到的事,遠遠超過我一個人能認真把關的範圍,硬要把兩者拉到同一個水位,換來的不是效率最大化,是品質悄悄地被犧牲掉,只是這種犧牲不會立刻反映出來,要等到某一次真的出錯,才會被發現,而那個時候往往已經付出了不小的代價。
這種先問自己能不能負責、再決定要不要動用某項能力的習慣,回頭仔細看前面講過的每一件事都貫穿著同一條線,不管是模型資源的分層、審查流程的規模化、還是規則檔的維護,核心都是同一句話,能做的事跟該做的事,不是同一回事,分清楚這兩者,比學會任何一項具體技巧都重要。
一個人靠著隔離、分層、跟願意誠實承認自己真正能負責的範圍,可以把事情做到相當高的規模,這個上限比一開始想像的要高出不少,遠比單打獨鬥這四個字給人的刻板印象還要大得多。這件事讓我更有把握相信,資深工程師真正的價值,從來不是能不能一個人做完所有事,是知道什麼時候該收斂、什麼時候該借助工具放大自己的產能,而且始終清楚知道,放大之後責任還是完完全全落在自己身上,不會因為工具做得多,就有任何一部分可以不用負責、可以推給工具。
這種責任感,我覺得才是真正決定平行開發最後做得好不好的關鍵因素,遠比懂不懂那些技術上的操作細節都還要重要得多。工具的用法可以很快學會,怎麼開獨立的工作目錄、怎麼安排合併順序,這些都是可以照著步驟練熟的技能。真正難的,是願意持續誠實面對自己審查能力的極限,開到第三條線就已經吃力,就老實承認自己吃力,不會因為別人開了五條線、看起來很厲害,就跟著硬撐下去。這種誠實,比任何一項具體的操作技巧都更難長期維持,也更容易在不知不覺中被虛榮心悄悄取代。
看到別人在網路上大方分享自己同時跑了多少條線、產出了多少功能,很難不受到一點影響,心裡難免會浮現一種要不要也跟著多開幾條的念頭,好像不這樣做就顯得自己跟不上。這種比較心態,我覺得是平行開發這個技巧裡,最容易讓人不小心栽跟頭的地方,因為別人能負荷的範圍,跟自己能負荷的範圍,本來就不會一樣,套用別人的線數,等於是拿別人的極限,硬套在自己身上,這種比較從一開始就搞錯了比較的對象,也搞錯了真正該追求的東西是什麼,追求的從來不該是數字,是自己對每一條線都負得起責任。


 iThome鐵人賽
 看影片追技術