
Day 18 結尾留下的問題是:規則能被機械執行之後,執行層的錢到底有沒有變便宜。我先去翻派工規則,那句話其實早就在了:機械性的批次工作,派給便宜的執行者。再去翻紀錄,2026-09-21 到 09-27 這七天共 674 筆派工,依模型算,Sonnet 135 筆、Haiku 3 筆,換算下來約占筆數兩成;兩者在等價成本上的占比是 10.4%。筆數占比和金額占比各走各的,看起來像規則有在運作。可是當我追問「這兩成裡,有多少是因為規則寫死了才派下去的」,紀錄答不出來。
我把同一週的派工再依角色與任務類別拆開。Sonnet 執行者做機械類任務 84 筆,等價成本紀錄值 85.37 美元;Opus 執行者做判斷類任務 57 筆,紀錄值 206.61 美元。筆數多的那格錢少,筆數少的那格錢多,脫鉤得很乾淨。同一週 674 筆裡,Opus 家族仍占 507 筆,另 29 筆屬其他模型。
我第一個反應是寫下「降階有效」,然後去查了一個欄位:派工稽核紀錄裡有一欄專門記「這筆原本派給誰、後來升階到誰」,設計目的就是追蹤便宜模型做不動、改交貴模型的情況。查詢結果是 0 列。全期沒有任何一筆升階落值。
這代表兩件事。第一,我無法證明那 84 筆機械類「本來會派給 Opus、被規則攔下來改派 Sonnet」,它們也可能從一開始就會派給 Sonnet。第二,我也無法知道便宜模型做壞了多少、有沒有被默默重做。筆數與金額脫鉤不等於降階成功,它只說明兩類任務的單價不同,而單價不同本來就是模型定價的結果,不需要任何規則。
問題藏在規則的字面上。「機械性的批次工作」很容易被讀成「比較小的工作」:查一個行號、跑一次搜尋,這種小事派給便宜模型毫無負擔。但真正值得降階的是另一種:量很大、耗時很長,可是每一步的做法都能逐條寫死——依固定格式填四十筆表、對三十個檔案各跑同一個檢查、照一份改法清單逐條修改。這種工作看起來「大」,主控的直覺是交給最可靠的 Opus 執行者,因為派貴的在當下永遠不會錯。
反過來,一件很小但需要判斷的事——這筆異常算不算真的異常——交給便宜模型,它會給一個語氣篤定的答案,錯了還得事後複核。
所以區分標準不是大小,是規則有沒有寫死。而規則寫在派工規則檔裡、由主控自己在派工當下判斷要不要遵守,它就只是一句建議。
第一條路徑是兩段式稽核。它把「看過每一筆」和「裁決有問題的筆」拆給兩個不同價位的執行者:
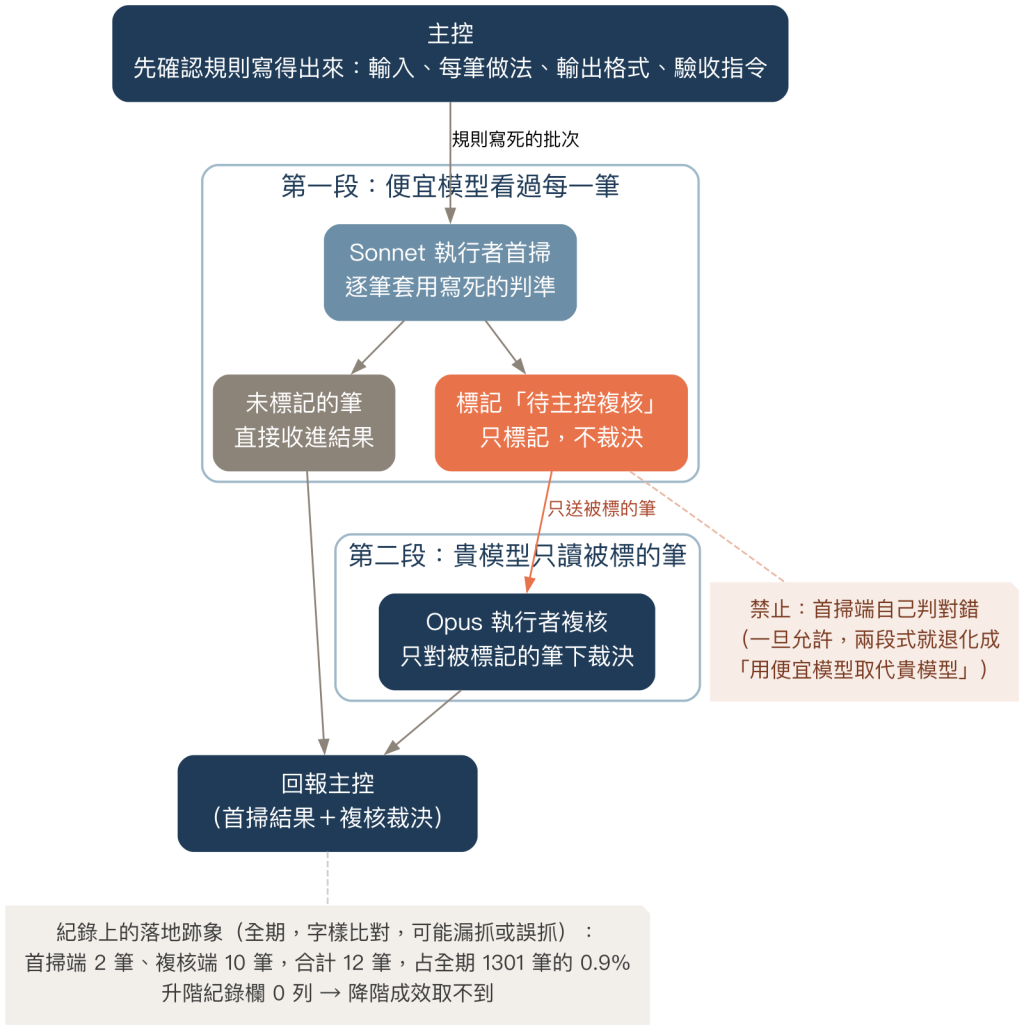
首掃端只准標記、不准裁決;貴的模型只讀被標出來的那幾筆。紀錄上能找到的落地跡象很少,升階紀錄欄則是空的。
這條路徑在紀錄上的痕跡很淡。描述或標籤帶有首掃、複核字樣的派工,全期只有 12 筆:Opus 執行者 10 筆、Sonnet 執行者 2 筆,占全期 1301 筆的 0.9%。字樣比對可能漏抓沒寫關鍵字的兩段式派工,也可能誤抓。樣本這麼小,我只能說它存在、被記錄下來,不能拿來推任何幅度。
第二條路徑是外包:把規則寫死、一次就能做完的任務,丟到另一個帳號的隔離環境裡,用單輪即滅入口跑完,只帶回一份回報。
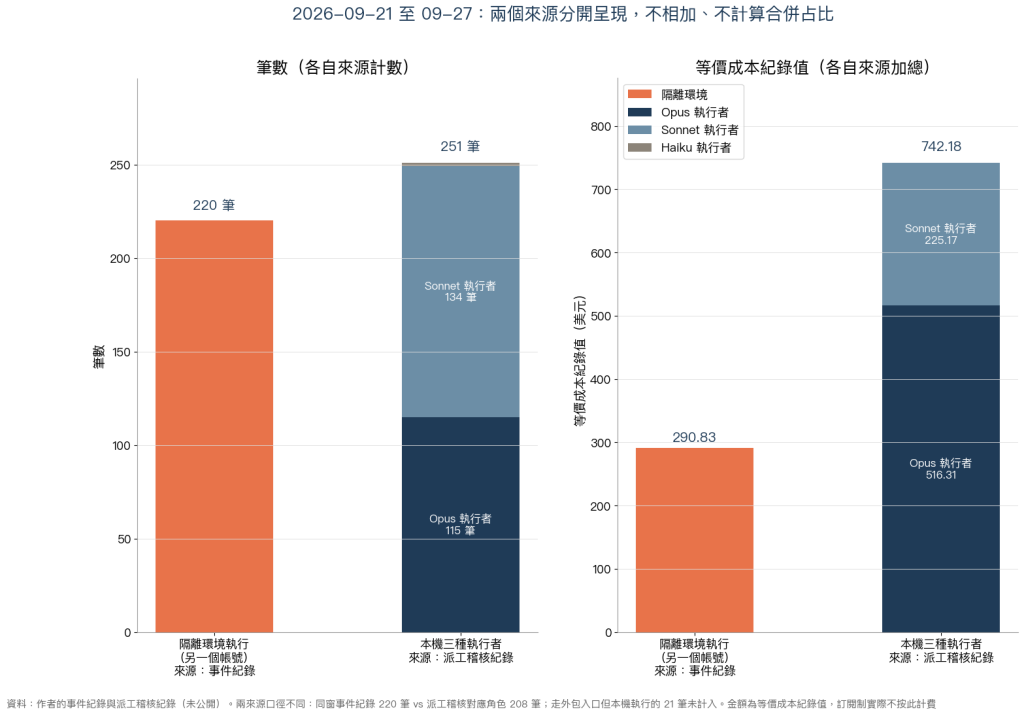
時間窗 2026-09-21 到 09-27。左右兩根來自不同的紀錄來源,刻意不堆在一起、不算合併占比。
同一個時間窗,隔離環境執行 220 筆,等價成本紀錄值 290.83 美元,這個數字來自事件紀錄;本機三種執行者 251 筆(不含審查員與中層),紀錄值 742.18 美元,來自派工稽核紀錄。兩者單筆平均的紀錄值分別是 1.32 與 2.96 美元。這一篇的金額都出自派工稽核紀錄與事件紀錄:前者每一筆的金額和 token 從同一份執行者紀錄一起算出,後者不經過事後回填,Day 15 查明的那筆口徑落差不影響它們。它們仍然只是等價成本,而且本機這一側的花費已經算進逐輪用量紀錄的紀錄值,不能再跟那邊的數字相加。
這兩個數字我不相加,也不算「外包承接了百分之幾」。理由很具體:同一窗內,事件紀錄記到的隔離環境執行是 220 筆,派工稽核紀錄裡對應的外包角色卻是 208 筆,差了 12 筆。兩邊不是同一套計數,硬湊成一個分母,得到的比例看起來精確,其實沒有意義。另外還有 21 筆走外包入口、卻在本機執行的紀錄,兩側都沒算進去。
能確定的是品質面:隔離環境的 220 筆裡,217 筆正常結束。以及量的面:9 月 21 日之前,隔離環境累計只有 93 筆;那段時間長度與本窗不同,我只列事實,不換算成速率。
我最後把降階拆成三個動作。
一、先問規則寫不寫得出來。 派工前,主控要能把這件事寫成「輸入是什麼、每筆做什麼、輸出長什麼樣、用哪個指令驗收」。寫得出來,它就是機械工作,不論多大都派 Sonnet 執行者或丟外包;寫不出來、需要邊看邊決定,它就是判斷工作,不論多小都派 Opus 執行者。
二、首掃不准裁決。 兩段式裡最關鍵的限制在首掃端:Sonnet 執行者只能標「待主控複核」,不能自己判對錯。一旦允許它裁決,兩段式就退化成「用便宜模型取代貴模型」,而那正是小而需要判斷的任務最容易出事的地方。
三、閘要擋在派工之前。 Day 18 講過派工前檢查。這裡用的是同一套機制裡管路由的部分:派工送出前比對派工內容與目的地,該外包卻派回本機、該走審查路由卻派給執行者,就直接擋回,要主控改派。它不是提醒,是不給過。
第三點是整件事能發生的原因。規則寫在檔案裡的時候,主控每一次派工都在做一個微小的選擇:多想一下規則,或直接派最穩的那個。後者在單筆上永遠說得通。閘的作用就是在路由上把「偷懶」這個選項拿掉,讓遵守規則成為唯一能走的路。
閘比對的是派工內容,不看任務類別;而任務類別是誰填的?是主控自己,在派工當下。
Sonnet 執行者全期 339 筆,標成機械類的 222 筆,占 65.5%;類別空著的 105 筆,占 31.0%;標成判斷類的只有 2 筆,其餘 10 筆是別的類別。更細一層、原本打算用來區分「規則是否真的寫死」的欄位,339 筆全部是空值。換句話說,閘能確保「該外包的不留在本機」,卻無法確保「真正機械的都被標成機械」。那道最關鍵的判斷——這題到底算不算機械——仍然落在最想偷懶的那個位置上。
同一個主控既當選手又當裁判。再加一道閘也沒用,閘只會照著主控寫下的內容走;缺的是一個沒有我這份 context、會問我不會問的問題的旁觀者。
明日預告:Day 20|第二意見:把另一個 CLI agent 當顧問,而不是第二個執行者


 iThome鐵人賽
 看影片追技術