
DAY 18 完成第二輪需求變更後,PM、Research、Creative 與 Finance 都提出了新的意見。不過,資料仍散在不同 Agent 的回覆裡,還看不出最後採用哪一個方案。
今天加入 PM 的整合流程,讓它讀取兩輪摘要與重要原文,整理成固定格式的提案草案。同時新增 Discord /draft 指令,負責觸發整合並顯示摘要。
integrate()
meetings.json
/draft
第一輪討論
    ↓
需求變更與第二輪討論
    ↓
/draft
    ↓
MeetingManager 整理兩輪資料
    ↓
PMAgent.integrate()
    ↓
Pydantic 驗證輸出
    ↓
保存草案並建立 Discord Embed
原本的 PMAgent.respond() 用來拆解單次需求。這次新增 integrate(),專門處理兩輪討論:
async def integrate(self, meeting_input: str) -> PMProposalDraft:
    return await self._proposal_agent.respond(meeting_input)
兩個方法共用同一個 LLMService,但使用不同的 System Prompt 與 Schema。
| 方法 | 用途 |
|---|---|
respond() |
整理目標、限制、工作項目與分歧 |
integrate() |
整合兩輪討論並記錄取捨 |
整合用的 Prompt 會要求 PM 處理互相衝突的意見,不能只把各 Agent 的回答重新排列。
草案使用 PMProposalDraft、PMProposalSections 與 PMDecision 驗證。輸出包含標題、摘要、五個章節,以及重要決策:
{
  "title": "提案標題",
  "summary": "草案摘要",
  "sections": {
    "background_and_goal": "專案背景與目標",
    "integrated_solution": "整合方案",
    "execution_plan": "執行計畫",
    "risks_and_responses": "風險與對策",
    "acceptance_criteria": "驗收標準"
  },
  "decisions": [
    {
      "topic": "決策主題",
      "decision": "折衷",
      "reason": "取捨原因",
      "sources": ["Finance Agent 第 2 輪"]
    }
  ]
}
decision 只能是「採用」、「拒絕」或「折衷」。sources 則保留 Agent 名稱與輪次,之後才能回頭確認這項決策來自哪一段討論。
Meeting Manager 設定的單次回覆上限是 4,000 字,只在 Prompt 寫「請簡短回答」不夠可靠,所以 Schema 也限制欄位長度:
測試會建立各欄位都填滿的草案,確認轉成 JSON 後仍不超過 4,000 字。
create_proposal_draft() 不會直接把整份 meetings.json 丟給模型。它先檢查會議是否完成、兩輪資料是否齊全,再由 _build_proposal_input() 挑出:
每輪摘要最多保留 1,400 字,重要原文則限制在 220 字。這樣 PM 仍看得到意見來源,Prompt 也不會一直膨脹。
如果 proposal_draft 已有資料,程式會直接回傳舊草案,不再呼叫模型。同一場會議因此不會因為重複執行 /draft 而產生另一個版本。
MeetingRecord 新增一個欄位:
proposal_draft: dict[str, object] | None = None
尚未建立草案時是 null。成功後,標題、摘要、五個章節與決策紀錄都會寫入這裡。舊資料沒有這個欄位時仍可讀取,預設值會是 None。
/draft 只能在 Discord 伺服器使用。指令先以 defer(thinking=True) 回應,再請 Meeting Manager 建立草案:
proposal = await discussion_manager.create_proposal_draft(
    interaction.guild_id
)

await interaction.followup.send(
    embed=format_proposal_embed(proposal)
)
Embed 只顯示標題、摘要、三種決策的數量與主要決策。完整五個章節留在 meetings.json,避免 Discord 訊息太長。
前幾次實測時,我常遇到 Agent 思考太久,或輸出 Token 用完,最後只看到錯誤訊息。如果沒有其他紀錄,很難判斷是執行逾時、輸入內容太長,還是模型輸出碰到上限。
因此,這次替每個 Agent 加入思考時間與文字用量統計,並由 MeetingStepRecord 保存:
input_characters: int | None = None
output_characters: int | None = None
prompt_tokens: int | None = None
completion_tokens: int | None = None
max_output_tokens: int | None = None
execution_time_seconds: float | None = None
Meeting Manager 以 len() 計算輸入與輸出字元數,保留 Ollama 的 Token 統計,再用 time.perf_counter() 計時。成功、失敗或取消都會保存耗時。
Discord 的第一輪與第二輪訊息會顯示這些資料:
第 1 輪 1/4 PM 需求拆解(<耗時> 秒)
📊 輸入 <字元數>/6,000|輸出 <字元數>/4,000
Prompt Token <數量>|輸出 Token <數量>/<上限>
使用量達 80% 時會顯示 ⚠️,達到 95% 則顯示 🚨,方便我在真正發生錯誤前先注意異常。
/draft 也會使用 ProposalMetrics 保存統計。草案建立完成後,Embed 底部會顯示輸入/輸出字元、Prompt Token、輸出 Token 與整合耗時。如果建立失敗,錯誤訊息也會附上已等待的時間。
舊的會議紀錄仍可正常載入,不過不會自動補上這些資料,必須重新執行 Agent 才會產生統計。
一開始 PM 整合沿用 Agent 的 60 秒預設逾時,結果在內容還沒產生完之前就被取消。這表示整合兩輪資料需要更長的等待時間。
因此,只有 PM Integration Agent 改成 180 秒:
timeout_seconds=180.0
其他 Agent 仍維持原本設定。這次調整也加入測試,避免之後又意外改回 60 秒。
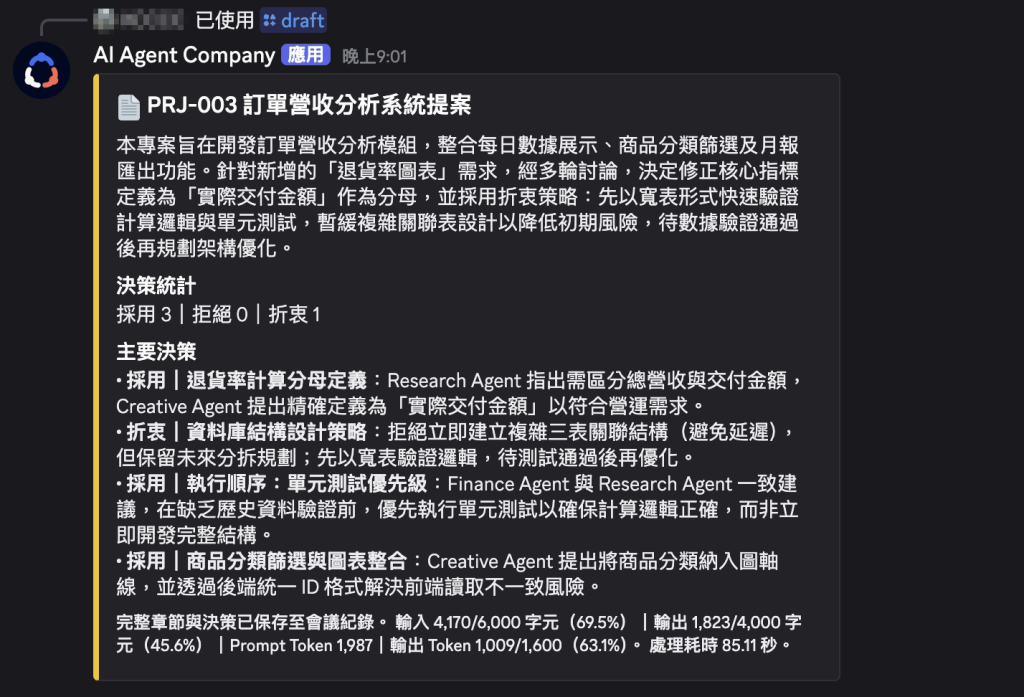
兩輪討論現在有了收斂出口。PM 可以把摘要與重要原文整理成固定章節,並保留採用、拒絕或折衷的原因與來源。
DAY 19 已完成從兩輪討論到 Discord 草案畫面的完整串接。之後若再次執行 /draft,程式會直接讀取已保存的草案,不必重新等待模型推論。


 iThome鐵人賽
 看影片追技術