

取消要分兩個角色:判斷「還要不要」的一方持有 AbortController,負責喊停;做事的一方只拿 signal,交給 fetch 這類會停下來的 API。用 TanStack Query 時,函式庫負責判斷,每輪讀取準備新的 controller、不需要時喊停;queryFn 只要把 signal 一路傳下去,沒傳到底,請求就停不下來。
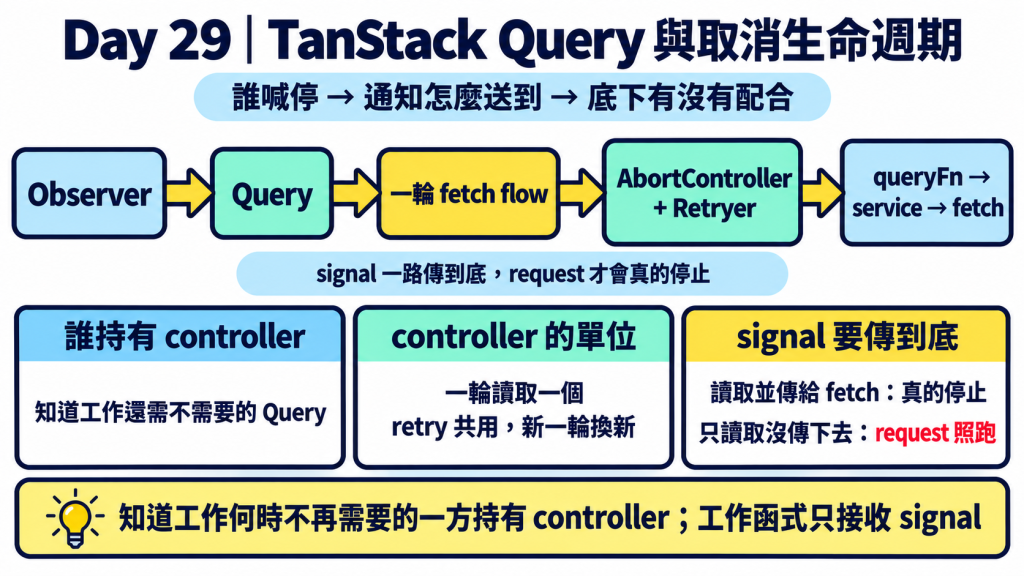
AbortController,誰只接收 signal。queryFn 三種生命週期,說明為什麼同一輪 retry 共用同一個 signal。onCancel 把取消通知送到 queryFn,以及 signal 沒傳到底時請求為什麼停不下來。我們已經看過 AbortController 發出取消通知、signal 把通知傳給執行工作的 API;也學到用 AbortSignal.timeout()、AbortSignal.any() 組合停止條件,並處理取消後的錯誤。
但到目前為止,controller 都是我們自己建立的,放進實際專案後,會遇到一個更偏架構的問題:
當使用者切換畫面、改變搜尋條件,或重新整理資料時,究竟誰應該判斷舊工作已經不需要?
今天以 TanStack Query 為例,看看「取消權」如何從管理資料生命週期的上層,一路傳到真正執行 request 的地方。
假設我們把需要非同步讀取資料的工作寫成一個函式:
async function getTodos(signal: AbortSignal) {
  const response = await fetch('/api/todos', { signal });

  if (!response.ok) {
    throw new Error(`HTTP ${response.status}`);
  }

  return response.json();
}

const controller = new AbortController();
const task = getTodos(controller.signal);

// 示範取消通知。
// 實務上可能由按鈕、畫面清理或其他 lifecycle 觸發。
controller.abort();

task.catch((error) => {
  console.log('工作未完成:', error);
});
這裡的責任分工其實很清楚。
呼叫端知道「這個工作現在還需不需要」,所以它持有 AbortController。
getTodos() 不需要知道為什麼取消,它只負責:
接收 signal
    ↓
把 signal 傳給真正執行工作的 fetch
因此可以得到本文第一個核心原則:
讓管理工作生命週期的一方持有取消權;讓工作函式接收取消訊號。
真正負責工作函式通常不需要拿到整個 controller,拿到 controller 就等於拿到「替別人決定停止」的能力,而這不是它該負的責任,也是之前學到 AbortController 的使用方式。
使用 TanStack Query 時,可以繼續沿用剛才的模式:
const todosQuery = useQuery({
  queryKey: ['todos'],
  queryFn: ({ signal }) => getTodos(signal),
});
這次我們不用自己手動建立 new AbortController(),而是由 TanStack Query 提供 signal,再把它繼續往下傳。
這就帶出一個問題:controller 改由函式庫建立,那它是在什麼時候建立的?
手寫模式的答案很單純:呼叫一次 getTodos() 就是一份工作,呼叫前 new 一個 controller 就好。
但 TanStack Query 管理的單位不是「一次呼叫」,而是「一份資料」,也就是 ['todos'] 這個 Query。
這份資料可能在畫面上存在很久,期間可能會被重新讀取好幾次:
每一次真正去拿資料,Query 都會開始一輪讀取工作,也有不同狀況需要考量:開始執行,失敗了可能重試,最後成功、失敗或被取消。
可以這樣想像:TanStack Query 判斷「這份資料需要重新讀取」之後,並不是直接呼叫 queryFn。中間還有一段準備工作:先建立這一輪要用的 AbortController,再交給 Retryer 負責執行、失敗重試與取消,最後才由 Retryer 呼叫 queryFn。
這一整輪讀取工作流程稱為 fetch flow:
從 Query.fetch() 開始準備,經過一次或多次 queryFn,到這輪工作成功、失敗或被取消為止,controller 就是在這段準備工作裡建立的:每一輪 fetch flow 一個。
controller 就是在這裡建立的:每一輪 fetch flow 一個。
有了 fetch flow 這一層概念,就可以把兩種寫法的分工對應起來:
| 責任 | 手寫模式 | TanStack Query |
|---|---|---|
| 判斷資料工作何時需要開始 | 呼叫端 | Query/Observer 等管理流程 |
| 管理一輪資料取得工作 | 呼叫端自行處理 | Query 的 fetch flow |
| 管理 retry/cancel | 自行實作 | Retryer |
| 持有取消入口 | 呼叫端 | fetch flow 中建立的 AbortController |
| 執行實際資料取得 | getTodos() |
queryFn/service |
| 真正停止 HTTP request | fetch |
fetch |
整理起來,會得到一個很重要的分層: 生命週期比較長的 Query 在上面,每次讀取才出現的 fetch flow 在中間,真正執行讀取的 queryFn 在下面。
Query
  ↓
fetch flow
  ↓
queryFn
  ↓
network request
剛開始接觸 Tanstack Query 時的角度會為說只是 「一份資料」 ,但它其實 Query 做的事情滿多的,不只是一個存放 data 的變數。
以 ['todos'] 為例,Query 除了資料本身,還會記錄這份資料的各種狀態:
| 記錄的事 | 例子 | 用來判斷什麼 |
|---|---|---|
| 資料與錯誤 | data、error、status |
畫面要顯示資料、載入中,還是錯誤 |
| 資料新不新 | dataUpdatedAt 搭配 staleTime 設定 |
需不需要重新讀取 |
| 現在有沒有在讀 | fetchStatus |
能不能共用進行中的工作 |
| 誰在使用 | observers | 最後一個使用者離開時要不要取消 |
| 沒人用之後留多久 | gcTime(預設 5 分鐘) |
什麼時候從 cache 移除 |
所以 Query 本身也有一段生命週期:
gcTime 過去,才從 cache 移除。這麼多事情,是誰在管理?
TanStack Query 裡並沒有一個單獨叫做 LifecycleManager 的東西。我們看到的 lifecycle,其實是幾個角色合作的結果。
| 角色 | 主要責任 |
|---|---|
QueryCache |
保存與查找 Query |
Query |
保存資料、錯誤與 fetch state,協調 fetch 流程 |
QueryObserver |
訂閱 Query,把狀態整理成 component 使用的結果 |
Retryer |
管理一輪 fetch flow 的執行、retry、pause 與 cancel |
AbortController |
提供這一輪工作的取消入口 |
接著要先分清楚兩個生命週期。
Query 代表的是「這一份資料」,例如 ['todos']。
它可以在一次 request 結束後繼續存在於 cache,所以「request 結束」不等於「Query 立即消失」;
開頭表格裡的 資料、成功失敗等狀態與 observers,也都跟著 Query 一起留下來。
真正需要重新取得資料時,Query 才會開始一輪 fetch flow:
Query
│
├─ cached data
├─ state
├─ observers
│
└─ 需要取得資料
      ↓
   fetch flow
所以在 Tankstack Query 就能夠區分兩個不同維度的流程:
Query 是較長生命週期的資料管理單位;fetch flow 則是一輪資料取得工作的生命週期。
TanStack Query 不會直接呼叫 queryFn,中間還有一輪 fetch flow,打開來看裡面有三個角色:
Query.fetch()
  ↓
一輪 fetch flow
  ├─ AbortController:這一輪的取消入口,產生 signal
  ├─ Retryer:執行 queryFn,失敗就重試,需要時取消
  └─ queryFn({ signal }):真正去拿資料
        ↓
      fetch()
可以把它想成一個小團隊:
queryFn 是實際動手的人,也通常是我們自己定義資料怎麼拉取的這一段,只管「這一次怎麼拿到資料」。controller 屬於這一輪,不是整個 Query 共用。
Query 可能存在很久,但 signal 一旦 abort 就無法恢復。如果整個 Query 共用一個 controller,取消過一次之後,往後每次讀取都會一開始就失敗。所以每一輪 fetch flow 各自建立一個。
重試不會開新的一輪。
設定 retry: 2 時,queryFn 最多會被呼叫三次,但三次都在同一輪裡,由同一個 Retryer 重試,拿到的也是同一個 signal。原始碼裡,Query.fetch() 只建立一次 AbortController,重試只是重新呼叫交給 Retryer 的那個函式。
要停的時候,沿著登記好的入口喊停。
Query.fetch() 建立 Retryer 時,傳入一個 onCancel callback,裡面呼叫的正是這一輪的 abortController.abort()。整條取消路徑是:
Query 判斷這輪工作不需要了
  ↓
Retryer.cancel():先讓這一輪的 Promise 以 CancelledError 結束
  ↓
onCancel() → abortController.abort()
  ↓
signal 變成 aborted
  ↓
queryFn → service → fetch:一路收到通知,停止
所以取消不是「新的
queryFn去找舊的queryFn」,而是 Query 像查工作登記表一樣,照著當初登記的入口停掉目前那一輪。
最後一段要靠我們接上。 前面幾步都由 TanStack Query 完成;fetch 會不會真的停,要看 signal 有沒有傳到它手上:
// ✗ 讀到了 signal,卻沒交給 fetch:Query 喊停了,請求照樣跑完
queryFn: ({ signal }) => fetch('/api/todos')

// ✓ signal 經過 getTodos(),一路傳到 fetch
queryFn: ({ signal }) => getTodos(signal)
中間如果有 getTodos() 這類 service,也要繼續往下傳,直到真正支援 AbortSignal 的 API。原生 Promise 沒有通用的 cancel(),這裡的取消能力,來自函式庫的管理流程,加上底層 API 對 AbortSignal 的支援。
取消路徑有個前提:TanStack Query 得先決定「要不要喊停」。
最常見的時機,是 Query 已經沒人用了:component 卸載,或搜尋關鍵字改變、畫面換去訂閱另一個 Query。這時舊的那輪讀取可能還在跑,TanStack Query 面對一個兩難:
queryFn 有把 signal 傳下去,request 真的會停,省下網路與伺服器的資源。queryFn 根本不支援取消,喊停也停不了 request;不如讓它跑完,結果存進 cache,下次回到這個畫面還能直接用。TanStack Query 看不到
queryFn裡面寫了什麼,只能靠一個線索來判斷:你有沒有讀取 signal。
TanStack Query 傳給 queryFn 的參數物件上,signal 不是普通屬性,而是用 Object.defineProperty 定義的 getter。概念上像這樣:
const context = { queryKey, meta };

Object.defineProperty(context, 'signal', {
  get() {
    abortSignalConsumed = true; // 記下:有人拿走了 signal
    return abortController.signal;
  },
});

queryFn(context);
所以 ({ signal }) => ... 這種解構寫法,函式一開始就會觸發 getter;沒用到 signal 的 () => fetch(...) 或 ({ queryKey }) => ... 則不會。
判斷時機是最後一個 observer 離開:最後一個在看這份資料的 component 卸載了,或換去看別的 Query,這時 Query.removeObserver() 會幫助我們多排查一件事:
這一輪的
queryFn有沒有拿過 signal?
| 拿過 signal:喊停 | 沒拿 signal:讓它跑完 | |
|---|---|---|
| 判斷理由 | 你應該停得下來 | 喊了你也停不下來 |
| 原始碼 | retryer.cancel({ revert: true }) |
retryer.cancelRetry() |
| request | 收到 abort,停止 | 繼續跑 |
| Query 的狀態 | 退回這一輪開始之前,就像這一輪沒發生過 | 跑完後照常更新,結果存進 cache |
| 如果這次失敗 | 不適用 | 不再重試,因為已經沒人在看了 |
它只知道你有沒有拿 signal,看不到你有沒有交給 fetch。所以讀了 signal 卻沒傳下去,Query 照樣喊停、丟掉結果,request 卻停不下來。
關鍵字從 react 改成 vue,['search', 'react'] 和 ['search', 'vue'] 是兩個不同的 Query。新 Query 完全不知道舊的存在,是舊 Query 自己發現要停:
observer 退訂舊 Query,改訂閱新 Query
  ↓
舊 Query 的訂閱名單空了 → 拿過 signal?
  ↓ 拿過
舊 Query 對自己這一輪的 Retryer 呼叫 cancel()
  ↓
onCancel() → 這一輪的 abortController.abort()
  ↓
signal 往下傳:queryFn → service → fetch,request 停止

(同一時間)新 Query 用自己的新 controller 開始新的一輪
三個角色各管一件事:
只有同一個 Query 重新讀取時,才是新的一輪觸發取消:
呼叫 refetch()、已經有資料,且 cancelRefetch 為 true(預設值)時,Query.fetch() 會先停掉目前那一輪,再開始新的。
TanStack Query 給我們一個 lifecycle signal,我們還可以再加入 Day 28 學到的 timeout:
queryFn: ({ signal }) => {
  const combinedSignal = AbortSignal.any([
    signal,
    AbortSignal.timeout(5_000),
  ]);

  return getTodos(combinedSignal);
}
這時停止條件變成:
TanStack Query 覺得工作不需要 ──→ signal ──┐
                                           ▼
timeout 5 秒 ─────────────────────→ AbortSignal.any()
                                           ↓
                                         fetch
任何一個條件先 abort,整個 combined signal 就進入 aborted 狀態。
TanStack Query 仍然持有自己的 controller;我們只是把「Query lifecycle cancellation」和「timeout cancellation」組合成同一個 signal 再往下傳。
兩種停止在 TanStack Query 眼中並不一樣:
CancelledError 結束這輪工作,不會 retry。queryFn 丟出了一個 TimeoutError,和其他失敗一樣,可能依 retry 設定再試一次。因為 AbortSignal.timeout() 寫在 queryFn 裡,每次 attempt 都會建立新的 timeout signal,所以每次 retry 都重新計時;外層的 lifecycle signal 則仍是同一輪 fetch flow 共用的那一個。
再看常使用的搜尋案例,是不同 queryKey的組合,會依照使用者輸入不同關鍵字觸發 API :
const result = useQuery({
  queryKey: ['search', keyword],
  queryFn: ({ signal }) =>
    fetch(`/api/search?q=${encodeURIComponent(keyword)}`, { signal }).then(
      (response) => {
        if (!response.ok) {
          throw new Error(`HTTP ${response.status}`);
        }

        return response.json();
      },
    ),
});
keyword 從 'react' 變成 'vue',query key 就從 ['search', 'react'] 變成 ['search', 'vue']。這兩個是不同的 Query identity,會分開管理 cache。
keyword = react

Observer
   ↓
Query ['search', 'react']
   ↓
fetch flow A
接著:
keyword = vue

Observer ──────────────────────────┐
                                   ▼
Query ['search', 'react']    Query ['search', 'vue']
       舊 Query                     ↓
                               fetch flow B
Observer 做的是 切換到另一個 Query:它從舊 Query 移除自己,再訂閱新 Query。並不是 fetch B 直接找到 fetch A 並把它 abort。
如果舊 Query 因此失去最後一個 observer,而且 signal 被讀取過,會走到第五節的取消路徑,雖然 fetch A 被取消,表面上看起來像「新請求取消了舊請求」,但真正的原因是舊 Query 已經沒有人需要,然後透過 Abort signal 去讓另一個請求動作取消掉 。
所以舊 Query 的 fetch 是否取消,要看:
還有沒有其他 observer
signal 是否被讀取
目前 fetch 狀態
這裡也要記得把 signal 傳到 fetch。如果只讀取、沒傳下去,fetch A 不會停,舊 request 會繼續跑完,白白占用網路與伺服器資源。
不過即使沒傳,在 TanStack Query 裡也不會出現手寫搜尋常見的 race condition:
也就是「react 的結果比較晚回來,蓋掉 vue 的結果」。原因在於 TanStack Query 是依照 query key,決定結果要存到哪裡、畫面要從哪裡讀:
queryKey ['search', 'react']
  ↓ hashKey():轉成穩定的字串(物件屬性會先排序)
queryHash '["search","react"]'
  ↓ QueryCache 用這個字串當 Map 的 key
Query ['search', 'react']:只存 react 的結果
Map<queryHash, Query>。['search', 'react'] 和 ['search', 'vue'] 轉出不同的 queryHash,所以是兩個各自獨立的 Query。['search', 'react'] 這個 Query 開始的,回來的資料只會更新這個 Query 的 state,碰不到 ['search', 'vue']。vue 時,observer 用新的 key 從 QueryCache 找到(或建立)['search', 'vue'],改成訂閱它;之後畫面拿到的資料,只從這個 Query 計算。舊 Query 更新時,也只會通知仍然訂閱它的 observer。所以 fetch A 就算比較晚回來,也只是把 react 的結果存進 ['search', 'react'];使用者之後切回 react,還可能直接用到這份資料,是我當初整理閱讀時容易思考忽略的細節~😊
兩件事各有負責的機制:避免舊結果蓋掉新結果,靠的是 query key 對應到不同的 Query;signal 負責的,是讓不需要的 request 真的停下來。
query key 改變,不應簡化成「新 request 一定取消舊 request」。
一輪讀取一個 controller。不是整個 Query 共用一個;同一輪裡的 retry,則共用同一個 controller,不會每次重試就換新的。
signal 被 abort 之後,就像貼上一張撕不掉的「已取消」貼紙:signal.aborted 會永遠是 true,沒辦法重設。
如果整個 Query 只用一個 controller,第一輪被取消後,這個 signal 就一直是取消狀態。下一輪再把它交給 fetch(),fetch 一看到 signal 已經取消,會立刻失敗,request 根本不會送出去。
所以每開始新的一輪讀取,都要準備一個全新的 controller。
因為 retry 是同一輪工作的一部分,不是新的一輪。原始碼裡,Query.fetch() 每一輪只建立一次 AbortController;Retryer 每次重試,只是重新呼叫同一個函式,讀到的都是這個 controller 的 signal。
幾次嘗試要拿的是同一份資料、服務的是同一批使用者;不需要的時候,也應該一起停。
共用同一個 signal,Query 只要喊停一次:正在跑的那次嘗試會收到 abort,後面排隊的重試也不會再開始。
第一輪(例如第一次載入)
  controller A → signal A
  ├─ queryFn 第 1 次 → 失敗
  └─ queryFn 第 2 次 → 成功        ← 兩次都拿到 signal A

第二輪(例如切回視窗、自動重新讀取)
  controller B → signal B
  └─ queryFn 第 1 次 → 成功        ← 換成全新的 signal B
就算 signal A 曾經被 abort,也不會影響第二輪,因為第二輪拿到的是全新的 signal B。
一輪讀取一個 controller:重試共用,新的一輪換新的。
最後把幾個容易混在一起的機制分開:
| 機制 | 解決的問題 | 搜尋框例子 |
|---|---|---|
| Debounce | 觸發太密集 | 停止輸入一段時間後才開始搜尋 |
| Deduplication | 相同工作重複開始 | 相同 Query 已經在讀取,其他使用端共用結果 |
| Cancellation | 已開始的工作後來不需要 | 離開畫面後停止未完成的搜尋 |
最簡單可以記成:
Debounce      = 先不要開始
Deduplication = 已經有人在做,就不要重複做一份
Cancellation  = 已經開始,但現在不要了
這三者不是同一個功能,也不是三個一一對應的 TanStack Query API(TanStack Query 本身不做 debounce,通常是在傳入 queryKey 之前先 debounce 輸入值)。它們可以一起存在:
使用者輸入
   ↓
Debounce:降低開始工作的頻率
   ↓
Query / Cache:判斷資料與工作是否可共用
   ↓
fetch flow:真正開始一輪資料取得
   ↓
AbortSignal:必要時取消已開始的工作
今天其實是沿著一條線走:誰喊停 → 通知怎麼送到 → 底下有沒有配合。
Query(一份資料,但裡面處理很多看不到的事情...)
  │  最後一個 observer 離開,或同一個 Query 重新讀取
  ▼
一輪 fetch flow:AbortController + Retryer
  │  abort() → signal
  ▼
queryFn → service → fetch:一路把 signal 傳下去
1. 誰喊停:知道「還要不要」的那一層
知道工作什麼時候不再需要的一方持有 controller,真正做事的一方只接收 signal。在 TanStack Query 裡,這個角色由 Query 擔任:最後一個 observer 離開,或同一個 Query 重新讀取時,由它決定要不要喊停。新的 Query 不會去停舊的。
2. controller 的單位:一輪讀取一個
Query 可能活很久,但 signal 被 abort 之後無法恢復,所以每一輪 fetch flow 各自建立一個 controller。同一輪的 retry 共用同一個 signal,新的一輪換新的。
3. 底下有沒有配合:signal 要傳到底
queryFn 的寫法 |
Query 的判斷 | request |
|---|---|---|
讀取 signal,並傳到 fetch |
喊停 | 真的停止 |
| 沒讀取 signal | 不喊停,讓它跑完、結果進 cache | 跑完 |
| 讀取了卻沒傳下去 | 喊停,結果丟掉 | 照樣跑完 |
另外要分清楚:舊結果不會蓋掉新結果,靠的是 query key 對應到不同的 Query;signal 負責的,是讓不需要的 request 真的停下來。
其實看到這裡應該得到結論很簡單,我們自己定義的 query function 只定義需不需要接收取消這個訊號:
誰知道這份工作什麼時候不再需要,誰就持有 controller;真正做事的函式,只要接收 signal 並一路傳下去。
fetch() 建立 controller、signal getter、removeObserver())、retryer.ts(cancel()、cancelRetry())、queryObserver.ts(query key 改變時切換 Query)AbortSignal


 iThome鐵人賽
 看影片追技術