
UTF-8 負責把文字變成 bytes,Base64 與 Hex 負責把 bytes 寫成文字,兩者方向相反、處理的問題也不同。btoa('中文') 會壞,不是 Base64 不支援中文,而是少了 UTF-8 這一步;ES2026 的 toBase64()、toHex() 讓 Uint8Array 直接完成 bytes 與文字之間的轉換。
前置知識:讀過 Day 25,知道 ArrayBuffer 保存 bytes,而 Uint8Array 可以把每個 byte 當成 0~255 的數字讀寫。
學習路線:Day 25 把資料看到 bytes 層;今天先理解文字與 bytes 的關係,再看 Base64、Hex 如何把任意 bytes 表示成文字。
標籤:ES2026 Uint8Array UTF-8 Base64 Hex TextEncoder JWT Web Crypto
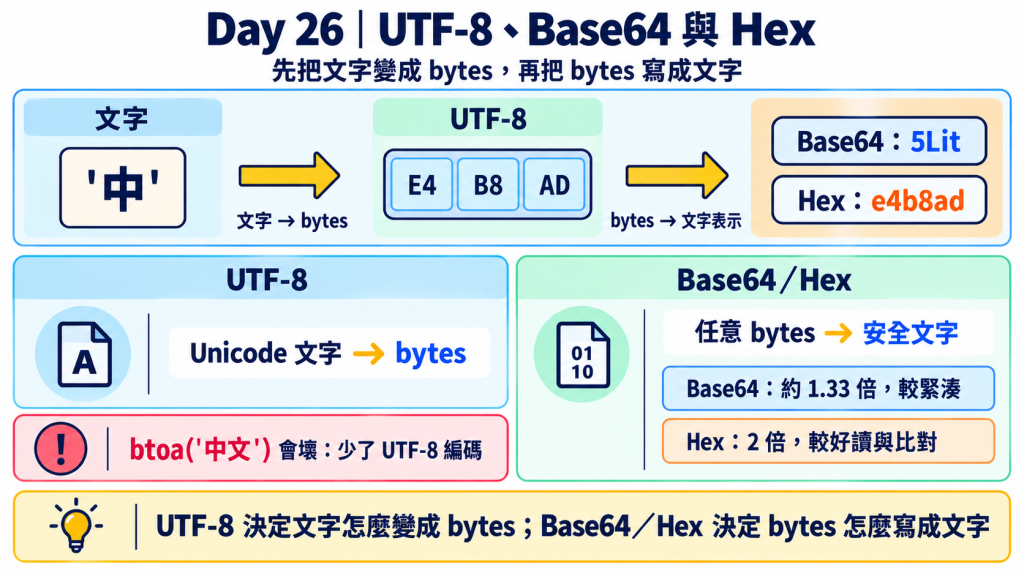
這篇先不急著背 API,只要搞懂三件事:
把這三件事分清楚,後面的 TextEncoder、btoa()、JWT、SHA-256 就會容易很多。
其實在 Day 14 和 Day 15 讀 response.body 時就遇過這件事了:
一個一個讀出來的 chunk 不是字串,而是 Uint8Array,一定要再經過 TextDecoder(或 TextDecoderStream)才能變回看得懂的文字。
for await (const chunk of response.body.pipeThrough(new TextDecoderStream())) {
  console.log(chunk); // 經過解碼,才是字串
}
當時的重點放在「資料怎麼一段一段流進來」,知道這是解碼過程就先照著寫了。直到 Day 25 把 bytes 看清楚之後,新的疑問才冒出來:
TextDecoder 到底是照什麼規則把數字「翻」回文字的?今天就來把心中的這些問題釐清~😉。
btoa('A') 可以,btoa('中文') 卻壞了瀏覽器很早就有一個把字串轉成 Base64 的函式 btoa()(反方向是 atob()):
btoa('A');
// 'QQ=='

btoa('中文');
// InvalidCharacterError
同一個函式,英文可以、中文不行。直覺上會以為是「Base64 不支援中文」,但其實 Base64 根本不在意資料原本是不是中文。
要解開這個問題,得先分清楚兩個方向完全相反的轉換:
文字 ──→ bytes          (UTF-8 負責)
bytes ──→ 文字表示      (Base64、Hex 負責)
今天就照這個順序走:先看文字怎麼變成 bytes,再看 bytes 怎麼寫成文字,最後回來解釋 btoa('中文')。
上一篇我們看過這樣一串 bytes:
const bytes = new Uint8Array([72, 105]);

console.log(bytes);
// Uint8Array(2) [72, 105]
如果把它當成 UTF-8 文字來解讀:
new TextDecoder().decode(bytes);
// 'Hi'
兩個數字,變成了兩個英文字母。可見電腦真正保存的不是「文字」,仍然只有 bits 與 bytes。
我們看到 A、中、🙂 會覺得這些就是文字,但電腦需要一套規則才知道:A 是哪個字?中 是哪個字?它們最後要用哪些 bytes 保存?這件事其實分成兩層。
Unicode 替每個字元分配一個編號,稱為 code point:
A  → U+0041
中 → U+4E2D
🙂 → U+1F642
可以把 Unicode 想成一本巨大的字典,每個字都有自己的頁碼。
不過 Unicode 只告訴我們「這是哪一個字」,還沒有決定「這個字真正放進記憶體、檔案或網路時,要用哪些 bytes」~ 這是 UTF-8 的工作。
UTF-8 是一套把 Unicode 字元 → bytes 的文字編碼規則。
UTF-8 是 Unicode 定義的三種編碼方式之一,另外兩種是 UTF-16 和 UTF-32。它們面對的是同一本字典(同樣的 code point),只是把字存成 bytes 的方式不同。網頁、JSON、HTTP 最常用的是 UTF-8。
JavaScript 可以用 TextEncoder 看到結果:
new TextEncoder().encode('A');
// Uint8Array(1) [65]
A 在 UTF-8 裡只要一個 byte:
A ─UTF-8→ 65 ─binary→ 01000001
中文就不一樣了:
new TextEncoder().encode('中');
// Uint8Array(3) [228, 184, 173]
中 ─UTF-8→ 11100100 10111000 10101101 (3 bytes)
emoji 通常需要更多:
new TextEncoder().encode('🙂').length;
// 4
初學時不用背完整的 UTF-8 bit 規則,只要先有這個印象:
| 字元 | UTF-8 常見長度 |
|---|---|
| ASCII 英文字母、數字 | 1 byte |
| 中文 | 3 bytes |
| emoji | 4 bytes |
所以一個中文字不是「三個字元」,而是一個 Unicode 字元,照 UTF-8 編碼後需要 3 個 bytes。
UTF-8 和 UTF-16 編的是同一本 Unicode 字典,差在一次用多大的單位來存:
| 字元 | UTF-8 | UTF-16 |
|---|---|---|
A |
1 byte | 2 bytes |
中 |
3 bytes | 2 bytes |
🙂 |
4 bytes | 4 bytes |
那為什麼網路用 UTF-8,JavaScript 卻用 UTF-16?~算是一段歷史淵源
網路選 UTF-8:它跟 ASCII 相容,英文的 bytes 和舊系統一模一樣;HTML 標籤、JSON key 多半是英文,用 UTF-8 最省。JSON 規格(RFC 8259)和 WHATWG Encoding Standard 也都要求用 UTF-8。
JavaScript 用 UTF-16 是歷史原因:JavaScript 在 1995 年誕生時,Unicode 還是純 16-bit 設計,一個字元剛好等於一個 16-bit 數值。1996 年 Unicode 2.0 擴大範圍後,超出的字只好用兩個 16-bit 單位拼成一個。
這就是為什麼:
'中'.length; // 1
'🙂'.length; // 2 ← 被拆成兩個 16-bit 單位
.length 數的是 UTF-16 的單位,不是 bytes,也不一定是「幾個字」。想知道 UTF-8 占幾個 bytes,要看 TextEncoder 的結果。
所以文字在網路與 JavaScript 之間,其實一直在換編碼:
網路上的 UTF-8 bytes ─TextDecoder→ JS 字串(UTF-16) ─TextEncoder→ UTF-8 bytes
TextEncoder 與 TextDecoderJavaScript 把這兩個方向寫成兩個物件:
文字        ─TextEncoder→  UTF-8 bytes
UTF-8 bytes ─TextDecoder→  文字
const bytes = new TextEncoder().encode('中文');

console.log(bytes);
// Uint8Array(6) [228, 184, 173, 230, 150, 135]
//               └── 中 ──┘   └── 文 ──┘

console.log(new TextDecoder().decode(bytes));
// '中文'
這也回答了開頭 stream chunk 的疑問:網路送來的文字早就照 UTF-8 變成 bytes 了,TextDecoder 做的就是照同一套規則翻回來。也因為一個中文字占 3 個 bytes,chunk 才可能剛好把一個字切成兩半,這就是 Day 15 說 TextDecoderStream 要先記住半個字、等下一個 chunk 補齊的原因。
先記住第一句重點:
UTF-8 解決的是「文字如何變成 bytes」。
假設我們送出一段 JSON:
{ "message": "中文" }
JSON 是文字格式,但真正透過網路傳輸時,概念上是這樣:
送出:JSON 文字  ─UTF-8→  bytes  ─→  HTTP
收到:bytes      ─UTF-8→  JSON 文字
所以你可能在 HTTP response 看過:
Content-Type: application/json; charset=utf-8
charset=utf-8是在告訴接收端:這份文字內容的 bytes,請照 UTF-8 規則解讀。 HTML 裡的<meta charset="UTF-8">也是同樣的意思。
同一串 bytes,用不同的文字編碼規則解讀,會得到不同的字。所以 charset 不是「顯示樣式」,而是決定這些 bytes 要照哪套規則還原成字元。Server 傳的是 UTF-8 bytes,接收端卻用別的 charset 解碼,就會看到亂碼。
不用真的發請求,用 Request 就能看到 fetch 送出前做了什麼。把下面這段貼進瀏覽器 Console:
const text = JSON.stringify({ message: '中文' });

text.length;
// 16  ← JS 字串的長度

// 只建立 Request 物件,不會真的送出;用完整網址,在任何分頁的 Console 都能跑
const req = new Request('https://example.com/api', { method: 'POST', body: text });

req.headers.get('Content-Type');
// 'text/plain;charset=UTF-8'  ← body 是字串時,自動標上 UTF-8

const bytes = new Uint8Array(await req.arrayBuffer());

bytes.length;
// 20  ← 真正要送出的 bytes
16 個字元變成 20 個 bytes:英文和符號各占 1 byte,「中」「文」各占 3 bytes,多出來的 4 個就是這樣來的。
接著用同一串 bytes,故意換一套規則來解讀:
new TextDecoder('utf-8').decode(bytes);
// '{"message":"中文"}'

new TextDecoder('big5').decode(bytes);
// '{"message":"銝剜�"}'  ← 同一串 bytes,規則不同就變成別的字
這就是前面說的「charset 錯了會出現亂碼」。而且只有中文壞掉,英文部分完全沒事,因為英文在 UTF-8 裡就是 ASCII,換成 Big5 解讀也還是同樣的字。
這裡是今天最容易誤會的地方。先講結論:
Base64 不是因為 HTTP 不能傳 binary data。
HTTP 本來就能直接傳 bytes。一般圖片上傳可以這樣寫:
const form = new FormData();
form.append('avatar', file);

await fetch('/api/avatar', {
  method: 'POST',
  body: form,
});
File / Blob ─→ FormData ─→ HTTP
完全不需要 Base64。圖片、PDF、Excel 都可以這樣傳。
既然如此,Base64 當初為什麼會出現?答案在 email。早期的 email 只能傳 7-bit ASCII 文字,途中經過的系統還可能改掉看不懂的 bytes。所以寄圖片前,要先把 bytes 換成 64 個不會被弄壞的安全字元(MIME 規格 RFC 2045);送出時仍然是 bytes,只是全都落在安全範圍內。
現在的 HTTP 已經能原封不動地傳任何 bytes,但「只收特定字元」的地方還在,只是從傳輸管道,換成了 JSON 字串、URL、HTTP header 這些文字欄位。
假設某個 API 規定 request 必須長這樣:
{ "image": "..." }
可是手上的圖片不是文字,而是一串 raw bytes:
137 80 78 71 ...
JSON 只有字串、數字、布林值、null、陣列與物件,沒有一種型別能表達「這裡直接塞一段 raw bytes」。這時才需要把 bytes 改寫成文字:
圖片 bytes ─Base64→ "iVBORw0KGgo..."
{ "image": "iVBORw0KGgo..." }
所以:
Base64 是把任意 bytes 表示成一串安全文字的 binary-to-text encoding。
把兩種情況並排看:
一般文字:
"中文"          ─UTF-8→  bytes  ─→  HTTP

bytes 必須放進文字欄位:
圖片 bytes
  ─Base64→     "iVBORw0KGgo..."
  ─放進 JSON→  '{"image":"iVBORw0KGgo..."}'
  ─UTF-8→      bytes  ─→  HTTP
注意第二條路:Base64 產生的文字會先放進 JSON,而整份 JSON 跟第一條路的 "中文" 一樣,要走上網路還是得經過 UTF-8 變成 bytes。這一步不會讓資料再變大,因為 Base64 的字元都是 ASCII,每個剛好 1 byte。
所以 UTF-8 和 Base64 不是兩套互相競爭的傳輸系統,它們處理的是不同的問題:
| UTF-8 | Base64 | |
|---|---|---|
| 處理對象 | Unicode 文字 | 任意 bytes |
| 方向 | 文字 → bytes | bytes → 文字表示 |
| 一般文字傳輸 | 一定會用到 | 不需要 |
| 一般檔案上傳 | 不適用 | 通常不需要 |
UTF-8 決定文字怎麼變成 bytes;Base64 決定 bytes 怎麼包成文字。
Base64 只用 64 個安全字元:A–Z、a–z、0–9、+、/。但一個 byte 有 256 種可能,一個字元裝不下,所以 Base64 把 bytes 切得更小:每 6 個 bit 一段,6 個 bit 剛好 64 種組合,一段換一個字元。這跟 Day 25 十六進位「每 4 個 bit 一組」是同一招。
3 個 bytes 是 24 個 bit,剛好切成 4 段,所以 3 bytes → 4 個字元:
'Hi!' 的 bytes   72        105       33
二進位            01001000  01101001  00100001
每 6 個 bit 一段  010010  000110  100100  100001
Base64 字元         S       G       k       h
資料不是 3 的倍數時,最後用 = 補位,例如 'Hi' → 'SGk='、'A' → 'QQ=='。
每個 Base64 字元只裝了 6 個 bit 的資料,存成文字時卻要占一整個 byte(8 個 bit)。所以原本 3 bytes 的資料,變成 4 個字元 = 4 bytes,大約膨脹三分之一。
Base64 的 64 個字元加上 = 全都是 ASCII 字元。所以 Base64 的結果放進 JSON、URL、HTTP header 都很安全,UTF-8 編碼時每個字元也剛好 1 byte,不會再變大。
但兩者方向相反,別搞混:
ASCII / UTF-8:字元 → bytes
Base64:       bytes → 字元
btoa('中文') 為什麼會壞?有了前面的基礎,開頭的謎題就能解開了。
btoa() 的名字可以讀成「binary to ASCII」,問題就出在 binary 這個字:它收的不是一般的 Unicode 文字,而是一種 binary string:
字串裡的每一個字元,都必須能代表一個 0~255 的 byte。
A 剛好符合,它的編號是 65,塞得進一個 byte,所以 btoa('A') 得到 'QQ=='。
「中」就不行了。它的 UTF-8 結果是 3 個 bytes:
'中' ─UTF-8→ E4 B8 AD (3 bytes)
但 btoa() 不會幫你做 UTF-8 編碼。它看到「中」這個字元,不知道該當成哪一個 byte,只好報錯。
atob() 也一樣atob() 是「ASCII to binary」:把 Base64 還原成 binary string,每個字元代表一個 byte。
atob('QQ==');
// 'A'

atob('5Lit5paH'); // 「中文」的 Base64
// 'ä¸\xadæ\x96\x87'  ← 沒報錯,卻變成亂碼
'5Lit5paH' 還原後是「中文」的 6 個 UTF-8 bytes,但 atob() 不會幫你做 UTF-8 解碼,只是把每個 byte 各自當成一個字元,6 個 bytes 就變成 6 個看不懂的字元(其中幾個是看不見的控制字元,這裡寫成 \x..)。
這比 btoa() 更容易踩到:btoa('中文') 至少會直接報錯,atob() 卻安靜地回傳一個錯的字串。
兩個方向缺的是同一步:
btoa():文字         ─✗ 少了 UTF-8 編碼→  Base64
atob():Base64       ─→  bytes  ─✗ 少了 UTF-8 解碼→  文字
所以正確的流程要多走一步,先把文字變成 bytes:
文字 ─UTF-8→ bytes ─Base64→ Base64 文字
Uint8Array 直接轉 Base64以前 JavaScript 只有 btoa()/atob(),它們只收 binary string,所以得自己多繞一步:
以前:文字 → bytes → 自己轉成 binary string → btoa() → Base64
現在:文字 → bytes → toBase64() → Base64
ES2026 直接在 Uint8Array 上加了四個方法:toBase64()、fromBase64()、toHex()、fromHex()。輸入和輸出都是 bytes,剛好對上「先 UTF-8、再 Base64」的流程:
const bytes = new TextEncoder().encode('中文');

bytes.toBase64();
// '5Lit5paH'
還原時反過來走:
const decoded = Uint8Array.fromBase64('5Lit5paH');

new TextDecoder().decode(decoded);
// '中文'
編碼:'中文'  ─UTF-8→  [228, 184, 173, 230, 150, 135]  ─Base64→  '5Lit5paH'
還原:'5Lit5paH'  ─Base64 decode→  [228, 184, 173, 230, 150, 135]  ─UTF-8 decode→  '中文'
| 方向 | 用什麼 |
|---|---|
| 文字 → bytes | new TextEncoder().encode(text) |
| bytes → 文字 | new TextDecoder().decode(bytes) |
| bytes → Base64 | bytes.toBase64() |
| Base64 → bytes | Uint8Array.fromBase64(text) |
這組方法從 2025 年 9 月起所有主流瀏覽器都支援;Node.js 等較舊的環境要怎麼寫,見第十一節。
Base64 只跟 bytes 打交道,不直接跟「文字」打交道。 遇到中文、emoji,一律先經過
TextEncoder。
Base64 不是唯一的 binary-to-text 表示方式。另一個很常見的是 Hex,也就是十六進位:每個 byte 固定寫成 2 個字元(0–9、a–f)。
const bytes = new TextEncoder().encode('Hi');
// Uint8Array(2) [72, 105]
72 的十六進位是 48,105 是 69:
bytes.toHex();
// '4869'

bytes.toBase64();
// 'SGk='
同一批 bytes [72, 105]
  ├─ Hex    → '4869'
  └─ Base64 → 'SGk='
兩者都沒有改變原始資料,只是換一種寫法,就像同一個數字可以寫成「十」也可以寫成「10」。
| Hex | Base64 | |
|---|---|---|
| 表示方式 | 1 byte → 2 個字元 | 3 bytes → 4 個字元 |
| 長度 | 原始資料的 2 倍 | 約原始資料的 1.33 倍 |
| 優點 | 好讀、好比對 | 比 Hex 緊湊 |
| 常見用途 | hash、除錯、檔案 signature | bytes 放進 JSON、JWT、data URL |
很多網站登入後會拿到一個 JWT(JSON Web Token),用 . 分成三段:
header.payload.signature
const token =
  'eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9' +                              // header
  '.eyJzdWIiOiI0MiIsIm5hbWUiOiLnjovlsI_mmI4iLCJyb2xlIjoiYWRtaW4ifQ' +  // payload
  '.簽章省略';                                                           // signature
中間那段 payload,其實是一個 JSON 經過編碼的結果:
{"sub":"42","name":"王小明","role":"admin"}
一般 Base64 會用到 + 和 /,但這兩個字元在網址裡有特殊意義。所以 JWT 用的是網址安全版的 Base64URL:
一般 Base64:  +  /   結尾有 =
Base64URL:    -  _   結尾的 = 常省略
如果直接用第五節看過的 atob(),會卡在兩個地方:
atob() 只認得一般 Base64,看到 _ 就報錯。-_ 換回 +/,「王小明」還是會變成亂碼。這就是第五節 atob('5Lit5paH') 的情況:「王小明」的 9 個 bytes 被當成 9 個獨立字元,少了 UTF-8 解碼這一步。const payload = token.split('.')[1];
const bytes = Uint8Array.fromBase64(payload, {
alphabet: 'base64url',
});
const user = JSON.parse(new TextDecoder().decode(bytes));
console.log(user.name);
// '王小明'
流程剛好是前面學過的每一層:
JWT payload ─Base64URL decode→ bytes ─UTF-8 decode→ JSON 文字 ─JSON.parse→ 物件
沒有結尾的 = 也沒關係,fromBase64() 預設可以接受。反過來要產生 Base64URL:
bytes.toBase64({ alphabet: 'base64url', omitPadding: true });
能 decode JWT payload,不等於驗證 JWT。 任何人都能自己產生一段 Base64URL 的 JSON。前端讀 payload 只適合拿來「顯示」,權限判斷一定要交給會驗證簽章的後端。
可以把 SHA-256 想成一台指紋機:丟任何資料進去,不管是一個字、一張照片還是一部影片,都會吐出一段固定 32 bytes 的結果。
它有兩個特性:
所以它常被當成檔案的「指紋」。例如很多下載頁會公布檔案的 SHA-256,你下載後自己算一次:兩串一模一樣,代表檔案沒有損壞、也沒被動過;只要不一樣,就代表檔案有問題。
「改一點點就完全不同」:
'o' 和 'n' 的二進位只差最後 1 個 bit(1101111 和 1101110),所以 'hello' 和 'helln' 在 bytes 層也只差 1 個 bit:
hello → 2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824
helln → d1dd3e4f53afb65be5774853d60b74fa12c10b769c262165562c5287e6816e15
兩段指紋的 256 個 bit 裡,剛好有 128 個不一樣。
改 1 個 bit,指紋就翻掉一半,看起來像兩段毫無關係的亂數。所以指紋只能告訴你「有沒有變」,不能告訴你「哪裡變了」。
注意,指紋機是單向的:從
'hello'算得出指紋,但拿著指紋算不回'hello'。所以 SHA-256 不是加密,後面的 Hex 也只是把這段指紋換個寫法。
瀏覽器內建就能算:
const bytes = new TextEncoder().encode('hello');

const hash = await crypto.subtle.digest('SHA-256', bytes);
算出來的 hash 是 32 個 bytes,直接印出來只是一串 0~255 的數字,很難讀,也很難跟別人的結果比對。所以習慣把它寫成 Hex:
new Uint8Array(hash).toHex();
// '2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824'
hash 是 ArrayBuffer,要先包成 Uint8Array(Day 25 說的 view)才能呼叫 toHex()。以前沒有 toHex() 時,得自己把每個 byte 轉成兩位十六進位再接起來,現在一行就好。
今天其實只有一件事:分清楚兩個方向。用「中」走一次:
'中'  ─UTF-8→  E4 B8 AD  ─Base64→  '5Lit'
文字           bytes              寫成文字
| 層次 | 回答的問題 |
|---|---|
| Unicode | 這是哪一個字? |
| UTF-8 | 這個字要用哪些 bytes 保存? |
| Base64/Hex | 這些 bytes 要怎麼重新寫成文字? |
三個重點:
btoa('中文') 壞掉,是少了 UTF-8 這一步:先 TextEncoder,再 toBase64()。UTF-8 是「文字 → bytes」;Base64/Hex 是「bytes → 文字」。
老實說,這些對我來說都是底層的硬知識,寫的過程中不時覺得有點無聊。
但我並不是因為有興趣才開始的。反而是從 Day 14、15 那個「chunk 為什麼要先解碼」的小疑問開始,一個問題接著一個:為什麼拿到的是數字?為什麼 btoa('中文') 會壞?為什麼 '🙂'.length 是 2?一路追下去,才慢慢覺得有意思。
熱情是開始嘗試理解之後才挖出來的,不是先有了才開始。
現在問 AI,幾秒就能拿到答案,很容易看完就覺得「沒什麼」,也就不再往下深究。但如果只收下答案,我大概不會知道 Base64 其實是 email 時代留下來的解法,也不會發現 hash 改 1 個 bit 就會翻掉一半。自己多問一層「為什麼」,知識才會變成自己的。
toBase64()/fromBase64()/toHex()
TextEncoder、TextDecoder、btoa()、atob()、SubtleCrypto.digest()


 iThome鐵人賽
 看影片追技術