
昨天實作完登入功能,網站終於可以知道你是誰了。
但知道你是誰不代表你可以做任何事情。登入之後,我能不能看到別人的收藏?如果我把請求裡的使用者 id 換成別人的,會不會就可以刪掉別人的資料?
在電影裡,Pi 漂到一座小島。島上有淡水、有植物、有成群的狐獴,看起來什麼都能隨手拿。直到他在一顆果實裡剝出一顆牙齒,才明白這座島有它自己的規則。
資料庫也是這樣。畫面上只顯示「我的收藏」,不代表資料庫真的只會給你你的收藏。必須將真正的規則寫在資料庫裡,才能確保看不到別人的資料。
這兩件事常常被混在一起:
| 回答的問題 | 誰負責 | |
|---|---|---|
| 身分驗證(Day 18) | 你是誰? | Supabase Auth |
| 權限(今天) | 你可以碰哪些資料? | 資料庫的規則 |
最直覺的寫法,是在前端查詢時加一個條件:「只拿 user_id 等於我的資料」。
但我們已經知道,只要知道 Supabase 的 Data API 網址和公開金鑰,任何人都可以繞過網站,直接發請求, 前端的條件,別人拿掉就沒了。
公開金鑰本來就不是用來保密的。真正重要的是:就算有人拿到它,資料庫也不能因此把不該給的資料交出去。
畫面只顯示自己的收藏,是功能;就算繞過畫面,也拿不到別人的收藏,是權限。
動手之前,Codex 先列了十點規格給我確認。它特別標出最需要我回答的是這一題:
目前的收藏,要代表「我擁有」,還是單純「我喜歡/想收藏」?
它讀完專案後發現,介面文字其實混在一起:有的地方寫「我的實體收藏架」,有的地方只是一顆愛心。後來我選「我喜歡/想收藏」。接著 Codex 提議把資料表設計得更有彈性,多一個狀態欄位,可以同時支援「願望清單」和「已擁有」。
最後我的決定:
user_favorites,不放用不到的欄位AI 會替未來預留空間,但預留的東西也要有人維護。
看到 AI 加了一個欄位,可以先問它:這個欄位,這次會用到嗎?
資料庫怎麼設計,不只是技術問題。需要先確認,在這個產品裡,一筆資料到底代表什麼?
這次的資料庫變更,Codex 寫在一個 migration 檔案裡。
每筆收藏代表一個專輯版本;如果這個版本還分不同款式,就另外記下是哪一款。先看資料表本身:
create table public.user_favorites (
  id uuid primary key default gen_random_uuid(),
  user_id uuid not null references auth.users (id) on delete cascade,
  album_id text not null,
  version_id text not null,
  design_id text,
  created_at timestamptz not null default now(),
  -- 省略兩個外鍵:版本必須屬於這張專輯、款式必須屬於這個版本
  constraint user_favorites_identity_key
    unique nulls not distinct (user_id, album_id, version_id, design_id)
);
| 欄位/規則 | 意思 |
|---|---|
user_id |
這筆收藏是誰的。指向 Supabase Auth 的使用者 |
on delete cascade |
帳號被刪除時,他的收藏也一起刪掉 |
album_id、version_id |
收藏的是哪張專輯的哪個版本 |
design_id |
指定款,可以是空的(有些版本沒有分款) |
unique nulls not distinct |
同一個人、同一個版本、同一款,只能收藏一次 |
RLS(Row Level Security,列層級安全)的意思是:資料庫在回傳資料之前,會一列一列地問:「這一列,可以給這個人嗎?」
一般的權限是以「整張表」為單位:你能不能讀這張表。
RLS 更細,是以「每一列」為單位:你能讀這張表裡的哪幾列。
收藏需要這種粒度。大家的收藏都在同一張表裡,但每個人只能碰到屬於自己的那幾列。
登入之後,瀏覽器每次對 Supabase 發請求,都會帶上一張代表你身分的通行證(access token)。
資料庫可以用 auth.uid() 讀出這張通行證上的使用者 id。這張通行證由 Supabase 簽發,資料庫會先確認真偽,不是瀏覽器說自己是誰就算數。所以規則可以寫成:
這一列的
user_id,要等於目前請求者的auth.uid()。
沒登入的請求沒有通行證,auth.uid() 就是空的,什麼都對不上。
alter table public.user_favorites enable row level security;

create policy "Users can read their own favorites"
  on public.user_favorites for select to authenticated
  using ((select auth.uid()) = user_id);

create policy "Users can add their own favorites"
  on public.user_favorites for insert to authenticated
  with check ((select auth.uid()) = user_id);

create policy "Users can remove their own favorites"
  on public.user_favorites for delete to authenticated
  using ((select auth.uid()) = user_id);
第一行開啟 RLS,後面三段各是一條規則。每條規則都寫了:針對哪種操作(for select)、給誰(to authenticated,已登入的人)、條件是什麼。
條件有兩種寫法,差在檢查的時間點:
| 寫法 | 檢查什麼 | 用在 |
|---|---|---|
using |
已經存在的資料,哪幾列碰得到 | 讀取、刪除 |
with check |
準備寫進去的這一列,合不合格 | 新增 |
所以:
user_id 是自己的那幾列user_id 必須是自己。想用別人的 id 新增,會被擋下至於為什麼寫成 (select auth.uid()),而不是直接寫 auth.uid():這是 Supabase 官方建議的寫法,結果一樣,但通常能讓資料庫不用每一列都重算一次。
你可能注意到,這裡沒有「修改」的規則。這不是漏寫。對一般登入的使用者來說,RLS 一開啟,預設就是全部拒絕,只有寫了規則的操作才會放行。 收藏只需要加入和取消,沒寫 update 的規則,就沒有人能修改收藏。
反過來說,開了 RLS 卻一條規則都沒寫,這張表就誰都碰不到。遇到「資料怎麼都讀不到」,可以先往這個方向查。
migration 的最後還有兩行:
revoke all on table public.user_favorites from anon, authenticated;
grant select, insert, delete on table public.user_favorites to authenticated;
這是另一道鎖,以整張表為單位:
| 管什麼 | 比喻 | |
|---|---|---|
| grant/revoke | 這個角色,能不能對這張表做某種操作 | 能不能進這個房間 |
| RLS policy | 進來之後,能碰哪幾列 | 進房間後,能打開哪幾個櫃子 |
這裡先把所有權限收回,再只給已登入的人讀取、新增、刪除三種。沒登入的訪客(anon)什麼都沒有,連門都進不來,所以請求會直接被拒絕,也就是之前提到過的 401。
兩道鎖都要過,請求才會成功。
Day 17 寫回報功能時,我們在伺服器端用了管理者金鑰(secret key)寫入資料。
這把鑰匙會直接略過 RLS。所以 RLS 保護的,是從瀏覽器來、帶著公開金鑰和使用者通行證的請求;凡是用 secret key 的地方,權限要靠自己的程式把關。
這也是為什麼 secret key 只能放在伺服器端,絕對不能出現在瀏覽器的程式碼裡。
Day 17 的回報功能,我們自己寫了一個 API:驗證欄位、限流、用 secret key 寫入,再通知 Telegram。
收藏不一樣。瀏覽器透過 Supabase 的套件,呼叫 Supabase 提供的 Data API(就是 Day 16 用 Postman 打的那個)。請求會帶著公開金鑰和使用者的通行證,再由資料庫的兩道鎖決定能不能執行。
不是沒有 API,而是不需要再另外包一層 /api/favorites。
| 回報(Day 17) | 收藏(今天) | |
|---|---|---|
| 誰會用 | 任何訪客,不用登入 | 已登入的使用者 |
| 要擋什麼 | 亂填的內容、大量灌資料 | 碰到別人的資料 |
| 規則能不能用「這列是誰的」表達 | 不能 | 能 |
| 做法 | 自己寫 API,在伺服器端檢查 | 呼叫 Supabase 的 Data API,交給 RLS |
這不代表哪一種比較好。規則如果能寫成「這一列是誰的」,RLS 很適合;如果需要檢查內容、限制次數、通知第三方,通常就會放在自己的伺服器端處理。
因為後來決定讓未登入訪客也能收藏,這時候收藏的資料會存在瀏覽器裡。問題是登入之後,這份清單要怎麼處理。
與 AI 討論後,決定以下列方案實作:
第三點的順序很重要。如果先清除再寫入,網路剛好斷掉,收藏可能就兩邊都沒有了。
第四點是為了共用電腦。如果登出後還留著帳號的收藏,下一個人坐下來就看得到。
| 情境 | 結果 |
|---|---|
| 訪客收藏了 3 張,登入一個有 5 張收藏的帳號(其中 1 張重複) | 帳號變成 7 張,瀏覽器清空 |
| 合併時網路斷掉 | 全部留在瀏覽器,下次再試 |
| 合併成功後登出 | 收藏清單變成空的 |
| 登出後收藏 1 張,再登入 | 這 1 張合併進帳號 |
(當然,實作的方式也不唯一。如果怕麻煩,也是可以直接強迫使用者一定要登入才能進行收藏。通常不一定有最佳解,而是需要去評估優缺點、對比犧牲什麼/得到什麼。)
收藏從直接存在瀏覽器,變成要經過網路寫進資料庫,所有操作都會多一點等待時間。為了提升使用者的體驗,這次加了三種回饋:
| 做法 | 解決什麼 | |
|---|---|---|
| 立即更新(Optimistic UI) | 按下愛心,畫面先變;背景同步失敗,就恢復原狀 | 不用等網路才看到反應 |
| 提示訊息(Toast) | 成功時短暫顯示;失敗時停留久一點,告訴你已經還原 | 知道到底有沒有存進去 |
| 骨架畫面(Skeleton) | 收藏頁載入時,先顯示卡片的灰色輪廓 | 不會以為網頁壞了 |
(這邊可以呼應之前提到 UI 名詞彙整的文章。不一定要做,但做了使用者體驗通常更好)
Next.js 可以透過 loading.tsx,在頁面還沒載入完成時,先顯示預先準備好的畫面。這次 Codex 用它做收藏頁的骨架,也替骨架保留固定尺寸,資料載入後版面不會跳動。
骨架畫面是讓等待「看起來」好一點,讓使用者知道現在正在等待中(而不是點了沒反應),不會讓網頁變快。
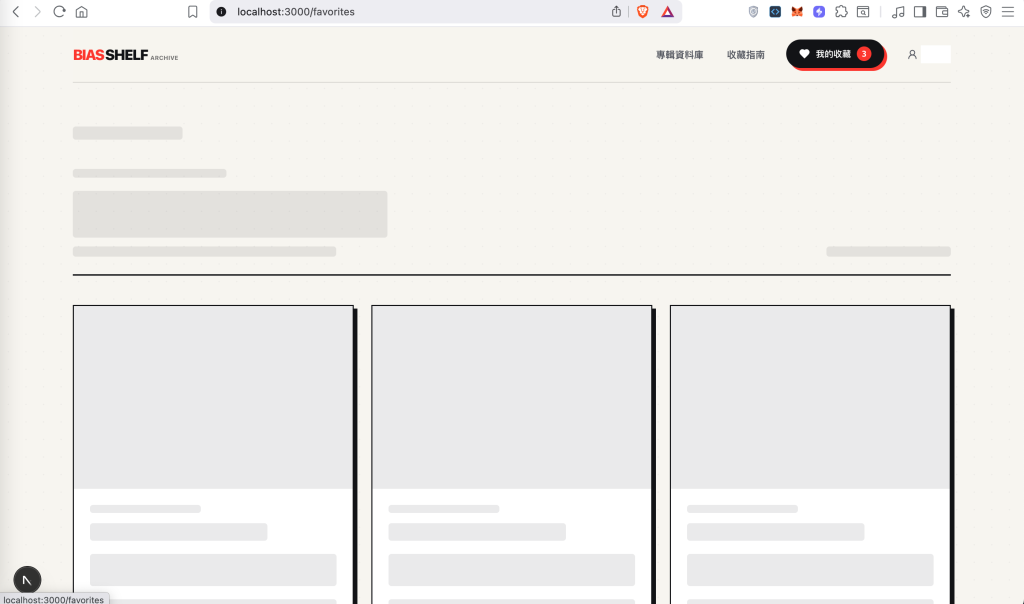
【圖1|進入收藏頁面時骨架畫面】
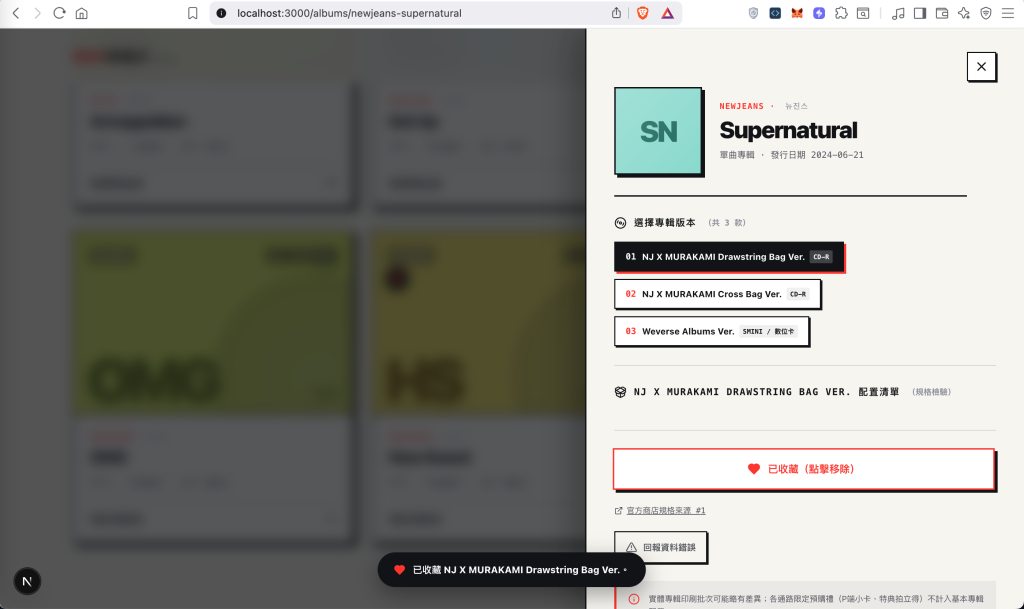
【圖2|收藏時出現的 Toast 通知】
權限:壞人進不來,也要確認自己人能用
測試前我創了兩隻帳號A跟B,並分別收藏某幾張專輯
| 身分 | 操作 | 預期結果 |
|---|---|---|
| A | 讀取收藏表,不加任何篩選條件 | 只拿到 A 的收藏 |
| A | 新增自己的收藏 | 成功 |
| A | 新增一筆,user_id 填 B 的 id |
被拒絕 |
| A | 刪除自己的收藏 | 成功 |
| A | 刪除 B 的某一筆收藏 | 沒有錯誤,但 B 的資料還在 |
| A | 修改收藏 | 被拒絕(沒有給修改權限) |
| B | 讀取收藏表,不加任何篩選條件 | 只拿到 B 的收藏 |
| 未登入 | 讀取或新增收藏 | 被拒絕 |
刪除 B 那一列要注意一下:RLS 擋住讀取和刪除時,通常不會報錯,只會當作那些資料不存在。 不能用「有沒有報錯」來判斷擋住了沒有,要再用 B 的身分確認資料還在。
功能與體驗
| 測試 | 預期結果 |
|---|---|
| 訪客收藏幾張後登入 | 合併進帳號,瀏覽器清空 |
| 合併成功後登出 | 收藏清單是空的 |
| A 登出後,B 在同一台電腦登入 | 看不到 A 的收藏 |
| 在手機登入同一個帳號 | 看到同一份收藏 |
| 斷網時按愛心 | 畫面恢復原狀,出現錯誤提示 |
| 進入收藏頁 | 先出現骨架畫面 |
| 產品 | 每個人能碰的資料 |
|---|---|
| 雲端相簿 | 只看得到自己的照片,除非對方分享給你 |
| 醫院系統 | 病人看自己的紀錄,醫生看自己負責的病人 |
| 公司內部系統 | 同一個組織的成員,看得到組織的資料 |
畫面上藏起來的資料,不代表拿不到。規則寫在資料那一層,讓繞過畫面的請求一樣可以擋得住。
今天,收藏終於能跟著人走了。
不過今天真正重要的不是收藏,而是那幾行規則:就算有人繞過網站,直接對資料庫發請求,也只碰得到自己的東西。 AI 寫 RLS 寫得很快,但規則對不對,還是建議要自己看過、檢查過。
回頭看目前已經實作的功能,我突然想到一個問題:同樣是從 Supabase 取得資料,專輯列表、搜尋結果、我的收藏,背後的處理方式感覺好像有一點不太一樣。有些事情在伺服器完成,有些則交給瀏覽器。
那麼,一個網頁究竟是在什麼時候、什麼地方被做出來的?這又會如何影響使用者看到畫面的過程?
明天,我們就從等待畫面出發,聊聊網頁的渲染方式,以及如何讓載入、等待,甚至失敗,都有適當的回饋。
我們明天見。


 iThome鐵人賽
 看影片追技術