
昨天做完收藏之後,回頭看了一下這幾天做的功能,發現一件事:同樣是從 Supabase 拿資料,專輯列表、搜尋、我的收藏,處理方式似乎有些不太一樣。有些在伺服器完成,有些交給瀏覽器。
或是說像搜尋,輸入「aespa」,我只打了一個字母就出現了篩選的結果,網站真的每打一個字母,就去資料庫查一次嗎?
在電影裡,有一晚飛魚群直接撞進救生艇,Pi 根本不用撒網,魚已經在船上了。
網站也是。要找東西之前,可以先去思考:資料是還在海裡,還是早就在船上了?
使用者看到的每一個畫面,都要經過兩件事:拿資料,和把資料組成畫面。這兩件事在哪裡做、什麼時候做,都有許多不同的選擇。
先認識確認三個角色:
| 角色 | 在這個專中是什麼 |
|---|---|
| 瀏覽器(前端) | 使用者的 Chrome、Safari |
| Next.js 伺服器(後端) | 執行 Server Component、組頁面的地方;部署後會在 Vercel 上 |
| Supabase | Data API 加上資料庫 |
使用者打開網頁時,請求先送到伺服器。伺服器去資料庫拿資料、組成完整的 HTML,再將完整的HTML 送回瀏覽器。
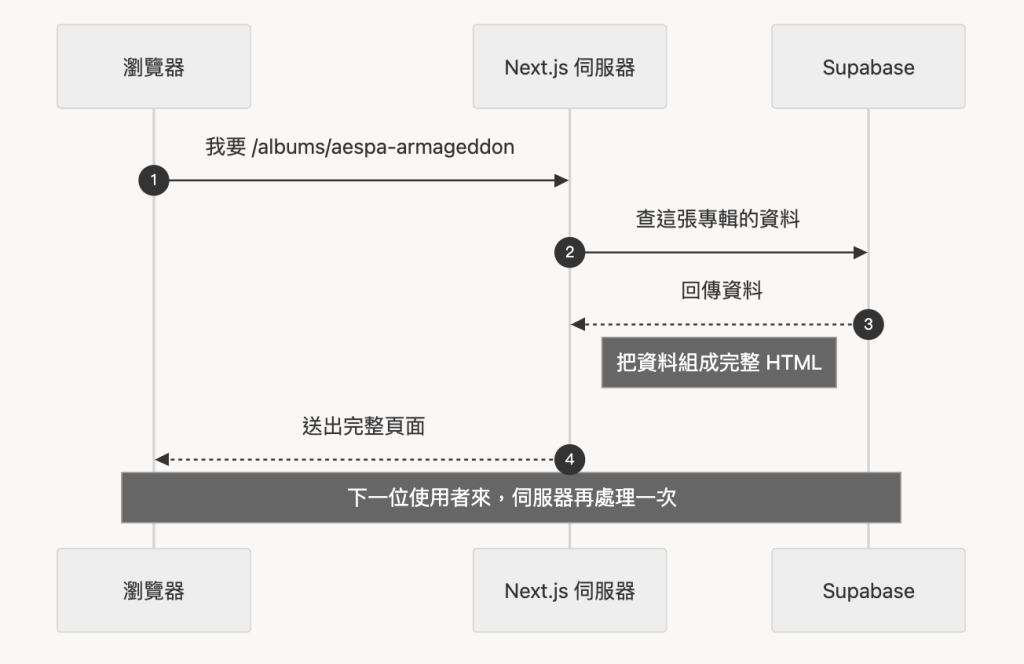
【圖 1|SSR 時序圖】
使用者拿到的會是完整的頁面,每次請求都要由伺服器產生;至於資料是否每次重查,還要看快取的設定。這個專案目前的實作中,首頁和專輯列表頁目前就是這種。
這是 SSR 的基本流程。Next.js 也可以先送出已經準備好的部分,比較慢的區塊先顯示載入畫面,之後再補上,這叫做串流(Streaming);後面的 loading.tsx 就跟它有關。
通常比較適合:每個人看到的不一樣,或資料需要即時,又希望搜尋引擎看得到內容的頁面,例如帳號頁、商品價格。代價是每次請求都要伺服器處理,負擔和等待時間有時候會比較多。
伺服器會先送出頁面的空殼並執行程式;瀏覽器執行程式後,再去拿資料、組出畫面。
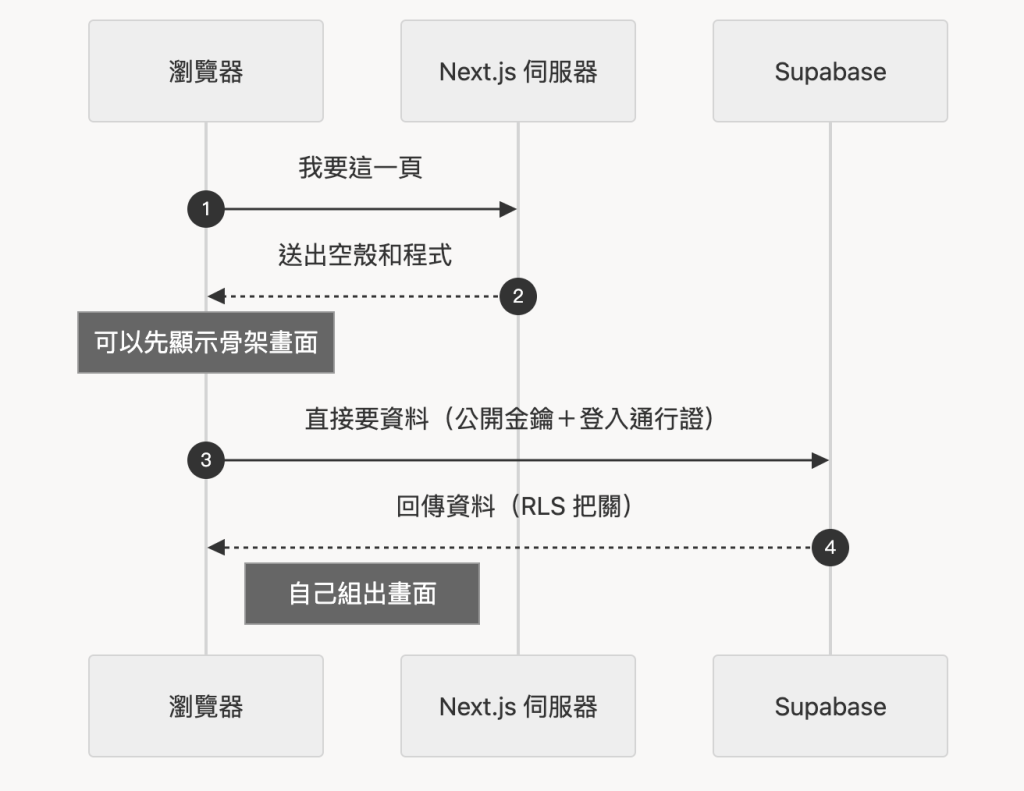
【圖 2|CSR 時序圖】
這是典型的 CSR 流程。目前專案中的收藏清單就是由瀏覽器自己去拿:訪客的收藏存在瀏覽器裡;登入後,瀏覽器透過 Data API 取得帳號收藏,由 RLS 把關。但收藏頁的專輯目錄仍由伺服器先載入,所以整頁其實是混合的。
比較適合:每個人不一樣、互動多、不太需要被搜尋到的畫面,例如個人收藏、管理後台。代價是第一眼要等程式和資料都到了才看得到內容,想被搜尋到的內容也要另外注意。
在 build 時,就先把資料拿好、把頁面做好。使用者來的時候,直接拿現成的頁面,不用再查資料庫。
build 是把程式整理成正式版本的步驟;部署到 Vercel 時,會先 build 再上線。所以 SSG 的頁面,通常是在每次部署時重新產生。
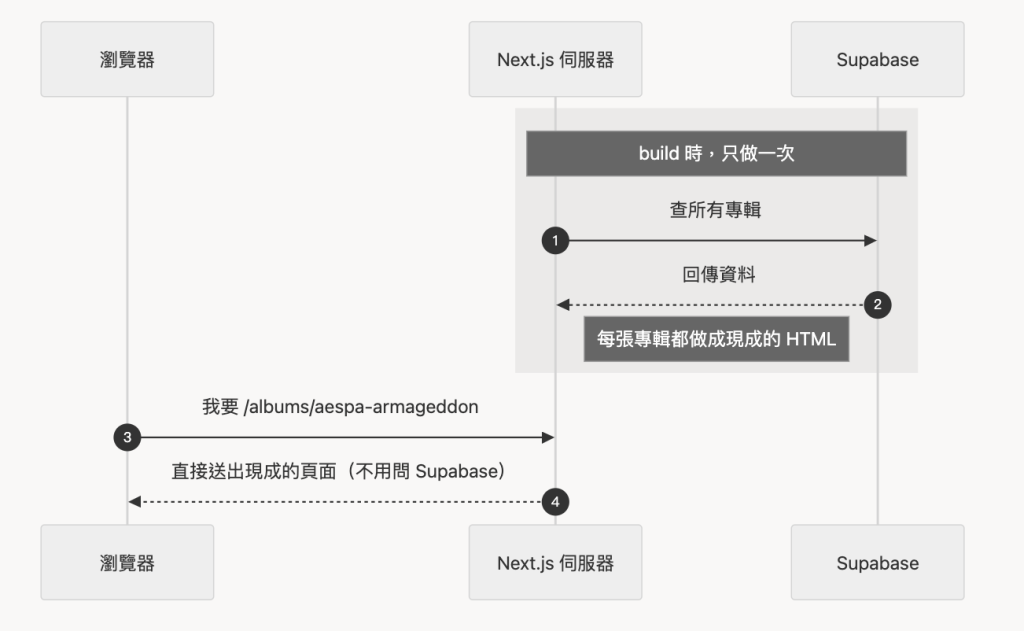
【圖 3|SSG 時序圖】
SSG 也不一定只在 build 時產生:像專輯詳情這種動態路由,可以只在 build 時先產生部分網址,其他網址也可能在第一次有人造訪時才產生,要看路由的設定。
比較適合:大家看到的都一樣、很少變動的內容,例如「關於我們」、說明文件。代價是資料改了,頁面不會自動跟著變,通常要重新 build、重新部署。
ISR 可以看成 SSG 的延伸:平常像 SSG 一樣,直接送出現成的頁面;需要更新時,才像 SSR 一樣,由伺服器重做一次。
具體來說,一樣先把頁面做好,但設定一個有效時間。超過時間後,下一個請求進來時才會觸發重做:有效時間內造訪的訪客會先拿到現有存在的那份,之後的人才拿到新的。也可以在資料更新時,由程式主動要求重做。
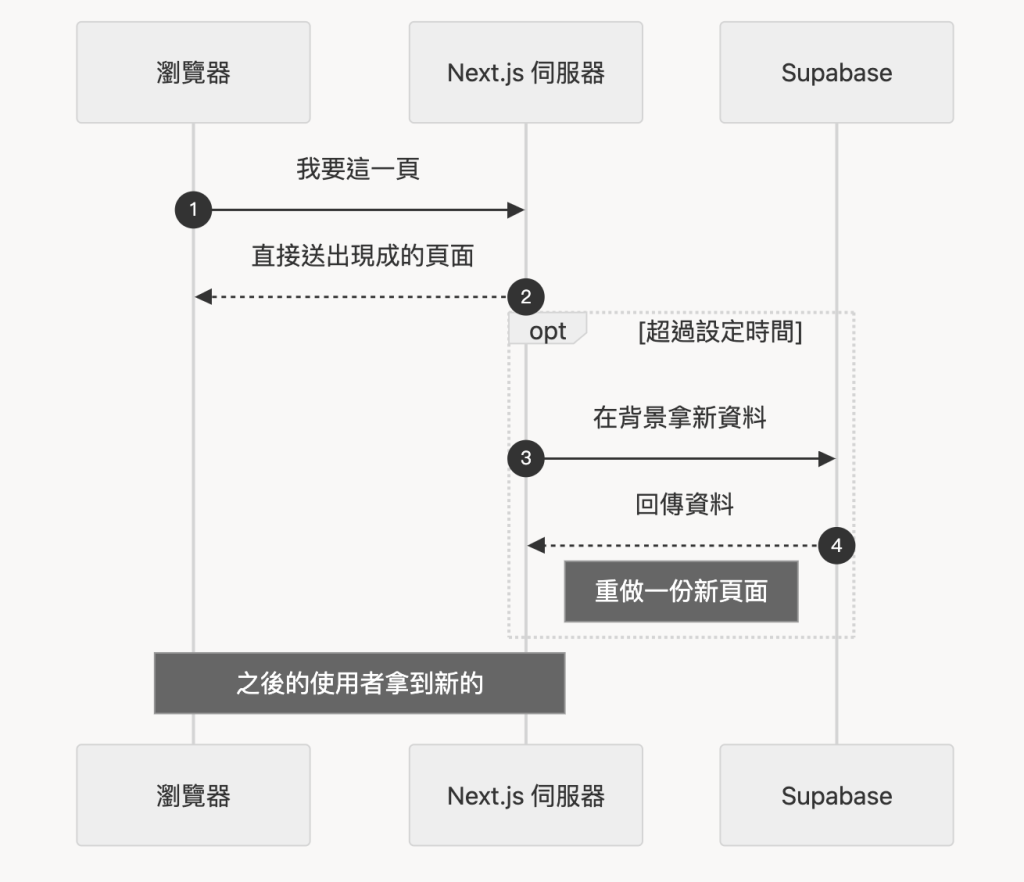
【圖 4|ISR 時序圖】
比較適合:大家看到的都一樣、偶爾會改的內容,例如部落格文章、商品介紹。代價是資料更新後,可能有一小段時間還看得到舊的版本。
四種方式各有取捨,沒有哪一種一定最好,也不一定只能用一種,可以混合。選擇時,通常可以先問三個問題:
| 問題 | 方向 |
|---|---|
| 每個人看到的一樣嗎? | 不一樣(例如有登入狀態、個人資料)時,通常會考慮 SSR 或 CSR |
| 資料多久變一次? | 幾乎不變可以考慮 SSG;偶爾變可以考慮 ISR;需要即時則傾向 SSR 或 CSR |
| 需要被搜尋引擎找到嗎? | 需要的話,比較不適合只靠 CSR |
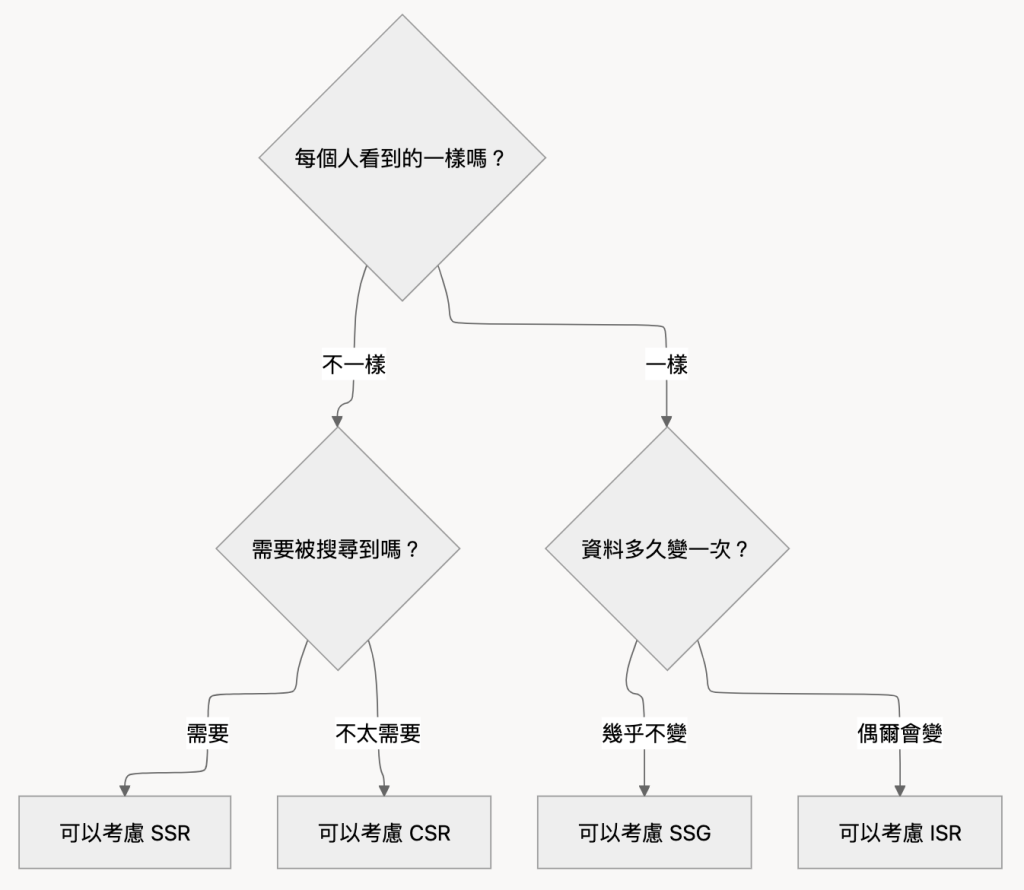
【圖 5|選擇渲染方式的參考流程】
這只是一個起點。實際上還要考慮資料量、伺服器成本、團隊熟悉度;同一個網站裡,不同頁面的答案也可能不一樣。
這些不是 Next.js 才有的概念。早期用 PHP、Django 寫的網站大多是 SSR;早期的 React、Vue 單頁應用程式是 CSR;部落格常用的 Hugo、Jekyll 則是 SSG。Next.js 的特色,是讓同一個專案裡的每一頁,都可以選不同的方式。
搜尋引擎看的是 HTML
SSR、SSG、ISR 送出去的 HTML 裡就有完整內容;CSR 一開始只有空殼,內容要等 JavaScript 跑完才出現。Google 會執行 JavaScript,但可能比較晚才處理;很多社群平台產生分享預覽時則不會執行。所以想被搜尋到的內容,最好一開始就在 HTML 裡。
目前的專輯詳情內容由伺服器產生,HTML 裡已經有完整內容。搜尋結果頁(
?q=...)通常不需要被收錄,所以搜尋在瀏覽器過濾,不影響 SEO。
我請 Codex 只讀、不改,盤點每一頁的資料從哪裡來、畫面在哪裡組成,再從原始碼、正式版的 build、實際的回應三個地方交叉確認:
| 頁面 | 資料取得與畫面處理 | 渲染方式 |
|---|---|---|
| 首頁 | 伺服器取得最新專輯和藝人、組好頁面;瀏覽器負責互動 | SSR |
| 專輯列表(含搜尋) | 伺服器載入整份目錄;瀏覽器過濾手上的資料 | SSR |
| 專輯詳情 | 伺服器取得專輯資料;瀏覽器負責版本切換和收藏 | build 標 SSG,實際接近 SSR(見 2.1) |
| 我的收藏 | 伺服器載入專輯目錄;瀏覽器自己去拿收藏清單 | SSR + CSR |
| 登入頁 | 伺服器判斷是否已登入;瀏覽器執行登入流程 | SSR |
| 帳號頁 | 伺服器確認身分後組好頁面;瀏覽器提供登出按鈕,登出由伺服器執行 | SSR |
build 輸出的 ƒ(Dynamic)代表有人請求時才由伺服器產生,也就是 SSR;● 代表 SSG。
不過 build 只看得出整頁 HTML 在哪裡產生。頁面送到瀏覽器之後,瀏覽器會不會自己再去抓資料,要看程式。判斷是不是 CSR 的關鍵是:頁面上的內容,是不是瀏覽器自己拿資料、再組出來的。只是在瀏覽器裡點按鈕、過濾手上已有的資料,不算 CSR。照這個標準,專案中目前只有收藏清單用到 CSR。
每一頁都是伺服器和瀏覽器分工,但分工的方式不一樣。
專輯詳情頁「大家看到的都一樣、很少改」,build 也確實把它標成 ● SSG,列出了 25 張專輯的網址。看到 ●,很容易以為使用者拿到的就是事先做好的頁面。
但如果要確認,就得看實際的回應。這裡有個特別的地方:目前實作的專輯詳情有兩種呈現,從列表點進去會開側邊欄,直接打開網址才是完整的詳情頁。兩者網址相同,背後卻是不同的路由,側邊欄在 build 裡本來就是 ƒ。
所以要檢查詳情頁,得把網址貼到新分頁,在 Network 裡找類型是 document 的那個請求,看 Response Headers:
Cache-Control: private, no-cache, no-store, max-age=0, must-revalidate
意思是:這份回應不能被快取,也不能像靜態頁面一樣,重複提供給不同的人。
原因在最外層的版面(根 layout)。為了讓右上角一出現就顯示正確的登入狀態,伺服器要讀使用者的 cookie。build 時確實處理了這 25 個網址,但加上登入狀態之後的完整頁面,每個人都可能不一樣,所以完整回應仍然不能共用。
工具標的分類,不一定等於使用者拿到的結果;看到的請求,也不一定是你以為的那一個。要確認,就看實際的回應。
Codex 也評估了,以目前的架構來說,改成 ISR 要動哪些地方:登入狀態改由瀏覽器判斷、導覽列要多一個「還不確定」的狀態、登出流程要重新設計、收藏要等登入狀態確定才能載入、資料快取策略要另外規劃。另一種做法,是把公開頁面和需要登入的頁面拆成不同的版面。不管哪一種,都不是純粹加一行設定就能完成。
| 維持現狀 | 改成 ISR | |
|---|---|---|
| 回應 | 依每個人的登入狀態組成,不能共用快取 | 公開內容和個人內容拆開後,可以共用 |
| 資料新鮮度 | 改了馬上看得到 | 要設定多久更新 |
| 右上角登入狀態 | 一出現就正確 | 可能要等一下才確定 |
| 要改的範圍 | 無 | 登入、登出、收藏、快取,或版面拆分 |
而目前我的決定是先不改,等到資料量變大、需要更快的首頁和分享預覽,或部署後量到第一次載入真的偏慢,再回來處理。
設計搜尋(或是取得/過濾資料)時,其實有兩個要考量的點:在哪裡找(方式),和什麼時候找(時機)。兩者可以自由搭配、組合。接下來這邊,以搜尋/篩選專輯的流程為例子來分享、舉例。
常見的做法大致有三種。差別在於:關鍵字送出去之前,資料會在哪裡?由誰負責找?
A 瀏覽器過濾:打開頁面時,就把全部資料送到瀏覽器;之後打字,瀏覽器直接從手上的資料裡找/過濾。
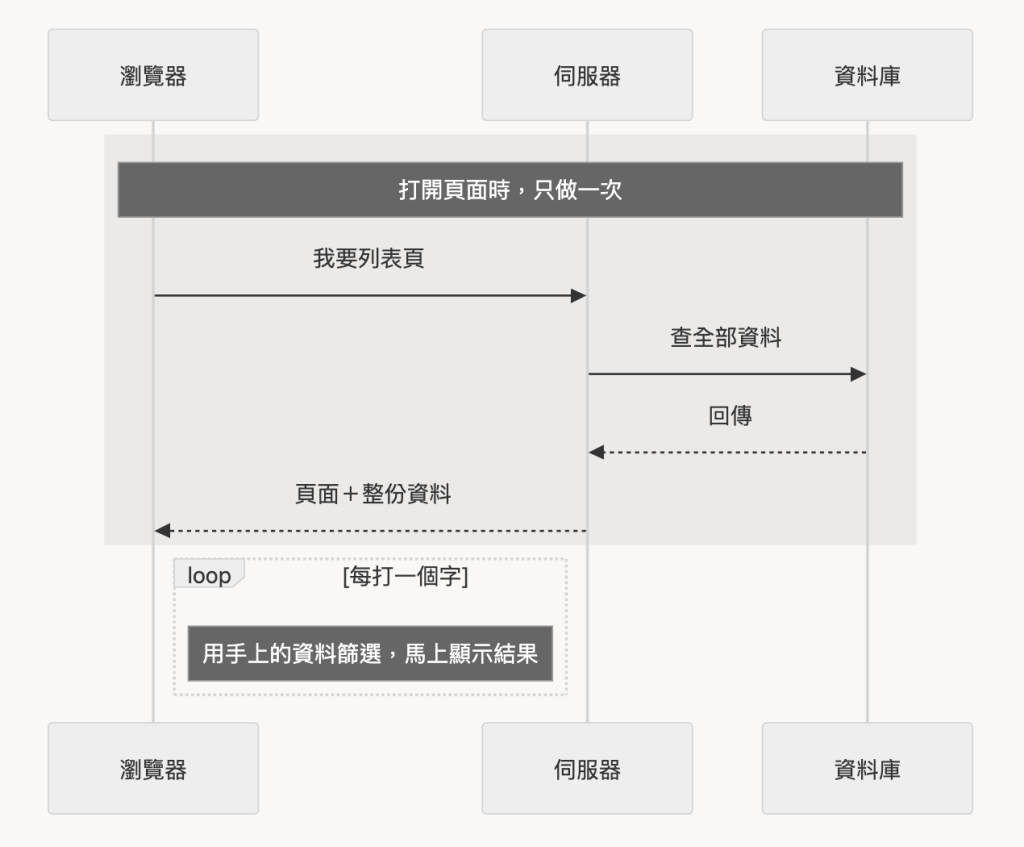
【圖 6A|瀏覽器過濾】
B 資料庫查詢:瀏覽器手上沒有全部資料。使用者送出搜尋後,才把關鍵字送出去,由資料庫找出符合的資料。
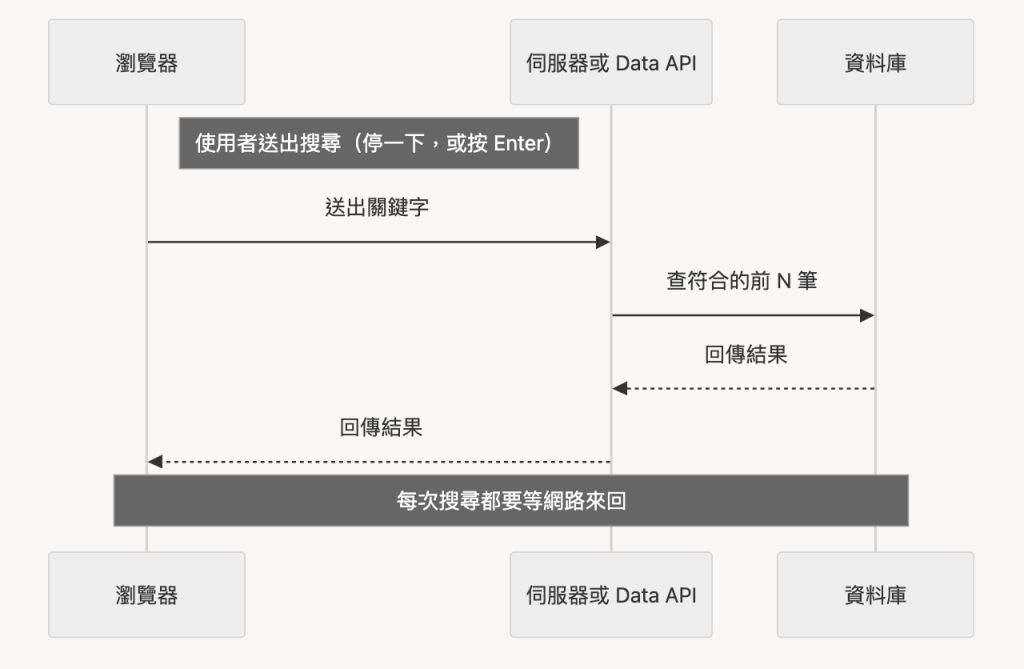
【圖 6B|資料庫查詢】
C 搜尋服務:資料事先同步到專門的搜尋引擎,搜尋時由它負責找,並依相關度排序、容忍打錯字。可以用外部的雲端服務(例如 Algolia),也可以自己架設開源的搜尋引擎(例如 Meilisearch),通常不需要從零自己寫。
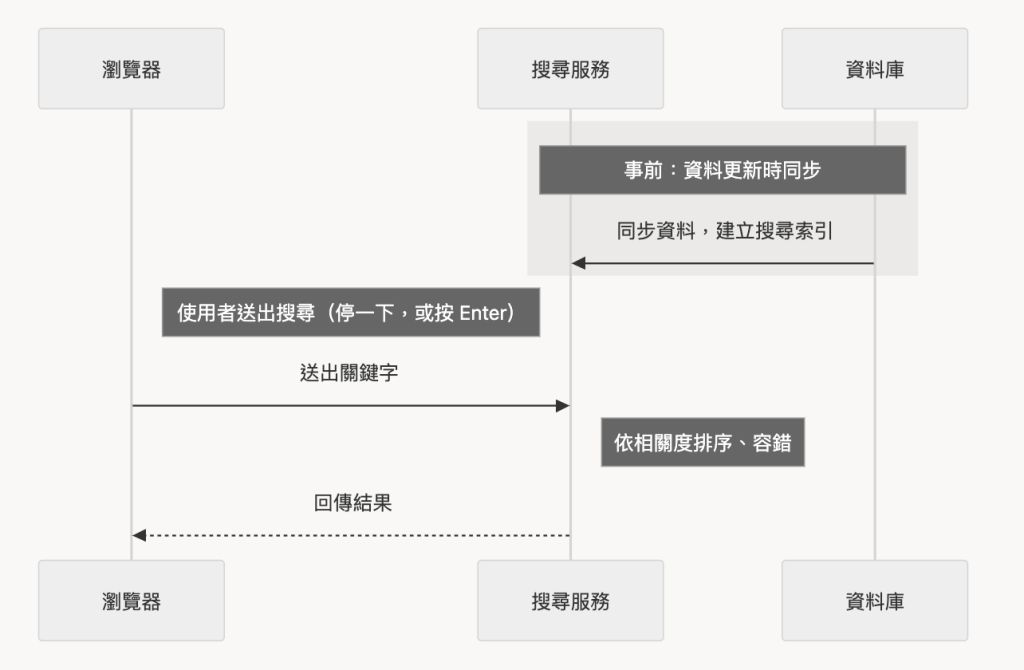
【圖 6C|搜尋服務】
| 比較適合 | 優點 | 限制 | |
|---|---|---|---|
| A 瀏覽器過濾 | 資料少、不常變 | 打字不用等網路 | 資料越多,第一次載入越重 |
| B 資料庫查詢 | 資料中到大 | 只傳需要的資料 | 每次搜尋都要等網路,要處理分頁 |
| C 搜尋服務 | 資料大,或需要容錯、相關度排序 | 打錯字也可能找得到 | 多一個服務要維護,可能要付費 |
怎麼選,可以先從資料量和搜尋品質的需求來看:
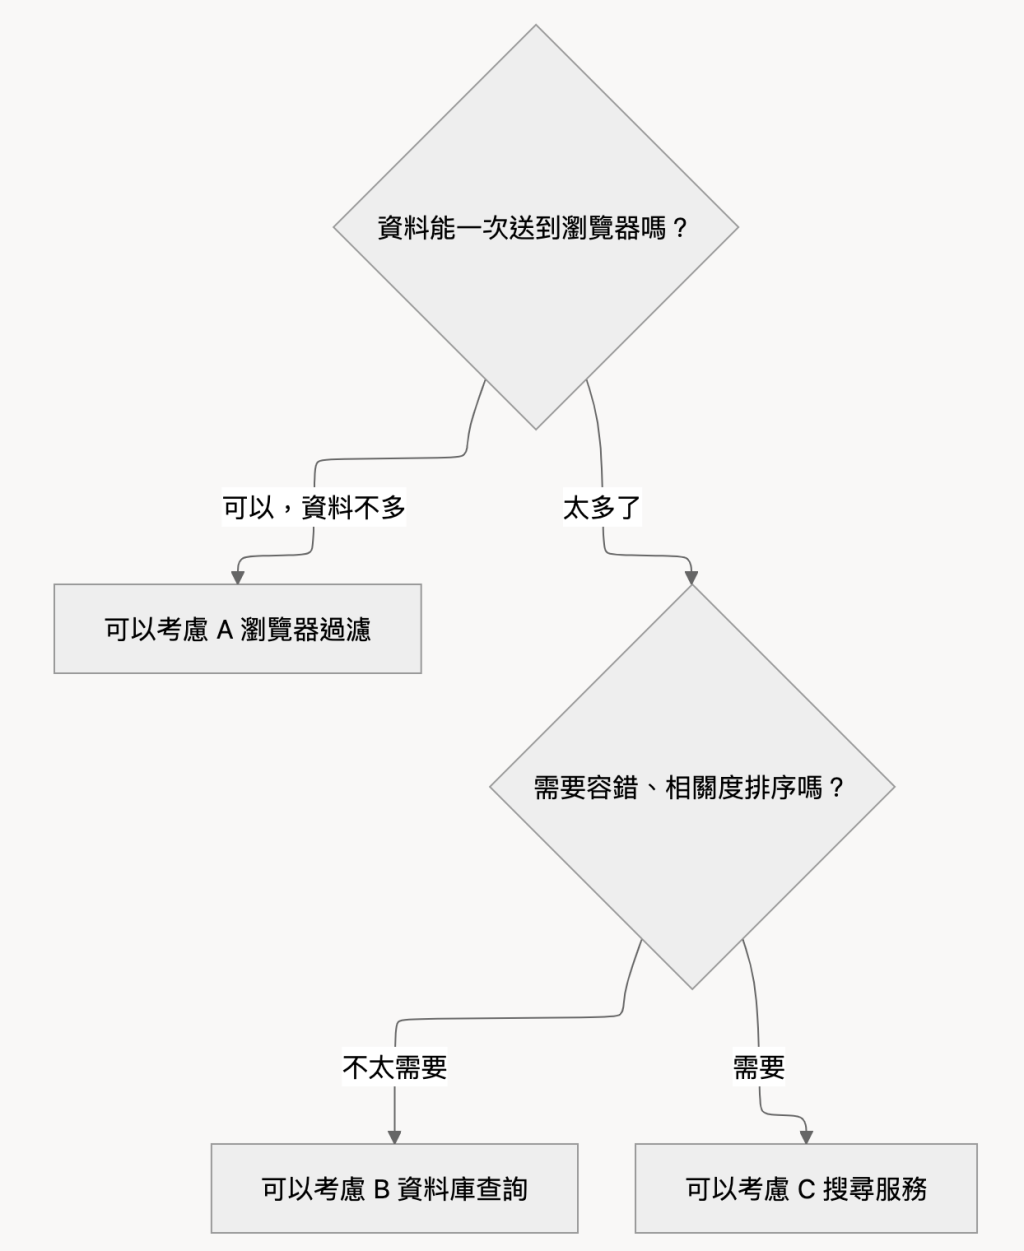
【圖 7|選擇搜尋方式的參考流程】
決定在哪裡找之後,還可以決定什麼時候送出搜尋/過濾的請求:
| 時機 | 優點 | 代價 | 常見搭配 |
|---|---|---|---|
| 每打一個字 | 最即時 | 如果要問伺服器,請求會很多 | A(本來就不用問伺服器) |
| 停一下才送出 | 在即時感和請求數之間取得平衡 | 要多處理「舊結果比較晚回來」的情況 | B、C 的即時搜尋 |
| 按 Enter 或搜尋鍵 | 請求最少,也最好預測 | 使用者要多按一下 | B、C,特別是條件很多的搜尋 |
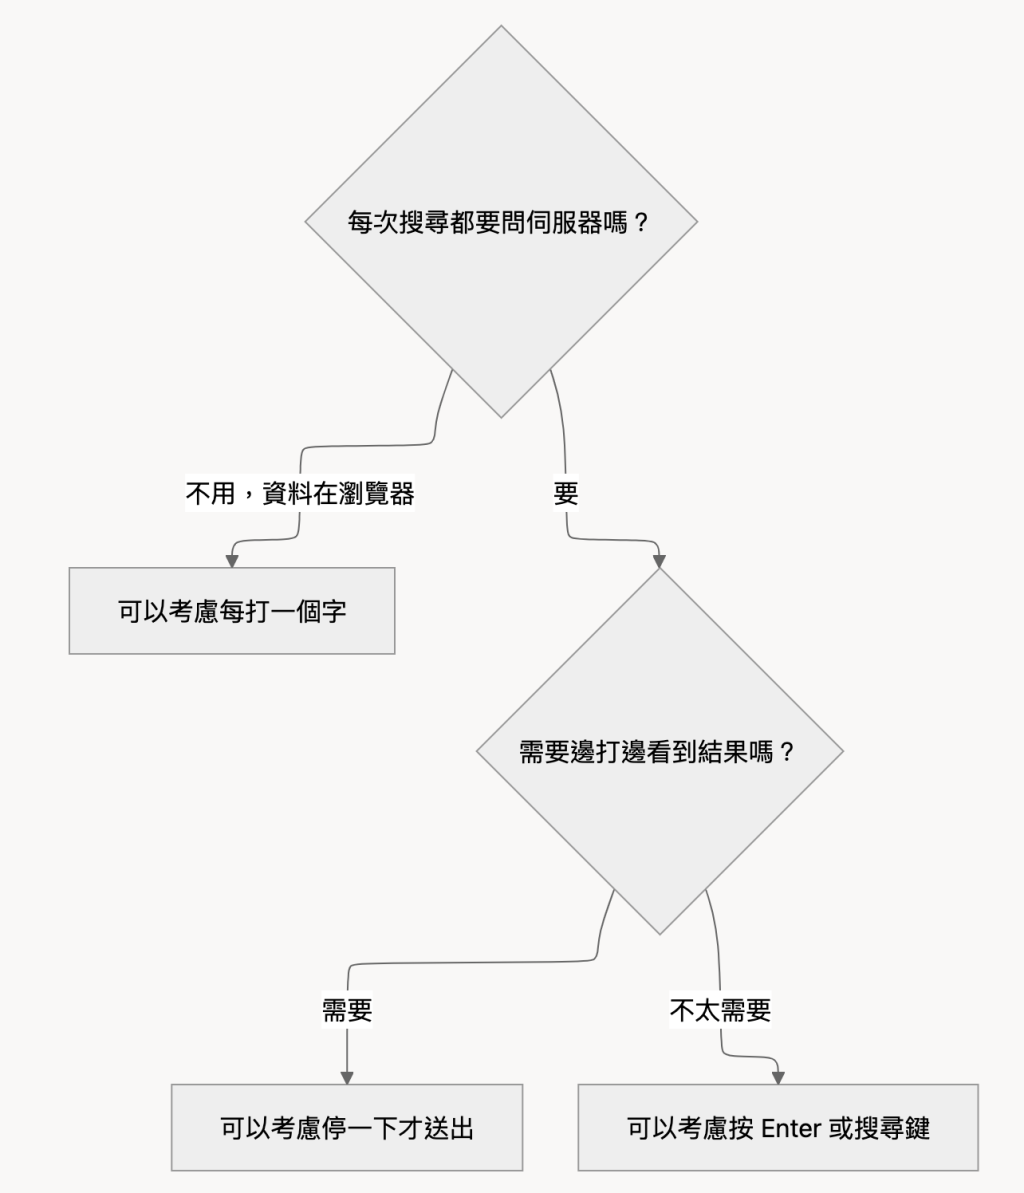
【圖 8|選擇搜尋時機的參考流程】
規劃的過程中,通常也需要想好搜尋條件怎麼保存(例如放在網址裡,方便分享和按上一頁),以及一次回傳多少筆資料。
目前在專案中,AI 撰寫的方式使用的是「A 瀏覽器過濾」加上「每打一個字母就過濾一次」。目前只有 25 張專輯,打開列表頁時,伺服器就把整份目錄交給瀏覽器,後續使用者打字時,瀏覽器直接在手上的資料裡篩選。以這個規模,這樣的組合算是合理的。但是未來資料量假設越來越多,這種情況可能就會造成使用者體驗下降。
AI 會這樣實作,有許多可能的因素。一方面我們從來沒有要求過,另一方面,他也不知道資料量到底有多多。
前面有提到瀏覽器過濾適合「現在」的專案,但並不代表永遠適合。資料變多時,會遇到三個問題:
| 問題 | 原因 |
|---|---|
| 第一次載入越來越重 | 目前列表頁會連同每張專輯的版本、款式、內容物一起送到瀏覽器,但搜尋用不到這些 |
| 資料可能默默被截斷 | Supabase 的 Data API 預設一次最多回傳 1000 筆;沒有分頁的話,超過的專輯不會出現,畫面也不會提示 |
| 篩選會變慢 | 每打一個字,都要掃過全部資料 |
通常會分兩步調整,可以不用一次就直接改成資料庫搜尋:
第一步:只送搜尋需要的欄位(標題、藝人名稱),不送版本和內容物 → 一樣在瀏覽器過濾,但輕很多

第二步:資料多到連精簡版都太重時,列表改成分頁,搜尋改成 B 資料庫查詢 → 時機改成停一下或按 Enter 才送出、只回傳前 N 筆、加上適合文字搜尋的索引
實際上,很多網站會混合搭配:瀏覽列表時分頁,一次只拿一部分資料;搜尋時,則把關鍵字送到資料庫,從全部資料裡找。也有網站只把標題、名稱這類輕量資料送到瀏覽器,用來即時顯示搜尋建議,按下 Enter 後再到資料庫查完整結果。
要注意的是,分頁之後可能就不適合再只靠瀏覽器過濾。瀏覽器手上只有目前這一頁,搜尋結果會不完整,而且畫面不會提示少了什麼。
什麼時候該換,沒有固定的筆數標準。看的是第一次載入的資料量,以及使用者有沒有感覺到慢。
只要畫面要等資料,就不會只有「成功」一種結果。
| 狀態 | 使用者應該看到 | 目前專案的實作 |
|---|---|---|
| 載入中 | 骨架畫面,知道網站正在處理 | 收藏頁已有、列表頁還沒有 |
| 成功 | 結果 | ✓ |
| 空的 | 「找不到」,加上下一步建議 | 搜尋已有,並提供重設按鈕 |
| 錯誤 | 發生了什麼事 | 還沒有,之後補上 |
| 重試(操作) | 一個可以再試一次的按鈕,按下後回到載入中 | 還沒有,之後補上 |
等待時,一定要用骨架畫面嗎?
不一定,常見的有三種:
- 骨架畫面(Skeleton):已經知道內容大概長什麼樣子時,例如專輯卡片列表
- 載入動畫(Spinner):不容易預先畫出內容輪廓時,例如按下送出後
- 進度條(Progress Bar):真的知道進度時,例如上傳檔案
重點不是哪一種比較好看,而是讓使用者知道:網站還在處理,還是真的出問題了。不知道實際進度時,就不要做一條跑到 90% 就停住的進度條。
Next.js 對其中兩種提供了固定的做法:
loading.tsx:頁面還沒準備好時,先顯示這個畫面error.tsx:捕捉這個頁面沒處理到的錯誤,顯示這個畫面,並可以提供重試按鈕(外部服務還沒恢復的話,重試仍可能失敗)原本列表頁如果連不上資料庫,使用者只會看到 Next.js 預設的錯誤頁。現在至少會知道發生什麼事,也能自己再試一次。
設計一個需要讀取資料的畫面時,可以先列出這四種狀態和重試的方式,而不是只設計成功的那一種。
就算平常很快,第一次進入網站時也可能比較慢,常見的原因有三個:
| 原因 | 意思 |
|---|---|
| 冷啟動 | 某些雲端服務閒置一段時間後,第一個請求要多等它重新啟動 |
| 第一次下載 | 瀏覽器第一次要下載網站的程式和圖片,之後才有快取 |
| 沒有快取 | 頁面或資料沒有事先準備好,每次都要重新查 |
本機開發和正式部署的環境不一樣,這些要等部署之後,在真實環境量過才知道。重點是:慢的時候先量,找出時間花在哪裡,再決定怎麼改,不要先猜,也不要直接叫 AI「幫我優化」。
| 產品 | 頁面 | 常見的渲染方式 | 常見的搜尋/過濾方式 |
|---|---|---|---|
| 新聞網站 | 首頁、文章頁 | ISR:大家看都一樣,每幾分鐘更新 | 文章很多,通常交給資料庫或搜尋服務,按 Enter 送出 |
| 電商 | 商品列表、商品頁 | ISR;價格、庫存另外即時查 | 列表分頁;搜尋常交給搜尋服務,停一下就顯示建議 |
| 電商 | 購物車、訂單 | SSR 或 CSR:每個人不一樣 | 自己的訂單通常不多,可以在瀏覽器過濾;很多時改由伺服器查詢 |
| 線上文件 | 文件內容 | SSG:很少變 | 事先整理成精簡索引,在瀏覽器搜尋,每打一個字就更新 |
| 公司後台 | 資料表、報表 | CSR 或 SSR:要登入,不需要被搜尋到 | 資料多,交給資料庫查詢並分頁,設定好篩選條件後才送出 |
同一個網站,不同頁面可以用不同的方式。選渲染方式時,可以先問:每個人看到的是否一樣?資料多久會變?需要被搜尋到嗎?選搜尋方式時,則看資料有多少、需不需要容錯,以及使用者期待多即時的結果
今天沒改動什麼程式碼,但終於看清楚了:一個畫面背後,資料在哪裡、在什麼時候被組成。
快,不只是縮短等待。等待時看到什麼、失敗時能做什麼,也是體驗的一部分。而有些看不見的浪費,可以透過打開DevTools 的 Network 頁籤來進行排查、分析。
到目前為止,網站已經能讓訪客回報錯誤、讓使用者收藏專輯。但回報送進來之後,我只能從 Telegram 一則一則看。哪些處理過了?哪些還沒?
一般使用者只能碰自己的收藏;管理者卻需要看別人送進來的回報。那網站怎麼分辨,誰真的有管理權限?
明天,我們來實作回報管理後台:一個只有管理者看得到的地方。
我們明天見。


 iThome鐵人賽
 看影片追技術