
前二十天,我們一路把 Single-Agent 做完整。
它現在會:
讀程式碼
使用 MCP Tool
根據 Observation 繼續推理
遵守工具與路徑限制
高風險操作先等人工核准
留下執行紀錄
接下來十天開始進入 Multi-Agent。
不過先別急著開三個模型,再替它們取三個名字。
把同一段 Prompt 跑三次,不一定會更可靠,通常只會更慢。
今天先處理一個更實際的問題:
如果同一個 Agent 同時負責找資料、寫內容、再替自己審查,責任還看得清楚嗎?
所以第一步不是增加 Agent 數量。
而是先拆工作。
這次沿用前面的 devbench。
假設任務是:
研究專案程式碼
↓
整理成開發文章
↓
確認文章有沒有說錯
如果全部交給同一個 Agent:
Agent
├── 自己找證據
├── 自己寫文章
└── 自己檢查自己
流程可以跑。
但只要最後內容有問題,就很難回答:
是資料找錯了?

還是證據其實是對的,但文章寫歪了?

還是 Reviewer 根本沒有真的重新檢查?
所以今天先拆成三個角色:
Research
Writer
Reviewer
不是因為三個 Agent 比一個 Agent 高級。
而是因為三種工作本來就有不同責任。
第一個角色是 Research。
它只負責找資料與證據。
所以它可以使用前面做好的唯讀 MCP Tools:
read_file
list_files
第二個是 Writer。
它的工作是根據 Research 交接過來的資料產生草稿。
它不需要:
讀檔
執行 Shell
修改專案
所以一個 Tool 都不給。
第三個是 Reviewer。
它負責:
對照來源
檢查草稿
指出不一致
決定是否需要修訂
同樣不需要直接操作檔案。
整體流程變成:
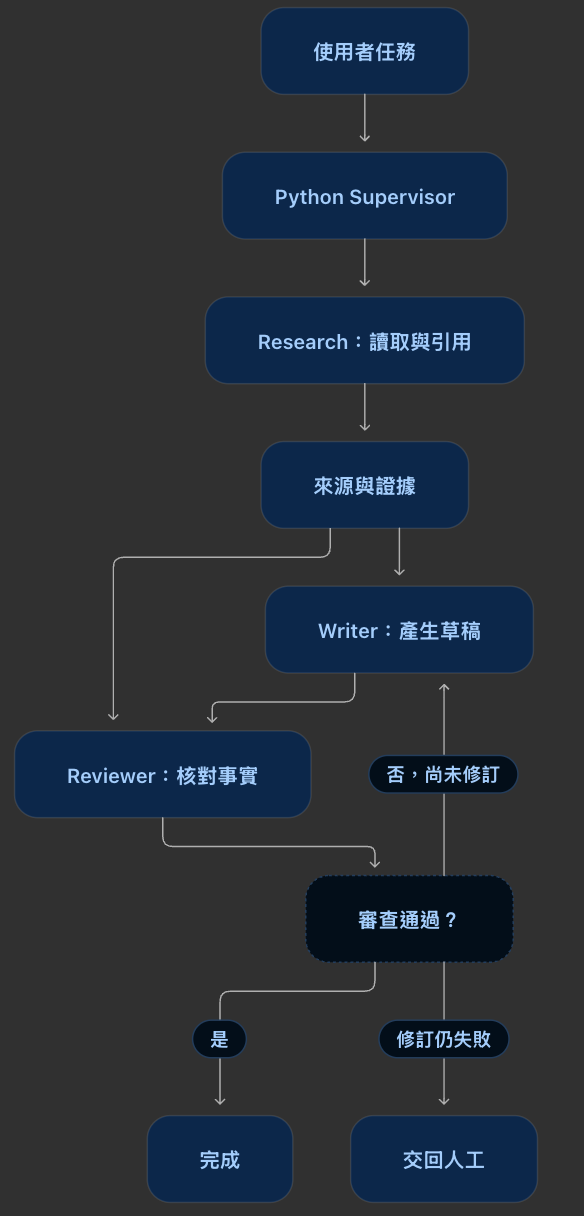
這裡最重要的不是三個角色名稱。
而是:
Research 有讀取權限

Writer 沒有 Tool

Reviewer 也沒有 Tool
每個角色只拿完成自己工作需要的能力。
Day 19 講的最小權限,到了 Multi-Agent 不能消失。
反而要拆得更細。
看到 Multi-Agent,很容易順手再加第四個模型:
Supervisor Agent
但今天不這樣做。
Supervisor 先用普通 Python。
它只負責:
現在輪到哪個角色
資料要交給誰
Reviewer 有沒有通過
已經修訂幾次
什麼時候該停止
例如:
Research
↓
Writer
↓
Reviewer
↓
通過 → 完成

沒通過
↓
Writer 修一次
↓
Reviewer 再檢查

還是失敗
↓
交回人工
這些規則其實很確定。
沒有必要為了「看起來更 Agent」就再呼叫一次 LLM 決定:
現在是不是應該讓 Writer 重寫?
能用程式寫清楚的流程,先用程式。
這樣至少我們知道終止條件在哪裡。
這裡也有一個容易卡住的問題:
流程是固定的,那這還叫 Multi-Agent 嗎?
可以。
Multi-Agent 不代表一定要:
Agent A 自由找 Agent B
Agent B 再自由委派 Agent C
三個 Agent 自己聊天到高興
今天比較像:
外層
→ 固定 Workflow

內層
→ 不同職責、Prompt 與權限的 Agent
兩者可以同時存在。
反過來,如果流程中的每一個步驟只是:
strip_text()
format_markdown()
save_json()
那也沒必要硬把每個 Function 都叫做 Agent。
我比較在意的是:
這個角色是否真的需要模型判斷?

它是否有自己的責任邊界?

輸入和輸出是否明確?

權限是否和其他角色不同?
如果都沒有,拆成 Agent 通常只是增加複雜度。
Research 不會在執行到一半突然說:
這題交給 Writer
Writer 也不能再反過來叫 Research:
你再幫我多找一個檔案
所有交接都經過 Supervisor。
流程刻意長這樣:
Research
↓
Supervisor
↓
Writer
↓
Supervisor
↓
Reviewer
少了一點自由。
但換來幾個好處:
誰呼叫誰很清楚
資料從哪裡來很清楚
修訂最多幾次很清楚
什麼情況停止也很清楚
等真的有需求,再放寬 Agent 自己委派任務。
不是一開始就把所有控制權交出去。
另一個問題是:
Research 要把什麼交給 Writer?
最省事的做法可能是:
把 Research 整段 Conversation 全部丟給 Writer
但這很容易出問題。
例如 Research 曾經猜過一句:
我猜設定應該是在 config.py。
後來才真的找到證據。
如果整段歷史一起交接,Writer 可能分不清楚:
哪一句是早期猜測
哪一句才是已確認結果
所以今天傳遞的是比較明確的資料:
Task
Evidence
Source
Draft
Review Result
而不是:
Research 的完整聊天紀錄
+
Writer 的完整聊天紀錄
+
Reviewer 的完整聊天紀錄
Agent 之間的共享 Context 越大,不代表合作越完整。
有時候只是把前一個角色的錯誤也一起傳下去。
所以今天的原則是:
交接結果,不交接所有思考歷史。
今天先不啟動三個模型。
第一步只是把角色、責任和權限定義清楚。
例如:
# days/day21_supervisor/main.py

from ironman.supervisor import ROLES


def main() -> None:
    for role in ROLES:
        print(
            f"{role.name}: "
            f"{role.responsibility}; "
            f"tools={list(role.tools)}"
        )

    assert len(
        {role.name for role in ROLES}
    ) == 3

    assert not ROLES[1].tools
    assert not ROLES[2].tools

    print(
        "流程: "
        "Research -> Writer -> Reviewer "
        "-> 完成/最多修訂一次 -> 人工檢查"
    )


if __name__ == "__main__":
    main()
這樣角色不只是 Prompt 裡的一段描述。
程式可以直接檢查:
總共有幾個角色

名字是否重複

Research 有哪些 Tools

Writer 是否真的沒有 Tool

Reviewer 是否真的沒有 Tool
今天不會真的呼叫三次 LLM。
因為今天要驗證的是架構:
角色怎麼拆
權限怎麼分
資料怎麼交接
誰負責停止
明天才會把這份角色定義真的跑起來。
把一個 Agent 拆成三個角色,會得到比較清楚的責任。
但也會多出新的成本。
原本可能:
1~2 次 LLM Call
現在變成:
Research
+
Writer
+
Reviewer
+
可能再修訂一次
延遲與 Token 使用量一定增加。
Research 原本掌握完整原始內容。
交給 Writer 時如果摘要得太短,關鍵證據可能被壓掉。
所以 Handoff 本身也需要設計。
如果:
Research
Writer
Reviewer
全部使用同一個模型,Reviewer 還是可能和 Writer 犯同一種錯。
多一個角色不是獨立驗證的保證。
所以之後真正要量的不是:
Agent 有幾個
而是:
任務有沒有完成
證據能不能追溯
Reviewer 抓到多少問題
需要幾次修訂
模型呼叫幾次
成本增加多少
這些才是 Multi-Agent 有沒有價值的依據。
Day 20 結束時,我們有一個完整的 Single-Agent:
LLM
↓
Agent Loop
↓
MCP
↓
Security Policy
↓
Human Approval
今天先不增加能力。
而是把它拆成不同責任:
           Supervisor
          /     |     \
         /      |      \
 Research     Writer   Reviewer
    ↓
唯讀 Tools
而且 Supervisor 暫時不是第四個 LLM。
只是普通 Python。
因為現在真正需要解決的問題不是:
怎麼讓更多 Agent 自己講話?
而是:
不同角色之間,要怎麼交接資料,又怎麼知道整個流程真的完成?
明天把今天這張圖真的跑一次。
讓 Research 找證據、Writer 寫草稿、Reviewer 審查,最多修訂一次,再留下完整的共享狀態。
Day 22:
先做一個最小 Multi-Agent:任務交接、共享狀態與評估標準。


 iThome鐵人賽
 看影片追技術