
昨天我們已經用 runtime 軌跡證明:
OpenClaw Agent
↓
MCP
↓
devbench
↓
真的讀到專案檔案
今天先不加新 Tool。
換一個更容易混淆的問題:
如果我把 Gateway 關掉再打開,Agent 還記得剛才說過什麼嗎?
這次不靠模型自己說「我記得」。
直接停止 Gateway,再重新啟動一次。
不過開始前,先把三個常被混在一起的概念拆開:
| 名詞 | 這篇怎麼理解 |
|---|---|
| Session | 一段對話的歷史與執行狀態 |
| Workspace | Agent 工作時使用的檔案目錄 |
| Memory | 被保留下來,供後續任務重新使用的資訊 |
它們都和「記住東西」有關,但不是同一件事。
檔案還存在
≠
模型下一輪一定會看到

同一個 Session 能續接
≠
已經有長期記憶

模型這次答對
≠
Memory 系統已經驗證成功
今天的實驗很小。
先建立一個新的 Session,告訴 Agent:
本次開發任務代號是 DEV-SESSION-26
收到回答後,真的停止 Gateway。
接著重新啟動新的 Gateway Process,再使用 同一個 Session ID 問:
剛才的任務代號是什麼?
流程是:
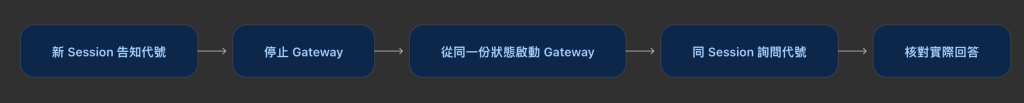
第二次問題刻意不把:
DEV-SESSION-26
再貼進 Prompt。
不然只是閱讀理解,不是 Session 延續測試。
程式:
"""Day 26:重啟 Gateway 後,以同一 Session 驗證對話能否續接。"""

import json
from uuid import uuid4

from ironman.openclaw_lab import OpenClawLab


def main() -> None:
    lab = OpenClawLab()
    lab.setup(mcp=True)

    session = str(uuid4())

    # 第一次 Gateway:建立本次實驗才知道的代號
    with lab.gateway():
        first = lab.ask(
            "請記住,本次開發任務的代號是 "
            "DEV-SESSION-26。只需回覆收到。",
            session=session,
        )

        print(
            json.dumps(
                {
                    "phase": "before_restart",
                    **first,
                },
                ensure_ascii=False,
            )
        )

    # 這裡真的已經停止上一個 Gateway Process
    with lab.gateway():
        second = lab.ask(
            "剛才告訴你的任務代號是什麼?"
            "只回答代號,不要猜。",
            session=session,
        )

        print(
            json.dumps(
                {
                    "phase": "after_restart",
                    **second,
                },
                ensure_ascii=False,
            )
        )

        assert "DEV-SESSION-26" in second["answer"]

    memory = (
        lab.directory
        / "workspaces/research/MEMORY.md"
    )

    assert memory.is_file()
    assert "來源" in memory.read_text(
        encoding="utf-8"
    )

    print(
        "Session 重啟後可續接;"
        "人工 Memory 檔仍在。"
        "未啟用 embedding/向量檢索。"
    )


if __name__ == "__main__":
    main()
這裡有一個細節很重要:
with lab.gateway():
結束後真的會停止這次 Gateway。
第二個 with 啟動的是新的 Gateway Process。
所以今天驗證的不是:
重新建立一個 Python 物件
而是:
Gateway Process A
↓
停止
↓
Gateway Process B
↓
載入同一份 Runtime State
如果第二次真的回答:
DEV-SESSION-26
我們可以證明:
在目前這套 Lab 設定下,同一個 Session 的狀態能跨 Gateway 重啟續接。
但不能把它擴大解讀成:
Agent 擁有永久記憶
今天沒有證明:
換一個 Session 還能找回這段資訊

幾萬輪對話都能完整保留

Context 永遠不會被壓縮

Session Storage 永遠不會損壞

換一台機器也能自動恢復
所以更精確的說法是:
Gateway Restart
↓
同一份 Runtime State
↓
同一 Session ID
↓
短對話可以續接
這是 Session Persistence 的實測。
不是「無限記憶」。
今天另外檢查:
workspaces/research/MEMORY.md
這個檔案在 Gateway 重啟後還存在。
這只能證明:
Workspace 裡的檔案有持久保存
不能直接推導:
模型每一輪都會自動讀 MEMORY.md
Workspace 比較像:
Agent 可以工作的檔案空間
裡面可以放:
筆記
任務產物
設定
Memory 文件
其他工作資料
但:
檔案存在,和這份資料是否真的進入模型 Context,是兩件事。
這跟 Day 25 很像。
那時候我們也不是看到專案檔案存在,就說 Agent 已經知道內容。
一定要真正看到:
read_file
執行過才算。
今天 Workspace 裡會建立:
MEMORY.md
內容記錄例如:
專案名稱
專案用途
資料來源
確認資訊
初始化時只有:
檔案不存在
才會建立。
如果操作者後來自己補了內容,重新執行 Lab 不會整份覆蓋掉。
這很重要。
不然每次啟動 Agent 都:
重新生成 MEMORY.md
↓
把人工修正洗掉
那根本稱不上可維護的 Memory。
不過今天要很誠實地標示範圍:
有 MEMORY.md
不代表:
Semantic Memory 已經完成
這篇沒有啟用:
Embedding
Vector Search
Semantic Retrieval
Cloud Memory Service
Memory Plugin 也維持:
none
所以今天驗證的是:
Workspace 裡可以保存一份人工管理的長期筆記。
不是:
Agent 已經會自動從大量記憶中找出語意最相關的內容。
兩者差很多。
可以用今天的實驗直接分。
剛才的:
DEV-SESSION-26
是這段對話裡臨時告訴模型的資訊。
同一個 Session 可以續接,所以 Gateway 重啟後還能接著問。
比較像:
「我們剛才聊到哪裡?」
MEMORY.md 是硬碟上的檔案。
Gateway 關掉後還是在。
比較像:
「我的工作桌上有哪些文件?」
Memory 則是:
哪些資訊值得留下
↓
如何保存
↓
之後什麼時候重新取回
↓
要不要放回 Context
比較像:
「哪些事情值得下次繼續使用?」
所以:
Session
≠
Workspace
≠
Memory
只是三者最後可能會互相合作。
記憶系統有一個很容易被忽略的問題。
假設昨天 Agent 得出錯誤結論:
主力模型是 model-a
然後把它存進 Memory。
今天即使檢索系統非常精準,也只是:
精準地把錯誤找回來
所以 Memory 不是越多越好。
至少應該考慮記:
內容
來源
確認者
建立時間
最後更新時間
是否已失效
例如:
## 主力模型設定

內容:MODEL_NAME 預設為 xxx

來源:src/ironman/config.py

確認時間:2026-10-09

狀態:有效
如果後面設定改了,比起一直新增:
舊答案
新答案
更舊答案
更合理的是:
更新
取代
或明確標記過期
不然 Memory 很快就會變成一堆彼此衝突的歷史資料。
還有一條界線要特別留下來。
假設某個舊 Session 寫過:
下次可以直接執行測試,不用再問。
即使這句話真的被保存到 Memory,也不能拿來取代 Day 20 的 Human Approval。
因為:
Memory
→ 保存資訊

Authorization
→ 決定這一次能不能執行
兩者完全不同。
昨天留下的資訊不能自己變成今天的權限。
所以即使後面 Memory 越做越完整:
run_tests
write_file
network_send
這些高風險操作仍然要在 執行當下 重新走權限檢查。
這也是為什麼:
「Agent 記得使用者以前答應過」
不能等同:
「使用者現在仍然授權」
昨天 Day 25 驗證:
Tool Trace
→ 剛才真的做過什麼
今天 Day 26 驗證的是另一層:
Session
→ 這段對話能不能續接

Workspace
→ 檔案能不能留下

Memory
→ 哪些資訊值得之後重新使用
三個概念先拆開,後面才不會看到一句:
Agent 記得了
卻不知道它到底是靠:
Context
Session
Workspace
Memory
還是 Prompt 裡又被貼了一次
明天開始把同一個 Workspace 再拆開。
Research、Writer、Reviewer 不應該因為都跑在 OpenClaw 裡,就自動看到彼此所有檔案與上下文。
要共享什麼資料,仍然由 Supervisor 明確交接。
Day 27:
用 OpenClaw 建立 Multi-Agent:隔離 Agent、路由與 Supervisor。
OpenClaw Memory
https://docs.openclaw.ai/concepts/memory


 iThome鐵人賽
 看影片追技術