

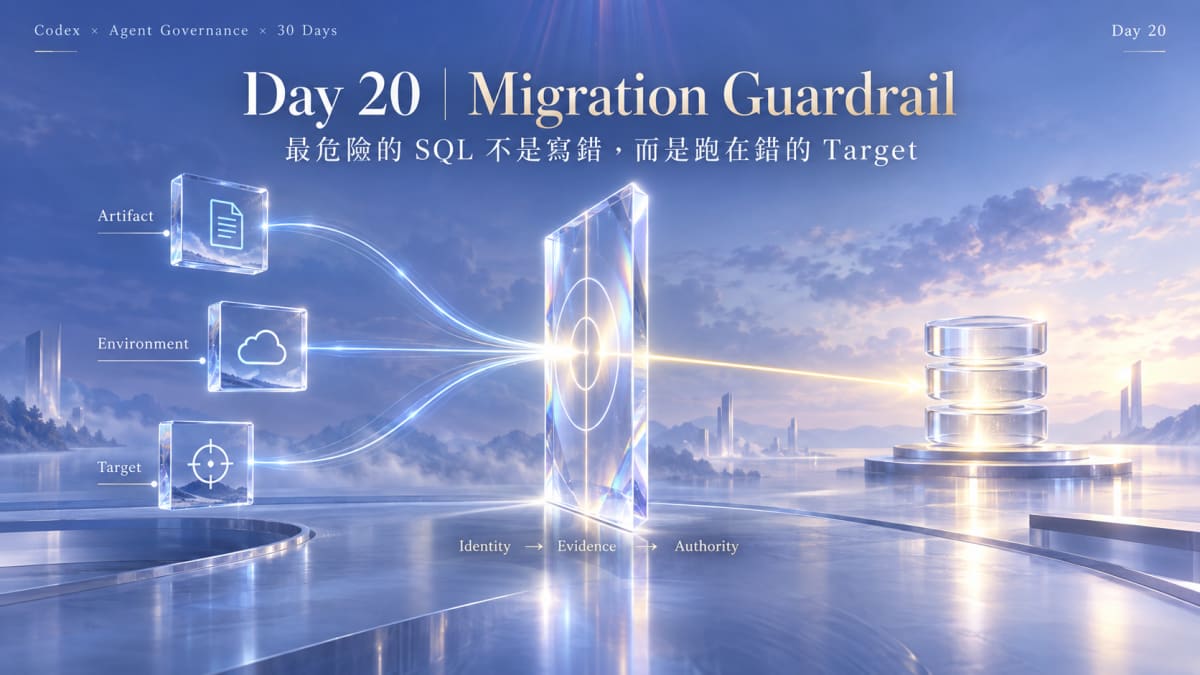
在這個專案裡,讓 migration 不能被當成普通 coding task 的,不是 SQL 本身有多難,而是:
SQL 可以完全正確,target 也可以完全錯。
一旦 action 從「修改 Repository」跨到「改變遠端 schema / data」,問題就不只剩下:
這份 migration 對不對?
還要先確認:
這是哪一份 Artifact?
現在在哪個 Environment?
真正要改的是哪一個 Target?
Day 19 把 Capability 與 Authority 分開;Day 20 再補上一層:
Irreversible mutation 執行前,必須先證明 Artifact、Environment、Target 三個 Identity 對得上,再談這次 action 是否取得 Authority。
在一個從 GAS / Sheets 遷移到 Cloudflare Worker + D1 的實際專案裡,早期 POC plan 有一條很直接的限制:
Do not guess database_id.
wrangler.jsonc 一開始刻意保留 placeholder:
{
  "binding": "DB",
  "database_name": "bento-poc",
  "database_id": "<SET_FROM_WRANGLER_D1_INFO>"
}
必須先透過 authenticated Wrangler 或 Dashboard 查到既有 D1 的 resource ID,才允許把 placeholder 換掉。
remote migration / deploy 前還有另一層 guard:
const database = config.d1_databases?.find(
  (binding) => binding.binding === 'DB'
);
const databaseId = database?.database_id;

if (!databaseIdPattern.test(String(databaseId || ''))) {
  console.error(
    '[worker-poc] Refusing remote write: ' +
    'wrangler.jsonc must contain a valid formal D1 database_id.'
  );
  process.exit(1);
}
remote action 因此不是直接呼叫 Wrangler,而是先經過:
require-database-id
→ wrangler d1 migrations apply ... --remote
這段程式沒有檢查 SQL syntax,也沒有判斷 schema 好不好。
它只先回答一個更基礎的問題:
你現在到底準備對哪一個 database 動手?
原本 migration safety 很容易先想到 SQL review、backup、rollback;這個實作把順序往前移了一步:
先證明 Target Identity
→ 才有資格進入 remote mutation
只要 target resolution 錯了,SQL 寫得再安全都沒有意義。
正式 backend 沒有沿用 POC schema 一路補 patch。
設計明確把兩套 migration 分開:
migrations/
→ POC reference

migrations-formal/
→ formal clean schema
formal implementation plan 也要求:
所以「跑 migration」不是完整指令。
至少還要知道:
migration family
file / version
expected schema state
是否已套用
這次允許的是 local validation,還是 remote mutation
看到 repo 裡有 SQL 檔,並不代表 Artifact Identity 已成立。
同一份 plan 把 local 與 remote command 刻意分開:
db:migrations:local
db:migrations:remote
而當時的 Global Constraints 明確寫著:
Do not execute remote D1 migrations.
Do not deploy.
後續 formal backend implementation 也維持相同邊界:
local formal migration
→ 可以驗證

remote D1 destructive reset
→ NOT AUTHORIZED / NOT RUN
這和 Day 18 的 Execution Environment Identity 不同。
Day 18 問:
Verification result 是在哪個 execution environment 產生?
Day 20 問:
這次 mutation 被允許發生在哪個 environment?
local migration PASS 能證明 schema 可在乾淨資料庫建立,但不能推導 remote D1 已取得 mutation authority。
bento-poc 這種 database name 對人很好讀,但 remote action 不能只靠名稱。
Repository 的 guard 最後檢查的是 database_id 是否存在、格式是否有效:
configuration 有明確 binding
+
binding 對應明確 database_id
+
remote action 執行前重新檢查
shell history、最近一次使用的 command、database name,甚至「剛才 local 測過」,都只能提供 context,不能取代 Target Identity。
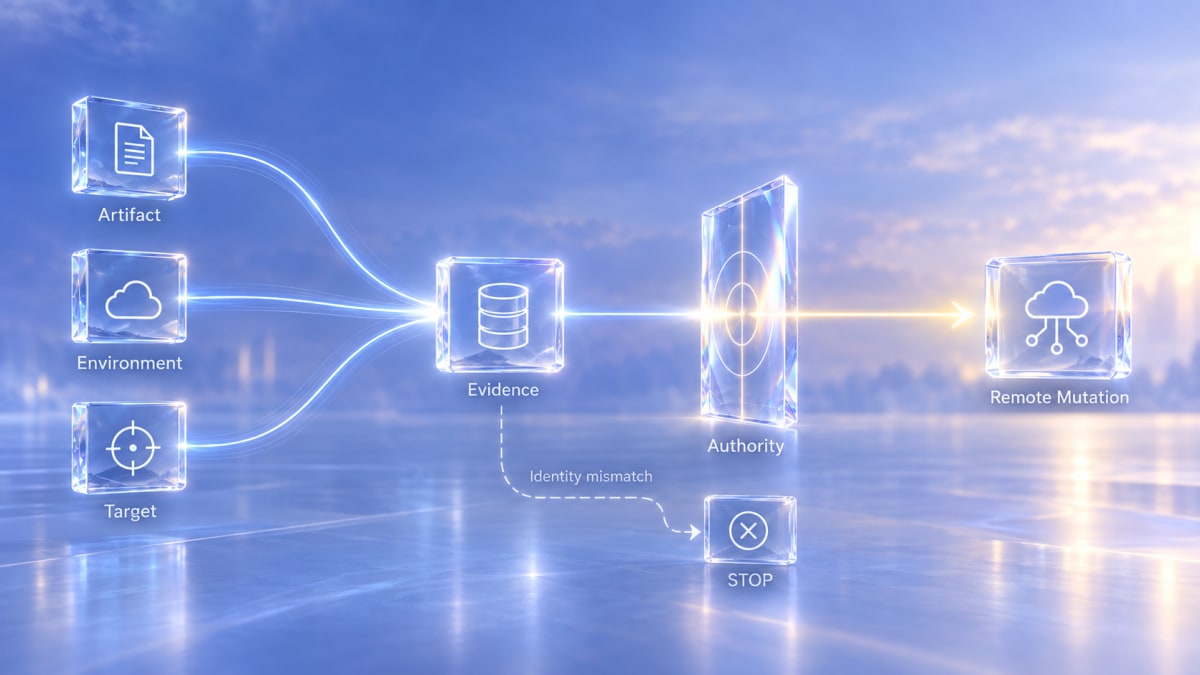
三個 Identity 也不是三份各自獨立的 checklist。只有 Artifact、Environment、Target 一起指向同一個預期的遠端變更,才形成足以進入下一步判斷的 Evidence;任一項對不上,流程就應停在 mutation 之前。
Artifact Identity ─────┐
Environment Identity ──┼→ Evidence → Authority → Remote Mutation
Target Identity ───────┘

Identity mismatch
→ STOP BEFORE MUTATION
Day 19 已建立 Capability ≠ Authority;migration 需要把 action class 再切細:
能 deploy Worker
≠
能改 remote schema

能改 remote schema
≠
能 reset remote data

能執行 migration
≠
能做 data repair
formal backend plan 因此把幾件事分開授權:
command 可能很短,但 blast radius 並不會因此變小。
如果走到 remote mutation 前,Human Gate 只收到:
可以執行 migration 嗎?
那等於把 repo、config 與 execution context 的重建成本全部丟回給人。
比較可判斷的 gate payload 應該已整理成:
Artifact
- migration family / file / version
- expected pre-state
- expected post-state

Environment
- local / staging / production
- command path
- credential / binding source

Target
- binding
- database / project identity
- immutable resource identifier

Evidence
- local validation result
- expected diff
- pending / already-applied state

Mitigation
- backup / rollback / forward-fix strategy
- known irreversible portion

Requested Authority
- exactly which remote mutation is being requested
Human Gate 的工作不該是重新調查整件事,而是判斷:
這組 Identity 與 Evidence,是否足以授權這次 irreversible action?
Dry-run 能證明 migration 在某個 target 上看起來可行,但無法替另一個 target 背書。
例如:
local clean DB
→ migration PASS

remote binding
→ 指到另一個 resource
第一段即使完全正確,也沒有證明第二段安全。
所以順序應該是:
Identity
→ Evidence
→ Authority
→ Mutation
→ Post-state Verification
正文圖裡的 Gate 就是在表達這個順序:Evidence 還沒成立時,不是「請人承擔風險」,而是根本還沒資格進到 mutation。
因此,dry-run PASS 也不能把另一個 remote target 自動視為同一件事。
require-database-id.mjs 很小,也不懂 schema 或 business rule。
它只做到:
Target Identity 明顯不成立
→ remote write 不開始
這已經比「提醒 Agent 小心確認 target」更可靠,因為可程式化的錯誤被放進 executable boundary,而不是依賴每個 session 都記得同一句提醒。
但 UUID format check 仍不能證明 target 100% 正確;它只能排除 placeholder、空值與明顯無效 identifier。
高風險的 remote migration,還可能需要額外確認:
Guardrail 的作用不是宣稱「有 guard 就安全」,而是先擋掉能 deterministic 判斷的錯誤,再把剩下的 policy decision 留給 Gate。
Migration 也讓 planning 的位置變得更清楚。
不是所有 action 都需要先停下來,等人批准一份完整 plan;實際流程更接近:
Understand
→ Act
→ Observe
→ Re-plan
→ Verify
但當流程即將跨進 irreversible mutation,前面累積的 Identity、Evidence 與 Authority context 必須能被壓縮成一個可判斷的 checkpoint。
Planning 沒有消失;它從一次性的前置文件,變成持續更新、在高影響 boundary 收斂的治理循環。
Day 20 先把這個 boundary 釘在 migration 上。
下一篇再處理更大的問題:當 Agent 的執行速度持續提高,人類注意力應該被放在哪些 Production decision 上。


 iThome鐵人賽
 看影片追技術