

一個實際內部系統的身份綁定實作計畫,留下兩條看似矛盾的要求:本機驗證通過後,先取得使用者在該部署時點的明確批准,才部署限定的正式 Worker,再以遠端流程檢查核心行為;但不能部署前端,也不能為了讓驗證成功而手動清理遠端資料。
它們限制的是不同動作。讀到「可以做遠端驗證」,Agent 仍不能把它延伸成「可以修任何遠端狀態」。
這也暴露了只用「要不要部署」當確認問題的不足。同一個任務裡,讀取狀態、執行已授權的步驟、擴大資料修改,可能需要三種不同處理。
部署關卡(Deploy Gate)應把人的注意力放在需要決策的邊界;已授權的步驟可以繼續,資訊不足的動作先停止。
Day 19 已區分能力與授權,Day 20 補上遠端變更的目標識別。這一篇接著問:有哪些事值得打斷人,哪些事應先由 Agent 查清楚?
2026-09-12 的身份綁定計畫,把遠端檢查放在本機驗證之後;Task 7 又明定,部署當下必須取得使用者明確授權。通過本機測試只代表可以走到這個批准點,不能自行部署。遠端檢查若失敗就停,也不能用一次性的遠端刪除取代正式流程。
2026-10-03 回查 Repository 的現行工作契約,commit、push、deploy 仍要求當次使用者明確提出。因此,歷史計畫只能證明當時如何切分工作,不能替今天的任務授權。
兩份文件一起讀,才看得出關卡應檢查的內容:
反覆詢問已批准的同一步驟,可能增加確認負擔;省略新的授權邊界,則會把人的決策權交給 Agent。這裡尚未量測確認次數或節省時間,不能據此宣稱減少關卡已提高效率。
| 維度 | 在這個案例要問什麼 |
|---|---|
| 影響範圍(Blast Radius) | 只更新 Worker,還是連前端、身份規則與遠端資料一起改? |
| 可恢復性(Reversibility) | 重部署舊程式能恢復嗎?已產生的資料異動會不會留下? |
| 授權影響(Authority Impact) | 這次是否改變誰能操作、操作哪個對象,或擴張原本批准的範圍? |
| 證據充分性(Evidence Sufficiency) | 本機結果、遠端目標、預期狀態與失敗處理是否已知? |
「只碰後端」回答不了全部問題。上述身份綁定本身涉及身份語意,即使不部署前端,也不能因此被歸為一般低風險修改;那份特定任務契約只界定可請求的範圍,部署仍須等該時點的批准。
可恢復性也要拆開看。Worker 程式可以換回舊版,不代表新版曾寫入的資料會一起還原。若沒有資料恢復方案,就不能在確認訊息裡只寫「可 rollback」。
這組分類回答的是「接下來由誰補哪個缺口」,不是測試等級,也不是 Agent 的能力排名。
| 分流 | 條件 | 下一步 |
|---|---|---|
| 自動繼續(AUTO) | 當次授權已涵蓋,範圍與副作用已知,必要證據成立 | 執行該步並留下結果;不自行增加授權 |
| 人工決策(GATE) | 事實已足以說明風險,但需要新的授權或政策取捨 | 提出具體動作、目標、影響與恢復限制 |
| 先停止(STOP) | 目標不明、證據失效、驗證失敗或範圍衝突 | 先做允許的診斷;補齊後重新分類 |
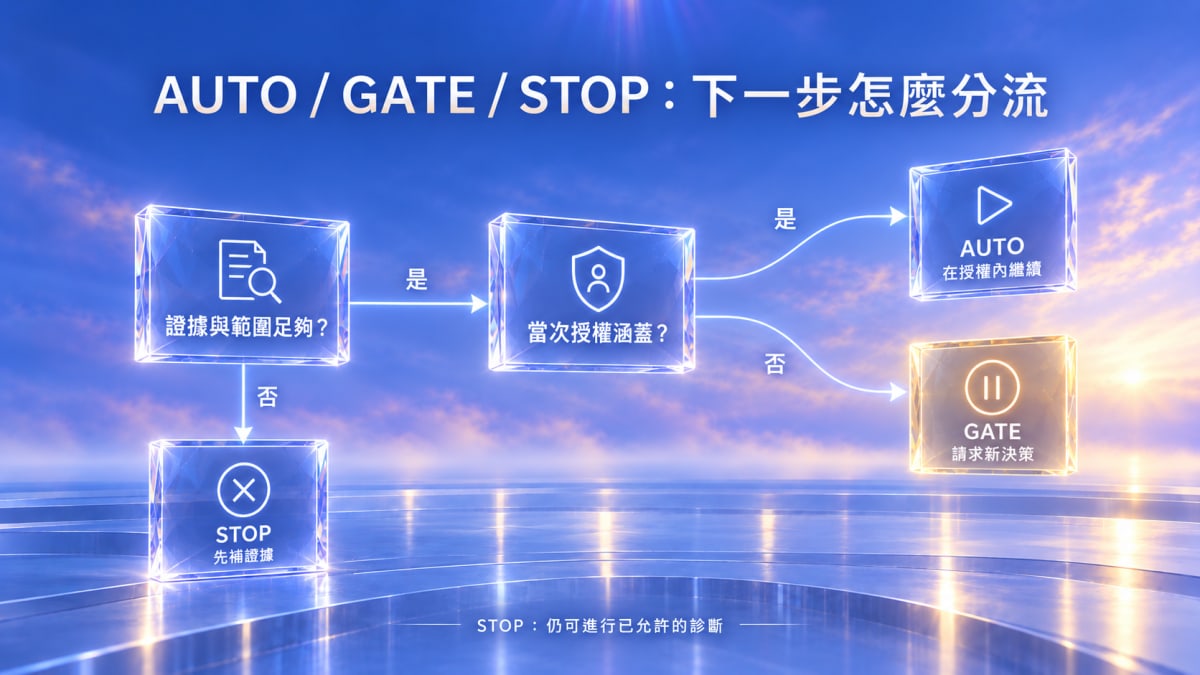
套回同一個任務,讀取本機驗證輸出可在允許範圍內繼續;要求額外部署前端要提出新的授權;遠端檢查失敗且原因未明時,應先保留失敗狀態,不能把「讓我清掉資料試試看」當作下一個例行確認。
STOP 不代表把工作放著。它限制有副作用的操作,仍可進行已允許的讀取、比較與診斷。若根本不知道會改哪些資料,先補證據比要求使用者承擔未知風險更有用。
OpenAI 2026-10-02 的 GPT‑6 系列指南把類似問題表述為 decision boundary:先說清楚哪些動作可自行執行、哪些需要核准,而不是一律先詢問。這和這裡的 AUTO / GATE / STOP 相容,但不能替本專案決定授權;官方原則只提供 supporting evidence,實際哪些部署、提交或資料修改必須逐次確認,仍由 Repository 與當次任務契約決定。本篇的 Primary Evidence 仍是前述 repo contract 與真實任務邊界。
需要新授權時,確認訊息可以沿用下面的欄位。這是請求格式,不是一次已執行的部署紀錄:
變更:這次要增加哪個動作
目標:哪個環境、服務與版本
已有證據:驗證命令、結果及適用狀態
影響:程式、資料與權限各改到哪裡
恢復:可恢復部分、不可逆部分、失敗時停在哪
請求:只批准哪個具體動作
「測試都過了,可以繼續嗎?」缺少的往往不是禮貌,而是使用者無法判斷「繼續」會碰到什麼。
這份摘要也有成本:Agent 要維護有效的目標與證據,不能把過期結果填進固定表格。變更內容、目標或授權範圍一旦改了,就要重新判斷,不能沿用上一次的批准。
如果 Agent 的產出速度開始超過人逐項理解的速度,增加更多確認視窗未必解決問題。較可行的方向,是讓執行結果能被查核,並把未授權的高影響決策收斂成少數清楚問題。本篇沒有量測 Agent throughput 與 Human comprehension throughput 的比值,這裡只把它當成設計壓力,不寫成實測結論。
不過,可靠證據只讓人更容易決定是否擴大授權,不能讓 Agent 自己把權限放大。使用者若要求每次 commit、部署或資料修改都先確認,分流仍須保留那些關卡。
同一個真實專案裡,這條任務曾刻意限制為 Worker-only 發布;這裡只借用它留下的授權邊界,說明注意力分配不能單靠「前端/後端」或「測試通過」決定。
下一篇轉向執行之後:留下哪些紀錄,才能知道 Agent 做過什麼,以及修改是否真的達到目標?
OpenAI|GPT‑6 系列模型指南(2026-10-02;decision boundary / completion boundary)
實際專案的實作計畫:Provisional Employee Claim/Merge Implementation Plan
Repository 當次授權與遠端驗證邊界:AGENTS.md、Worker README


 iThome鐵人賽
 看影片追技術