

2026-10-02 檢查一個長期 Repository 時,文章已引用正式圖片,資產清單也有對應封面;專案狀態卻仍把部分已發布文章放在草稿區間,近期規劃甚至停在更早的篇章。
只看圖片發布流程的 success,找不到這個問題。工具完成了它承諾的工作,下一輪任務依賴的進度卻沒有跟上。
Agent 可觀測性(Observability)要把執行軌跡接到可驗證的結果,才能決定下一步。
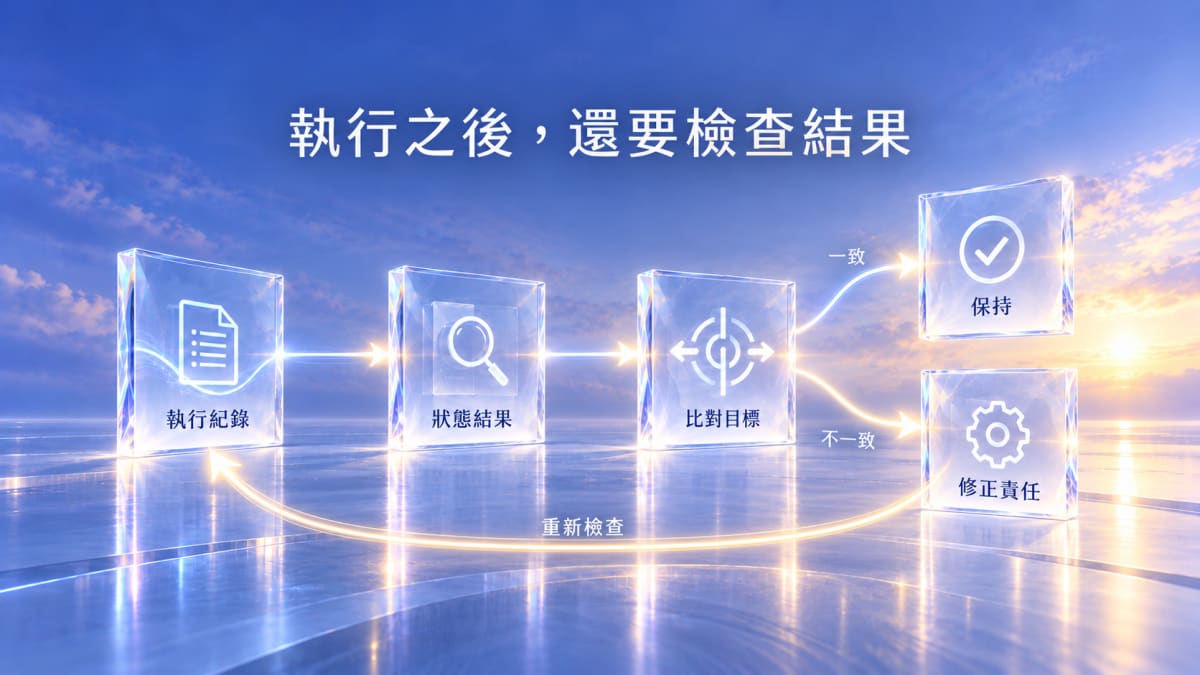
這裡有兩個問題:Agent 做過什麼,以及那些動作是否達到任務目標。前者需要可查核的執行紀錄,後者需要對結果另外檢查。
沿著實際責任往回查,固定發布工具只處理當日正文的圖片引用、封面與資產清單。這個範圍是刻意限制的;原本的發布指令只另外要求更新導覽範例,沒有把專案狀態與近期規劃列進必要收尾。
原先「圖片發布成功,下一輪就能接著做」的假設,在這裡失效。不是圖片工具少寫了某個檔案,而是整個任務沒有指派最後一段責任。
10 月 2 日的修正保留工具邊界,另外增加發布後的文件收尾:先核對文章、資產與發布提交,再同步進度、已使用的內容與下一工作篇章,最後讀回檢查。
不能因為寫了新規則,就說問題已經解決。10 月 3 日的一次後續發布,才提供了一組可重查的結果。
以 Codex Day 20 為例,Git 歷史留下兩段分開的修改:
| 可查核事件 | 直接證明什麼 | 還不能證明什麼 |
|---|---|---|
圖片發布提交 f4d9692 |
正文引用、封面與資產清單已更新 | 專案進度或平台刊登已完成 |
文件收尾 f9a0f81 起的後續提交 |
狀態、內容邊界、素材使用、近期窗口與呼叫範例陸續對齊 | 未來每次都不會遺漏 |
| 10 月 3 日讀回當時主分支 | 該篇不再被列為草稿,下一工作篇章一致指向 D21 | 已節省多少時間或重試 |
這一輪不只留下「執行成功」,也能比對任務需要的後置條件:發布的目標篇章與後續進度必須一致。若只修狀態表,近期窗口仍指向舊篇章,收尾仍未完成。
這組結果支持「修正後至少有一次文件狀態對齊」;沒有支持效率提升,也沒有證明 iThome 平台已刊登。Repo 圖片、文件進度、外部平台,各有自己的證據。
重建這次問題,不需要保存模型的內部思考。需要的是外部可觀察的事實:
這些事件串成稽核軌跡(Audit Trail)。D16 已處理單份驗證的來源脈絡;這裡新增的是跨步驟關聯:同一個 target 的工具結果,是否真的被下一個階段接住。
紀錄不必收集所有讀檔或聊天。像這次案例,工具作用範圍、目標篇章、提交與讀回差異,比完整 stdout 更能定位責任缺口。
Anthropic 在〈How we made claude.ai 3x faster in two weeks〉描述的回饋,進一步連到使用者感受到的結果:先用 benchmark 找到可改善的路徑,再核對上線後的資料。與實際延遲無關或不穩定的指標會被淘汰;改善成立才收緊回歸限制,否則關閉功能開關再試。
這個外部案例補上一個判斷:留下更多紀錄,不等於量到正確結果。若目標是降低使用者等待,工具跑得順、提交變多,都不能替延遲量測作證。
它也不能替取消審查背書。原文保留每個合併請求(Pull Request,PR)至少一位人工批准,以及人對使用者影響和取捨的決策。那些效能成果屬於 Anthropic,並非本專案的測量結果。
OpenAI 的 GPT‑6 系列指南把部署前量測再補了一層:不只看「有沒有完成」,還應量代表性任務的成功率、延遲與每個成功任務的成本,並規劃監控與資料控管。這裡只把它當成 production observability 的外部基準;本篇沒有這三項本地量測,因此不能從一次文件狀態閉環推算長期可靠度或成本。
這次的回饋很具體:圖片工具照原本範圍完成工作,因此修正落在文件收尾責任,沒有擴張工具的可寫範圍。若把所有失敗都歸成「工具不夠完整」,反而會把一個有界工具改成什麼都做的發布器。
往後可以保留一份短紀錄:
目標:下一輪從正確篇章開始
執行:圖片發布 + 獨立文件收尾
觀察:target 狀態、近期窗口、呼叫範例是否一致
不一致時:補正缺漏文件,重新讀回
仍未知:效率收益、長期遺漏率、平台刊登
當結果不符預期,紀錄應指出差在哪個責任交界,而不只是再多附一份 log。這也讓治理規則本身可以接受檢查:它保護了什麼,哪些地方仍然沒有證據。
下一篇會把視角從同一個任務的執行鏈,移到多個 Repository:哪些反覆出現的責任,值得抽成共用能力?
OpenAI|GPT‑6 系列模型指南(2026-10-02;production metrics)
Anthropic/claude.dev|How we made claude.ai 3x faster in two weeks


 iThome鐵人賽
 看影片追技術