

Day 10 時,便當系統已經從一張訂餐表單,長出 Identity、Ledger、Menu History、Calendar 這些會彼此牽動的 Domain。
Day 11~19 又發生另一種變化。
不是功能突然變少,也不是我不再讓 AI 寫 Code。
每次真的要動手之前,問題開始變成:
症狀從哪一層開始出錯?
這次什麼叫做做對?
資料跨層時,哪些語意不能走丟?
哪些舊規則必須被重新驗證?
這份 Evidence 能證明到哪裡?
這次 change 有沒有資格進 Production?
進去之後,它未來還能改什麼?
Day 11~19 最大的變化,不是多了一套流程,而是「修改」本身開始需要被證明是安全的。
這篇不再新增 framework,而是回頭看幾個真的改變後續工程決策的事件:它們怎麼一步一步,把「AI 很快就能改」推成「先確認這次應該怎麼改、能改到哪裡,又能證明到哪裡」。
Day 11 的 fresh 員編登入,是這一段最早的轉折。
使用者已經登入成功,畫面卻又被帶到 LINE 綁定流程。
只看症狀,很容易把任務描述成:
Auth 有問題,幫我修。
對 AI 來說,這句話幾乎等於把整條路都打開:
Frontend
→ Session
→ Worker
→ canonical user
→ D1
→ LINE binding
trace 之後,異常落在 Frontend 對 identity state 的 mapping;Backend 並沒有先被證明錯。
這件事直接改變修改順序:
先找 first wrong layer
→ 再定 scope
→ 其他看起來相關的地方先列成 non-goal
AI 能搜尋整個 repo、一次改很多檔案,本來是優勢。但在真實系統裡,能碰到的範圍大於這次應該碰的範圍,反而成了第一個風險。
Day 11 留下來的習慣很簡單:
沒有 Evidence 指向某一層,就不要因為它看起來相關而順手一起改。
delegated ordering 把問題再往前推了一步。
一句「讓 ProxyAdmin 可以幫別人點餐」,表面上像是多一個 target;放進真實系統後,卻同時牽動角色、日期、截止時間、訂單歸屬、餘額與 View As 邊界。
這時只找到「要改哪裡」還不夠,還要先回答:
什麼叫做做對?
Day 12 把需求寫成可判定的驗收條件(Acceptance Criteria,AC),Day 13 再把 actor、View As subject、mutation target 沿著 Frontend → API → Auth → Domain → Persistence → Response 拆開。
其中一條語意必須一路保持不變:
actor 可以替別人操作
≠
actor 取得 target 的 ownership
而 Day 14 的 regression 又補上下一個問題:
今天人工確認過的規則,下次 AI 再動到相關路徑時,誰還記得?
於是 AC、跨層 contract、regression 串成同一件事:先定義正確行為,再讓它能被反覆驗證。
這裡先停在「安全變更流程怎麼長出來」。Day 21 會再回到 delegated ordering 本身,看一個完整功能切片如何把那些 Domain Rule 組成真的使用流程。
9/21 的 ordering 409 讓 Debug 方法也變了。
使用者最後看到的是 MUTATION_CONFLICT。
如果順著錯誤名稱查,很自然會先看 concurrency、mutation guard 或 conflict handling;但資料一路攤開後,第一個分岔其實發生在更前面:
persisted menu_item_id
→ normalized menu overlay
→ menu identity 遺失
→ synthetic ID
→ order_items 寫入
→ foreign-key failure
→ MUTATION_CONFLICT
錯誤訊息只是最後被看見的症狀。
這次之後,Debug 更重要的問題變成:
預期資料和實際資料第一次開始不一樣的位置在哪裡?
也就是 first diverging point。
Evidence 的價值,不是蒐集得越多越好,而是能不能把仍可能出錯的範圍縮小。
Day 16 又讓「驗證成功」這句話變得沒那麼簡單。
local tests、regression、lint、build 都 PASS,仍然不能直接推出:
Production runtime VERIFIED
便當系統因此只替 bounded Worker-only change 留一條較快的部署路徑:不碰 schema / migration、不做 remote D1 mutation、不部署 frontend、不改重大 auth/security semantics,而且部署後仍要用 remote smoke 補 runtime evidence。
這不是把所有 Production change 都加上人工 Gate。
反而是先把不同風險分開:
低 blast radius、可逆、Evidence 足夠
→ 可以快

資料語意、外部寫入、Environment 或 Authority 不明
→ 不能沿用同一條快車道
當 Evidence 的邊界越清楚,自動化反而越容易放在正確的位置。
Day 17~19 把 Change Safety 再往外拉。
Day 17 的 Production ledger 稽核裡,當下的 latest sequenced balance 和 users.balance 可以一致,歷史鏈卻仍存在錯誤起點與向後傳播的偏差。
這代表 migration / correction 不能只問「哪個值要 UPDATE」,還要問:
哪份資料有資格描述過去?
Schema 可以 rollback,不代表被改寫的歷史語意也能 rollback。
Day 18 換成另一個方向:Code 不變,結果仍可能改變。localhost、正式 frontend、temporary tunnel 的 Origin 不同,CORS runtime boundary 也不同。
same code
≠
same execution environment
到了 Day 19,時間也成為 authority 的一部分。
Cloudflare Cron 今天被部署,明天仍會自己醒來,而且可能自己寫 D1。自動開團最後必須限制未來每一次 invocation 能不能寫、能碰哪些資料、什麼情況應收斂成 no-op,以及事後能留下什麼 execution evidence。
走到這裡,Change Safety 已經不只是檢查這次 patch。
它還包含:
把這幾次事件放在一起後,最容易誤會的是:好像最後長出了一套固定流程。
其實它們回答的是不同問題。
登入 bug 逼我先縮小 Scope;409 讓 Debug 改成找 first diverging point;remote test 提醒 Evidence 不能跨 Environment 外推;ledger 與 scheduled write 則把風險拉到歷史資料與未來 Authority。
它們不是五個必經 Gate,也沒有固定先後順序。比較像是:遇到哪一類 failure,就補上那一類原本缺少的安全邊界。
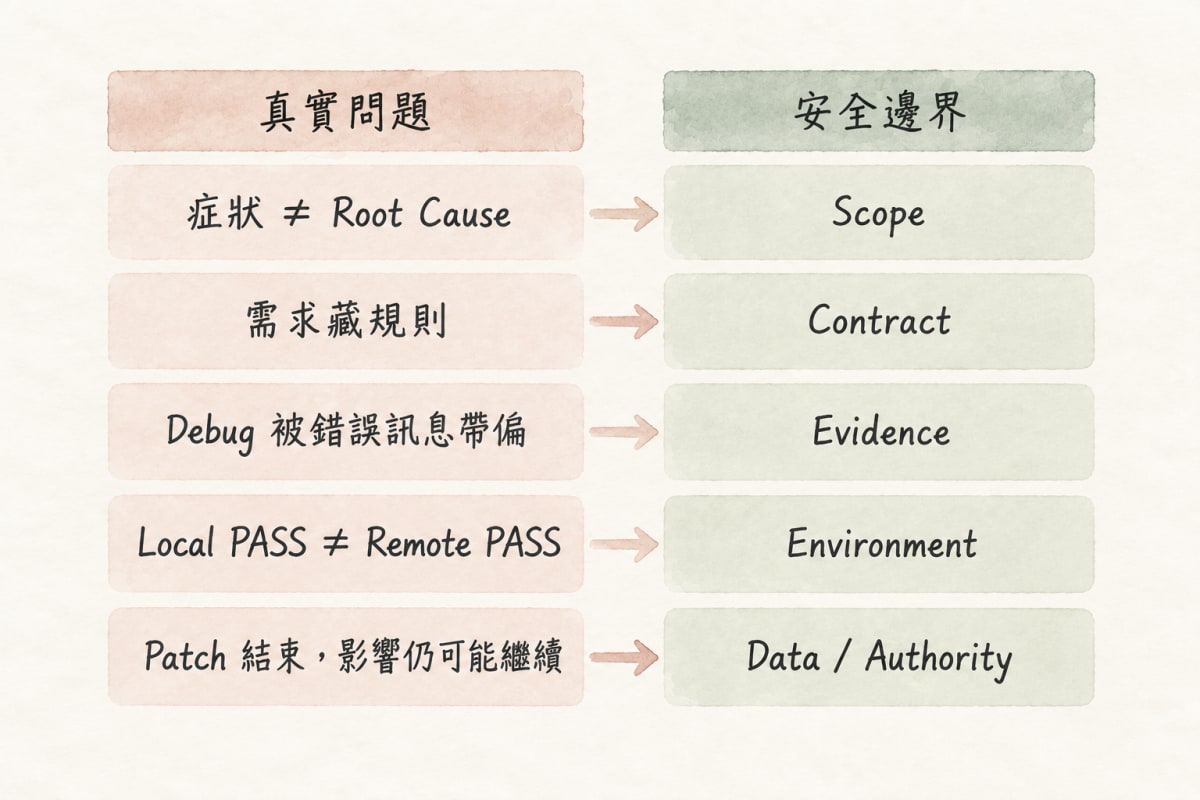
這樣回頭看,Day 11~19 留下的不是 SOP,而是幾個判斷習慣:
AI 已經把搜尋、實作、補測試與跨檔修改拉得很快。這時更值得設計的,是哪裡可以放心讓它快,哪裡必須停下來補 Evidence 或縮小 Authority。
Day 16 的 Worker-only fast path 已經說明:scope、verification、environment 與 rollback boundary 都夠清楚時,有些 change 可以直接前進。
需要停的,是 Evidence 或 authority 不足的地方,例如 schema / migration、remote data mutation、重大 auth/security semantic change、historical rewrite,或無法確認 target / environment 的外部寫入。
成熟不是把所有事情都塞進 approval。
比較接近:
把 Gate 放在會改變 blast radius、資料語意或 authority 的地方,其餘工作才有機會自動化。
早期更在意 AI 能不能多做一點。
走到 Day 20,問題變成:
能不能把邊界定義清楚,讓 AI 在不需要人一直盯著的地方安全地多做一點?
Day 11~20 花了不少篇幅處理 scope、AC、contract、regression、debug、deploy、data、environment 與 scheduled write。
如果後面繼續只談方法,Bento 系列會失去主角:這是一套真的有人使用、還在持續長大的便當系統。
Day 21 開始,視角會回到產品本身。
代點餐會再出現,但不再重講 actor / target contract;要看的是完整功能切片如何讓角色、日期、deadline、balance 與實際操作一起成立。
後面還有 Vendor Hub、營運 projection、歷史資料與 release timeline。
前十天長出 Domain,這十天長出 Change Safety。接下來要看的,是兩層能力疊在一起後,產品怎麼繼續演進。
這不是純概念示範,而是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app


 iThome鐵人賽
 看影片追技術