

Day 10 已經處理過自動開團的 Domain Rule:工作日、Timezone、Mode、deadline 與 idempotency。
這一篇不重講那些規則。
這次回頭看自動開團,差別不在 Cron 語法,而在一次部署會延伸成之後每天都可能發生的 Production mutation。
Scheduled write 的風險,不只在「會不會準時跑」,而在今天部署的程式,明天仍保有 Production 寫入權限(deferred authority)。
便當系統的正式 Worker 真的有這條路徑:
Cloudflare Cron
→ Worker scheduled handler
→ Taipei business date
→ second following business day
→ automatic opening domain rule
→ calendar setting persistence
→ D1 write
這不是假設中的背景工作,而是一條會自己醒來、自己判斷、自己決定是否寫入的正式 Production path。
手動操作比較像:
人看到當下狀態
→ 決定這次要不要做
→ 執行一次 mutation
排程則是:
今天部署
→ 明天 trigger
→ 自己判斷
→ 可能寫入

後天 trigger
→ 再判斷
→ 可能再寫入
一次 deploy 並不是只授權「現在執行一次」。
它實際上把一段判斷邏輯留在 Production,之後只要 trigger 到了,就會再次取得執行機會。
因此,驗證「今天手動跑一次沒問題」還不夠。
還要驗證:
未來每一次 scheduled invocation,都只能在事先限定的範圍內 mutation。
Worker 的 Wrangler 設定裡,Cron 是:
0 16 * * *
Cloudflare Cron 使用 UTC,因此 UTC 16:00 對應 Asia/Taipei 的午夜。
但 Domain Rule 不直接相信 process 的「現在時間」。
scheduled handler 收到的是 controller.scheduledTime,之後再轉成 Taipei business date。
這個差異很小,卻很重要。
測試直接卡住午夜前後兩個時間點:
2026-09-07 15:59:59.999 UTC
→ Taipei business date = 2026-09-07

2026-09-07 16:00:00.000 UTC
→ Taipei business date = 2026-09-08
也就是說,排程的時間邊界不是靠「大概在凌晨跑」維持,而是有 explicit clock input 可以被重跑、被測試。
Day 10 的 Timezone Rule 在這裡只作為底層能力;Day 19 往前多問一步:
未來的寫入權限要綁在可重現的 trigger context 上,而不是隱藏在 runtime clock 裡。
這次 repo 裡最有用的不是一個抽象 checklist,而是三種邊界真的被寫進程式與測試。
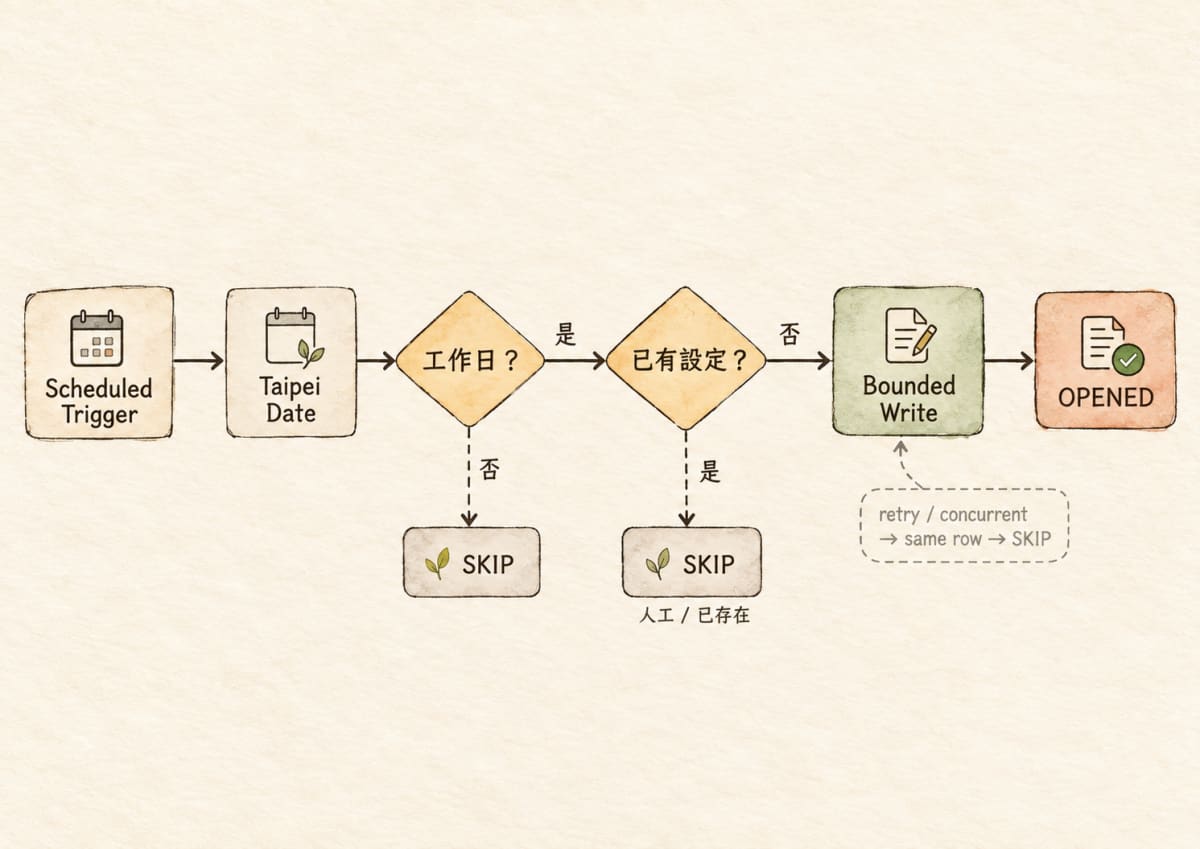
排程雖然每天觸發,但 Saturday / Sunday 會直接:
SKIP_NON_BUSINESS_DAY
而且測試會確認 calendar_settings 完全沒有新增資料。
換句話說:
trigger happened
≠ mutation must happen
Scheduler 只負責喚醒程式。
「今天是否有資格做事」仍由 Domain 判斷。
自動開團不是一支可以自由修改菜單的背景程式。
它只會計算 target date,然後走共用的 calendar persistence path,寫入:
vendor = 禾拾
mode = B
而且是 onlyIfUnassigned。
Repo 還特別有測試確認:
automatic opening
→ 不修改 menu_versions
→ 不修改 menu_items
→ 原本的 menu read 結果保持不變
這件事比「Cron 有成功跑」重要得多。
比較麻煩的情況往往不是 function 掛掉,而是 function 正常跑完,卻碰了本來不該碰的資料。
如果某一天已經有人手動指定店家,自動排程不能因為自己晚一點醒來,就把人的決定覆蓋掉。
實際測試先放入:
2026-09-16
vendor = Manual Vendor
mode = A
再執行排程。
結果是:
SKIP_ALREADY_OPEN
vendor 仍是 Manual Vendor
mode 仍是 A
這就是這條 scheduled write 最重要的 stop boundary:
Automation 可以補空白,但不能因為會自動執行,就覆寫既有決定。
Day 10 已經談過 idempotency,所以這篇不把它重新當主角。
但這次 repo 有一組很直接的 Evidence。
同一個 scheduled time 連續呼叫兩次:
第一次
→ OPENED

第二次
→ SKIP_ALREADY_OPEN
最後 calendar_settings 只有一筆。
甚至兩個 scheduled invocation 同時執行,測試預期仍然是:
一個 OPENED
一個 SKIP_ALREADY_OPEN
資料仍只有一筆
這讓 idempotency 在 Day 19 扮演的是副作用上限:
即使 trigger 重複、retry 或 concurrency 發生,這條未來寫入權限也不能因此放大成多次副作用。
如果只看 happy path,自動開團的功能很簡單:
算日期
→ 建立一筆設定
但 repo 裡較有價值的測試,反而大量在驗證「不要做什麼」:
週末不要寫
已有 vendor 不要覆蓋
重跑不要新增第二筆
concurrent run 不要多開
menu / image / version 不要被碰
這些 negative constraints 才定義了這條排程實際被允許做多少事。
也讓「stop boundary」不只是:
出錯就停止。
而是更具體:
當前置條件已經讓這次 mutation 不再必要或不再被允許,就應該收斂成 no-op。
這條 scheduled path 不會寫入需要真人 actor 的 admin audit row。
但它也不是完全沒有痕跡。
scheduled handler 會輸出 structured log,至少包含:
event
source
status
businessDate
targetDate
vendor
例如成功時會留下:
event = automatic_daily_group_opening
source = automatic_daily_cron
status = OPENED
這不是完整的 Observability 設計,也不是要在這篇展開 audit framework。
對這種延後執行的 Production write,一個很基本的要求是:
未來程式自行做過什麼,事後至少要有可辨識的 execution evidence。
否則它會變成一段「會自己改 Production,但過後很難知道它做了什麼」的黑盒。
AI 協作下,Cron handler、日期計算與 scheduled entry 很快就能產生。真正需要人補上的,是未來執行時的限制。
只看功能時,最容易檢查的是:
時間對不對?
日期有沒有算對?
有沒有重複建立?
這些都重要。
但自動開團真正進到 Production 後,問題會變成:
Trigger 到了,是否代表它有權寫?

如果可以寫,能碰哪些資料?

既有決定出現後,它會不會停?

重跑與 concurrency 會不會放大副作用?

事後能不能知道它實際做了什麼?
這些問題都不是 Cron expression 本身能回答的。它們是在定義:
這段今天部署的 Code,未來到底被授權到什麼程度。
前幾天談 Production Risk,多半在問:
這次 change 能不能安全進 Production?
Scheduled write 多了一個時間軸:
今天讓它進去之後,未來每次醒來,它還能不能安全地做同一類 mutation?
便當系統這條自動開團,最後把可寫入的範圍限縮成:
固定 scheduled entry
→ explicit Taipei date
→ business-day gate
→ bounded calendar write
→ preserve existing manual assignment
→ repeated / concurrent execution 收斂成 no-op
→ structured execution evidence
這不是讓 Cron 變得「絕對安全」,而是把一段會長期留在 Production 的背景寫入能力,縮成可以被測試、拒絕與停止的範圍。
下一篇會做 Day 11~19 的中段收束,不再新增新的 Production 機制,而是回頭看:這些真實問題怎麼一步一步把「快速改 Code」推成「先確認這次能不能安全改」。
這是一套持續開發中的便當訂購系統。文章著重「為什麼」,GitHub 保留實際程式碼、文件與演進紀錄。
GitHub:https://github.com/henryfir456/bento-order-app


 iThome鐵人賽
 看影片追技術