
前幾集我一直用 Spark UI 追著 Job、Stage、task 與 shuffle 跑。這讓我開始注意到另一種很常見、卻不一定一眼看得出的浪費:明明是同一份 DataFrame,先 count() 一次、接著再做彙總或寫檔,Spark 為什麼又從頭讀資料、又做一次 shuffle?
答案是 DataFrame 預設只是 lazy lineage,不是已經存在的中間資料。每一個 action 都可能要求 Spark 沿著同一條 lineage 再走一次。這次我想比較不使用快取、cache() 與 checkpoint() 時 Spark UI 和 Physical Plan 的差異;最後也整理日常 ETL 裡該怎麼選。
cache() 何時真的寫入快取,以及 InMemoryTableScan 代表什麼。checkpoint() 如何將長 lineage 變成新的資料起點。cache()、persist()、checkpoint() 與 localCheckpoint() 各自適合什麼問題。實驗固定使用 local[2]、關閉 AQE,避免 adaptive execution 改變觀察到的 task 數。資料從 4 個 source partitions 開始,先依 customer_id 做 repartition(6, "customer_id"),再產生後續欄位:
from pyspark.sql import DataFrame
from pyspark.sql import functions as F

C = F.col


def build_orders() -> DataFrame:
    return (
        spark.range(0, 1_200, numPartitions=4)
        .withColumn("customer_id", C("id") % 24)
        .withColumn(
            "region",
            F.when(C("id") % 3 == 0, "TW")
            .when(C("id") % 3 == 1, "JP")
            .otherwise("US"),
        )
        .withColumn("amount", C("id") * F.lit(10))
        .repartition(6, "customer_id")
        .withColumn("amount_with_fee", C("amount") * F.lit(1.05))
        .select("customer_id", "region", "amount_with_fee")
    )
接著讓同一個 DataFrame 面對兩個 action:先全域計數,再依 region 彙總。
orders = build_orders()

orders.count()

(
    orders.groupBy("region")
    .agg(F.sum("amount_with_fee").alias("total_amount"))
    .collect()
)
可以先把它想成兩張訂單:兩個 action 都向 Spark 索取 orders 的結果,但 orders 本身還只是「如何取得資料」的說明書。
來源 Range(4 partitions)
  ↓
依 customer_id shuffle(6 partitions)
  ↓
orders:仍是 lazy DataFrame
  ├─ count()
  └─ groupBy(region).agg(...).collect()
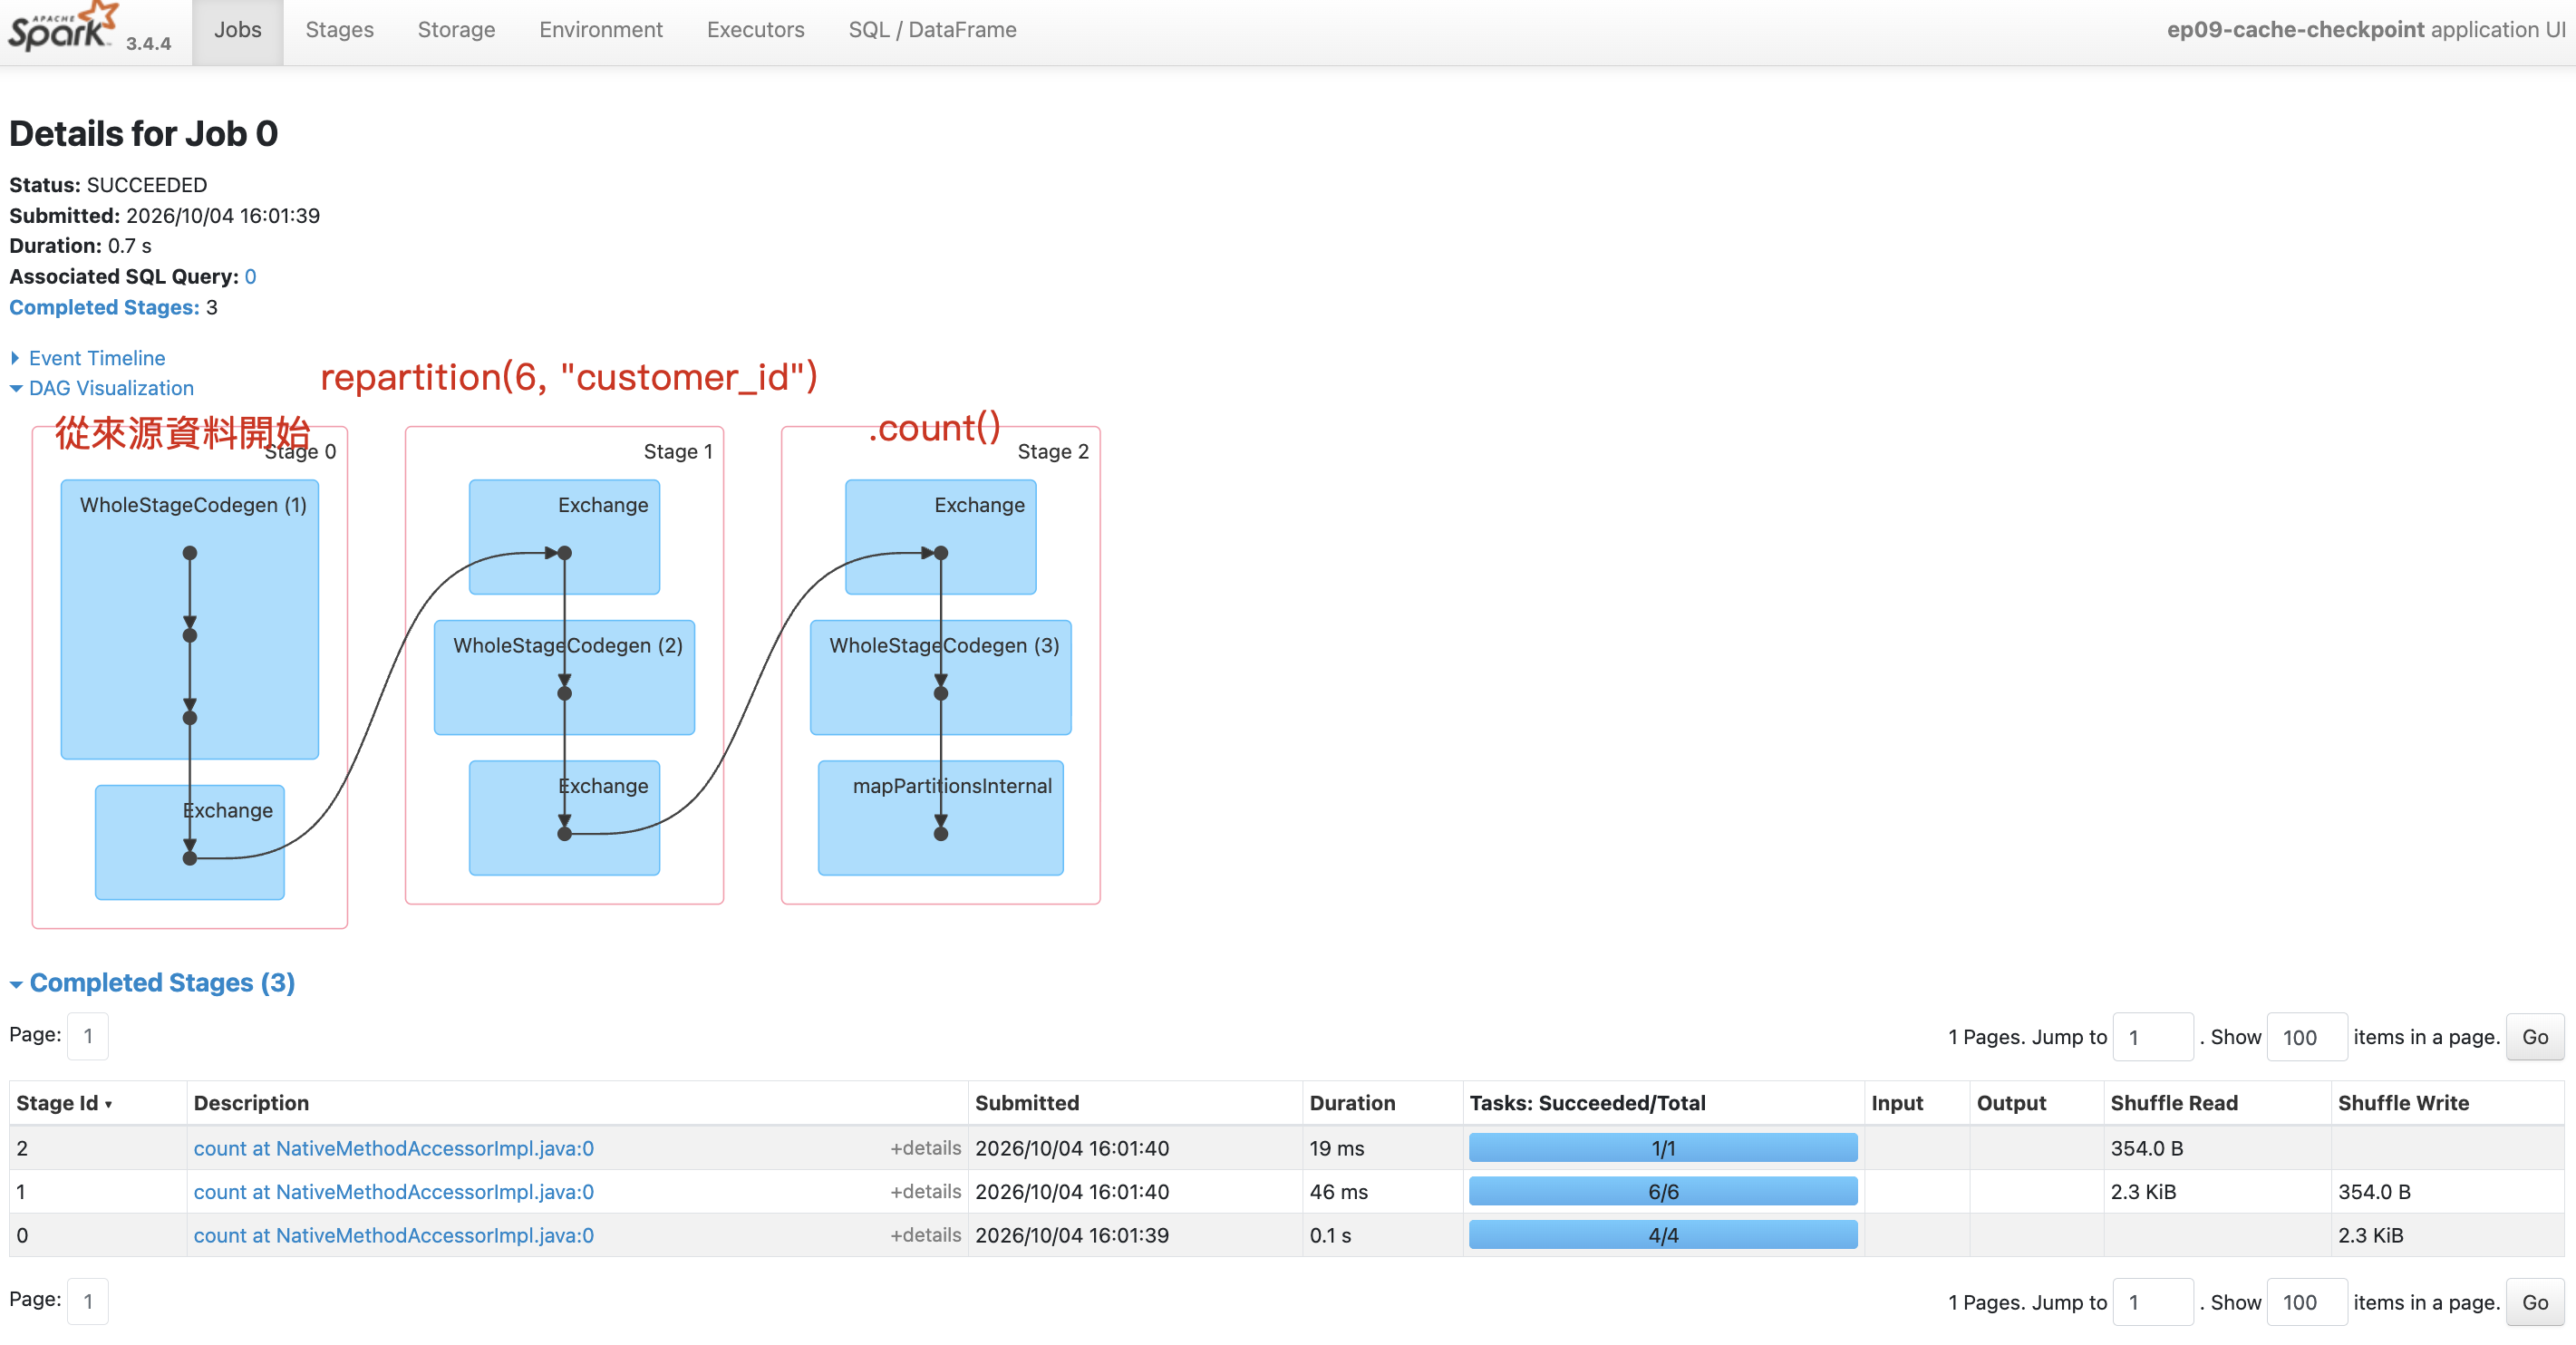
先看第一個 count()。Spark UI 依序顯示來源的 4 個 task、repartition(6, "customer_id") 後的 6 個 task,以及做全域計數的 1 個 task。
第二個 action 的 .collect() 會觸發整個 groupBy("region") 計畫。UI 再次從來源與 customer_id shuffle 開始,最後才做 region 的彙總 shuffle。
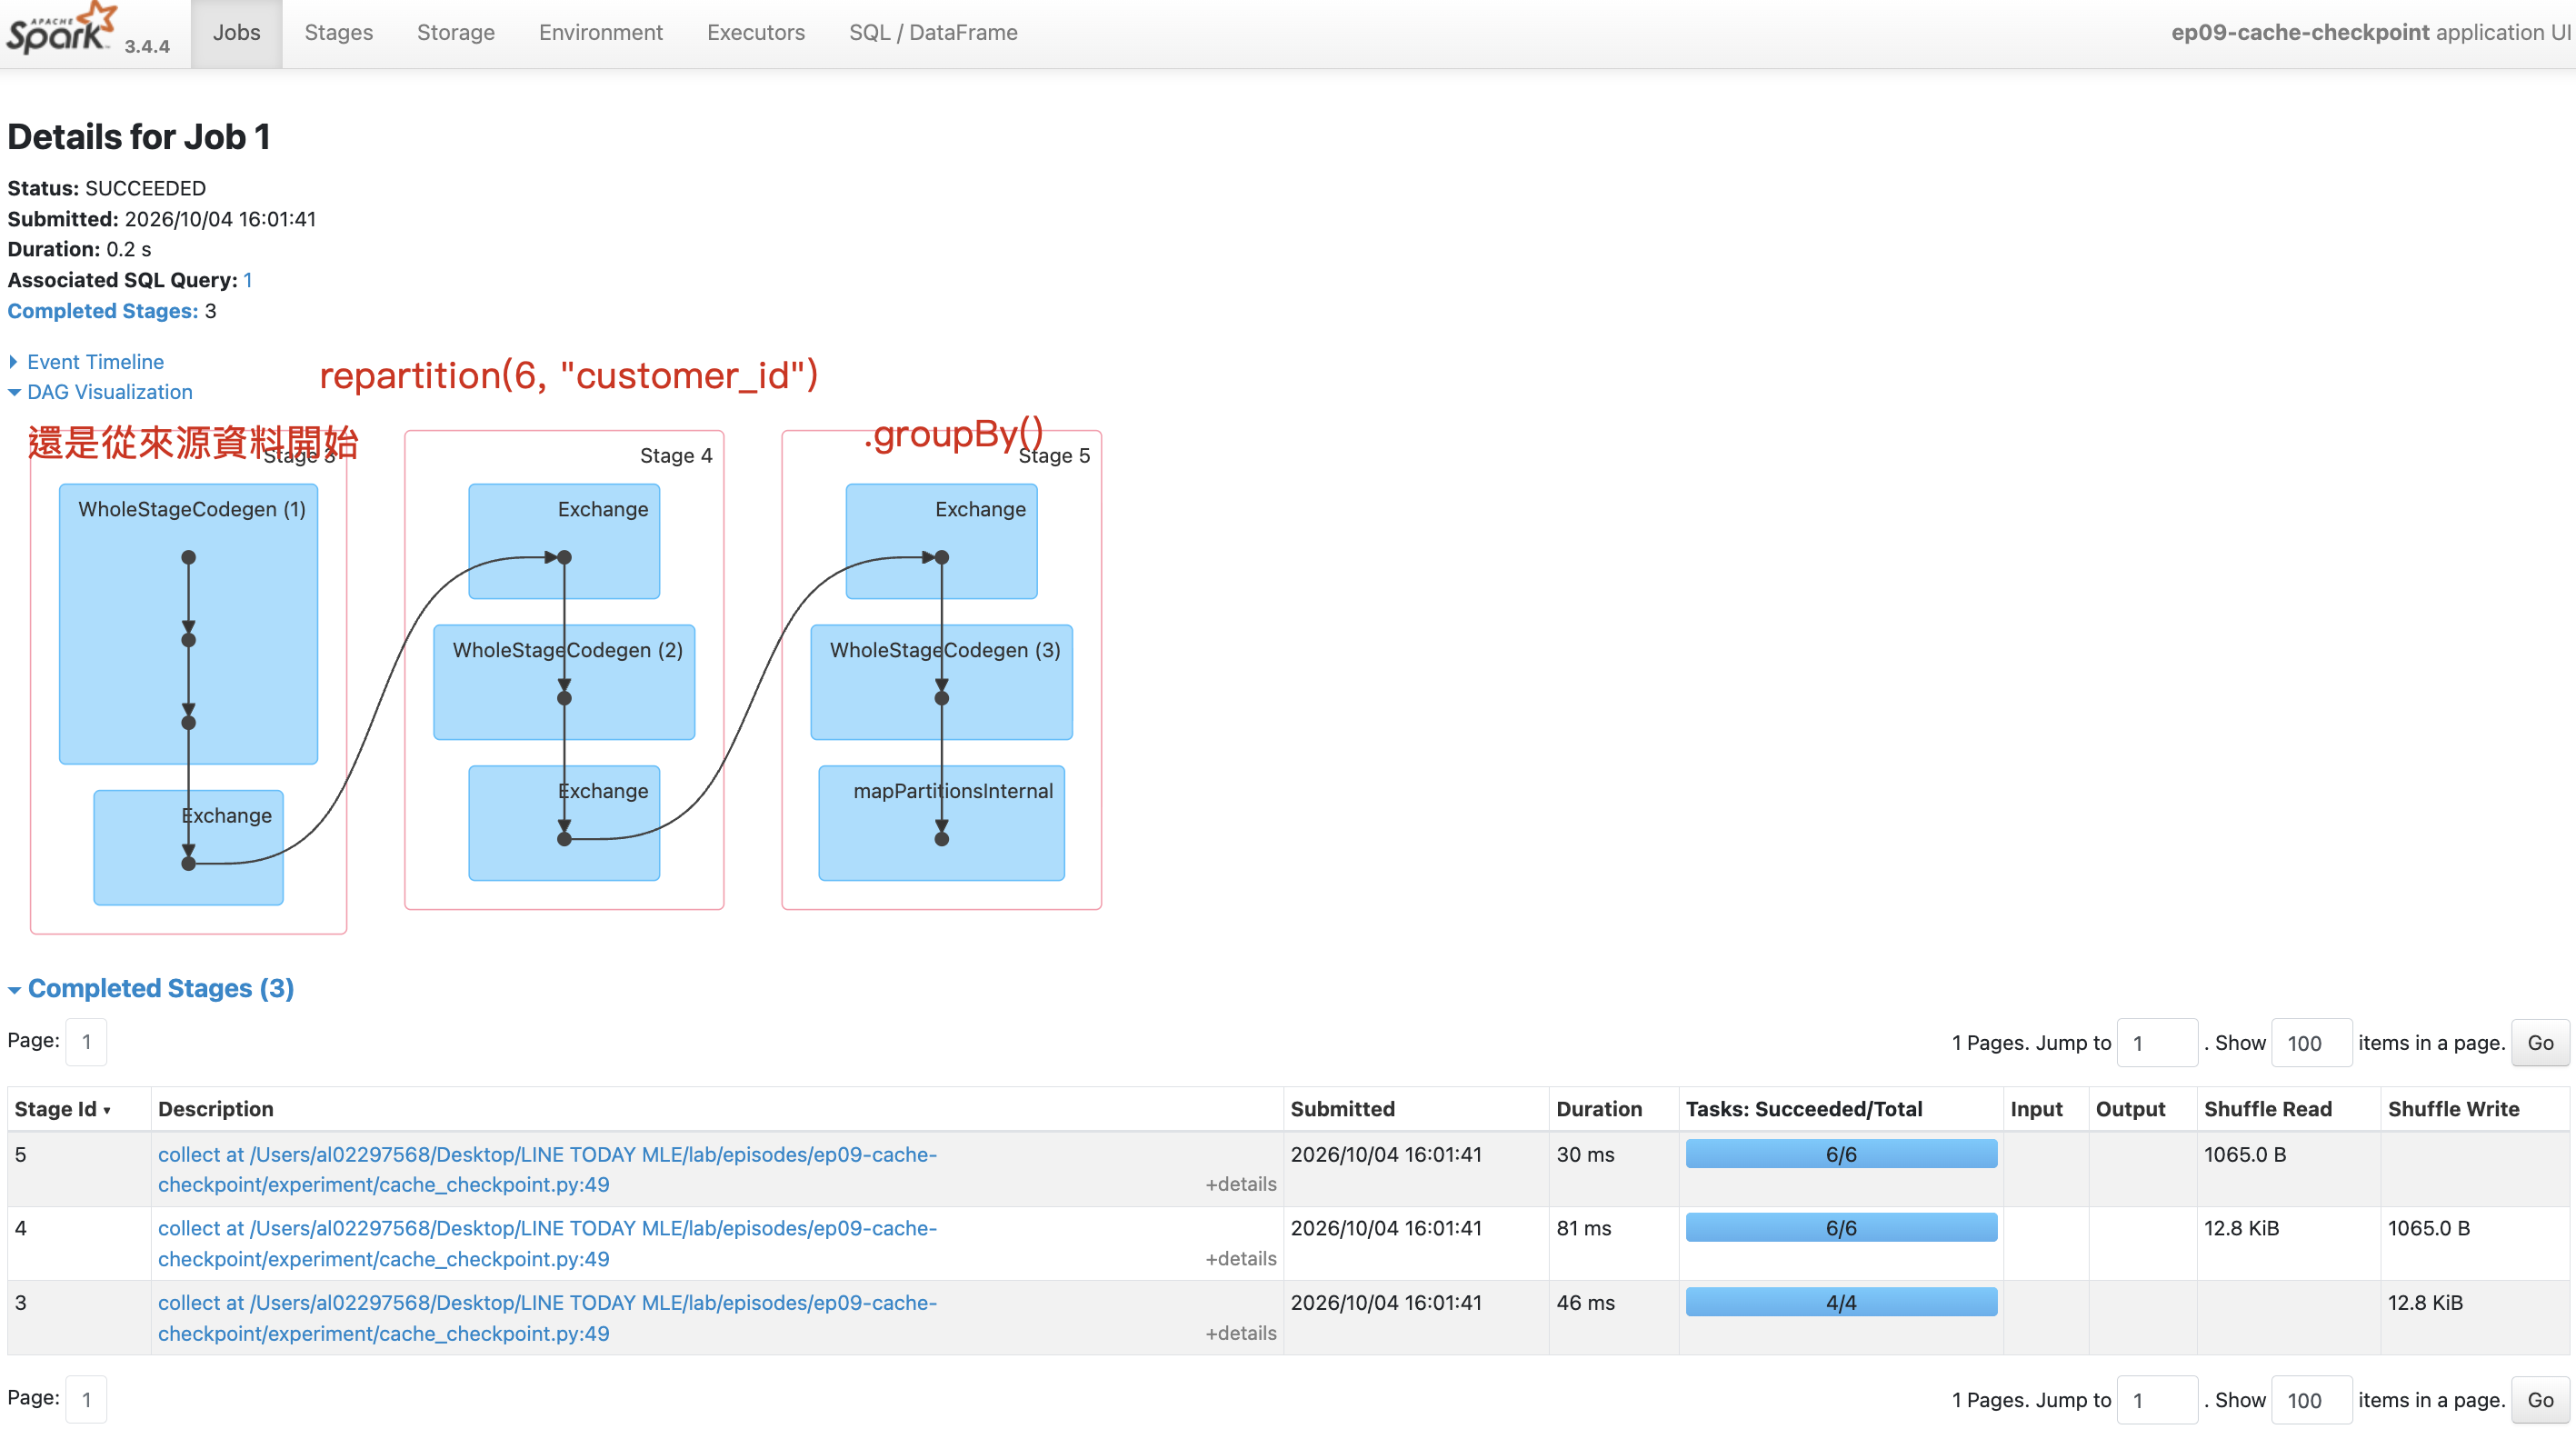
這裡有一個容易混淆的細節:不是 .collect() 本身產生第二個 shuffle,而是 groupBy("region") 需要讓相同 region 的資料集中;.collect() 只是讓這整份計畫開始執行。
DataFrame 的 transformation 不會自動留下中間結果;同一條 lazy lineage 被不同 action 使用時,就可能被各跑一次。
cache() 後,什麼時候才真的快取?我先把 cache() 接在含有 repartition 的 DataFrame 後面:
cached_orders = build_orders().cache()

cached_orders.count()
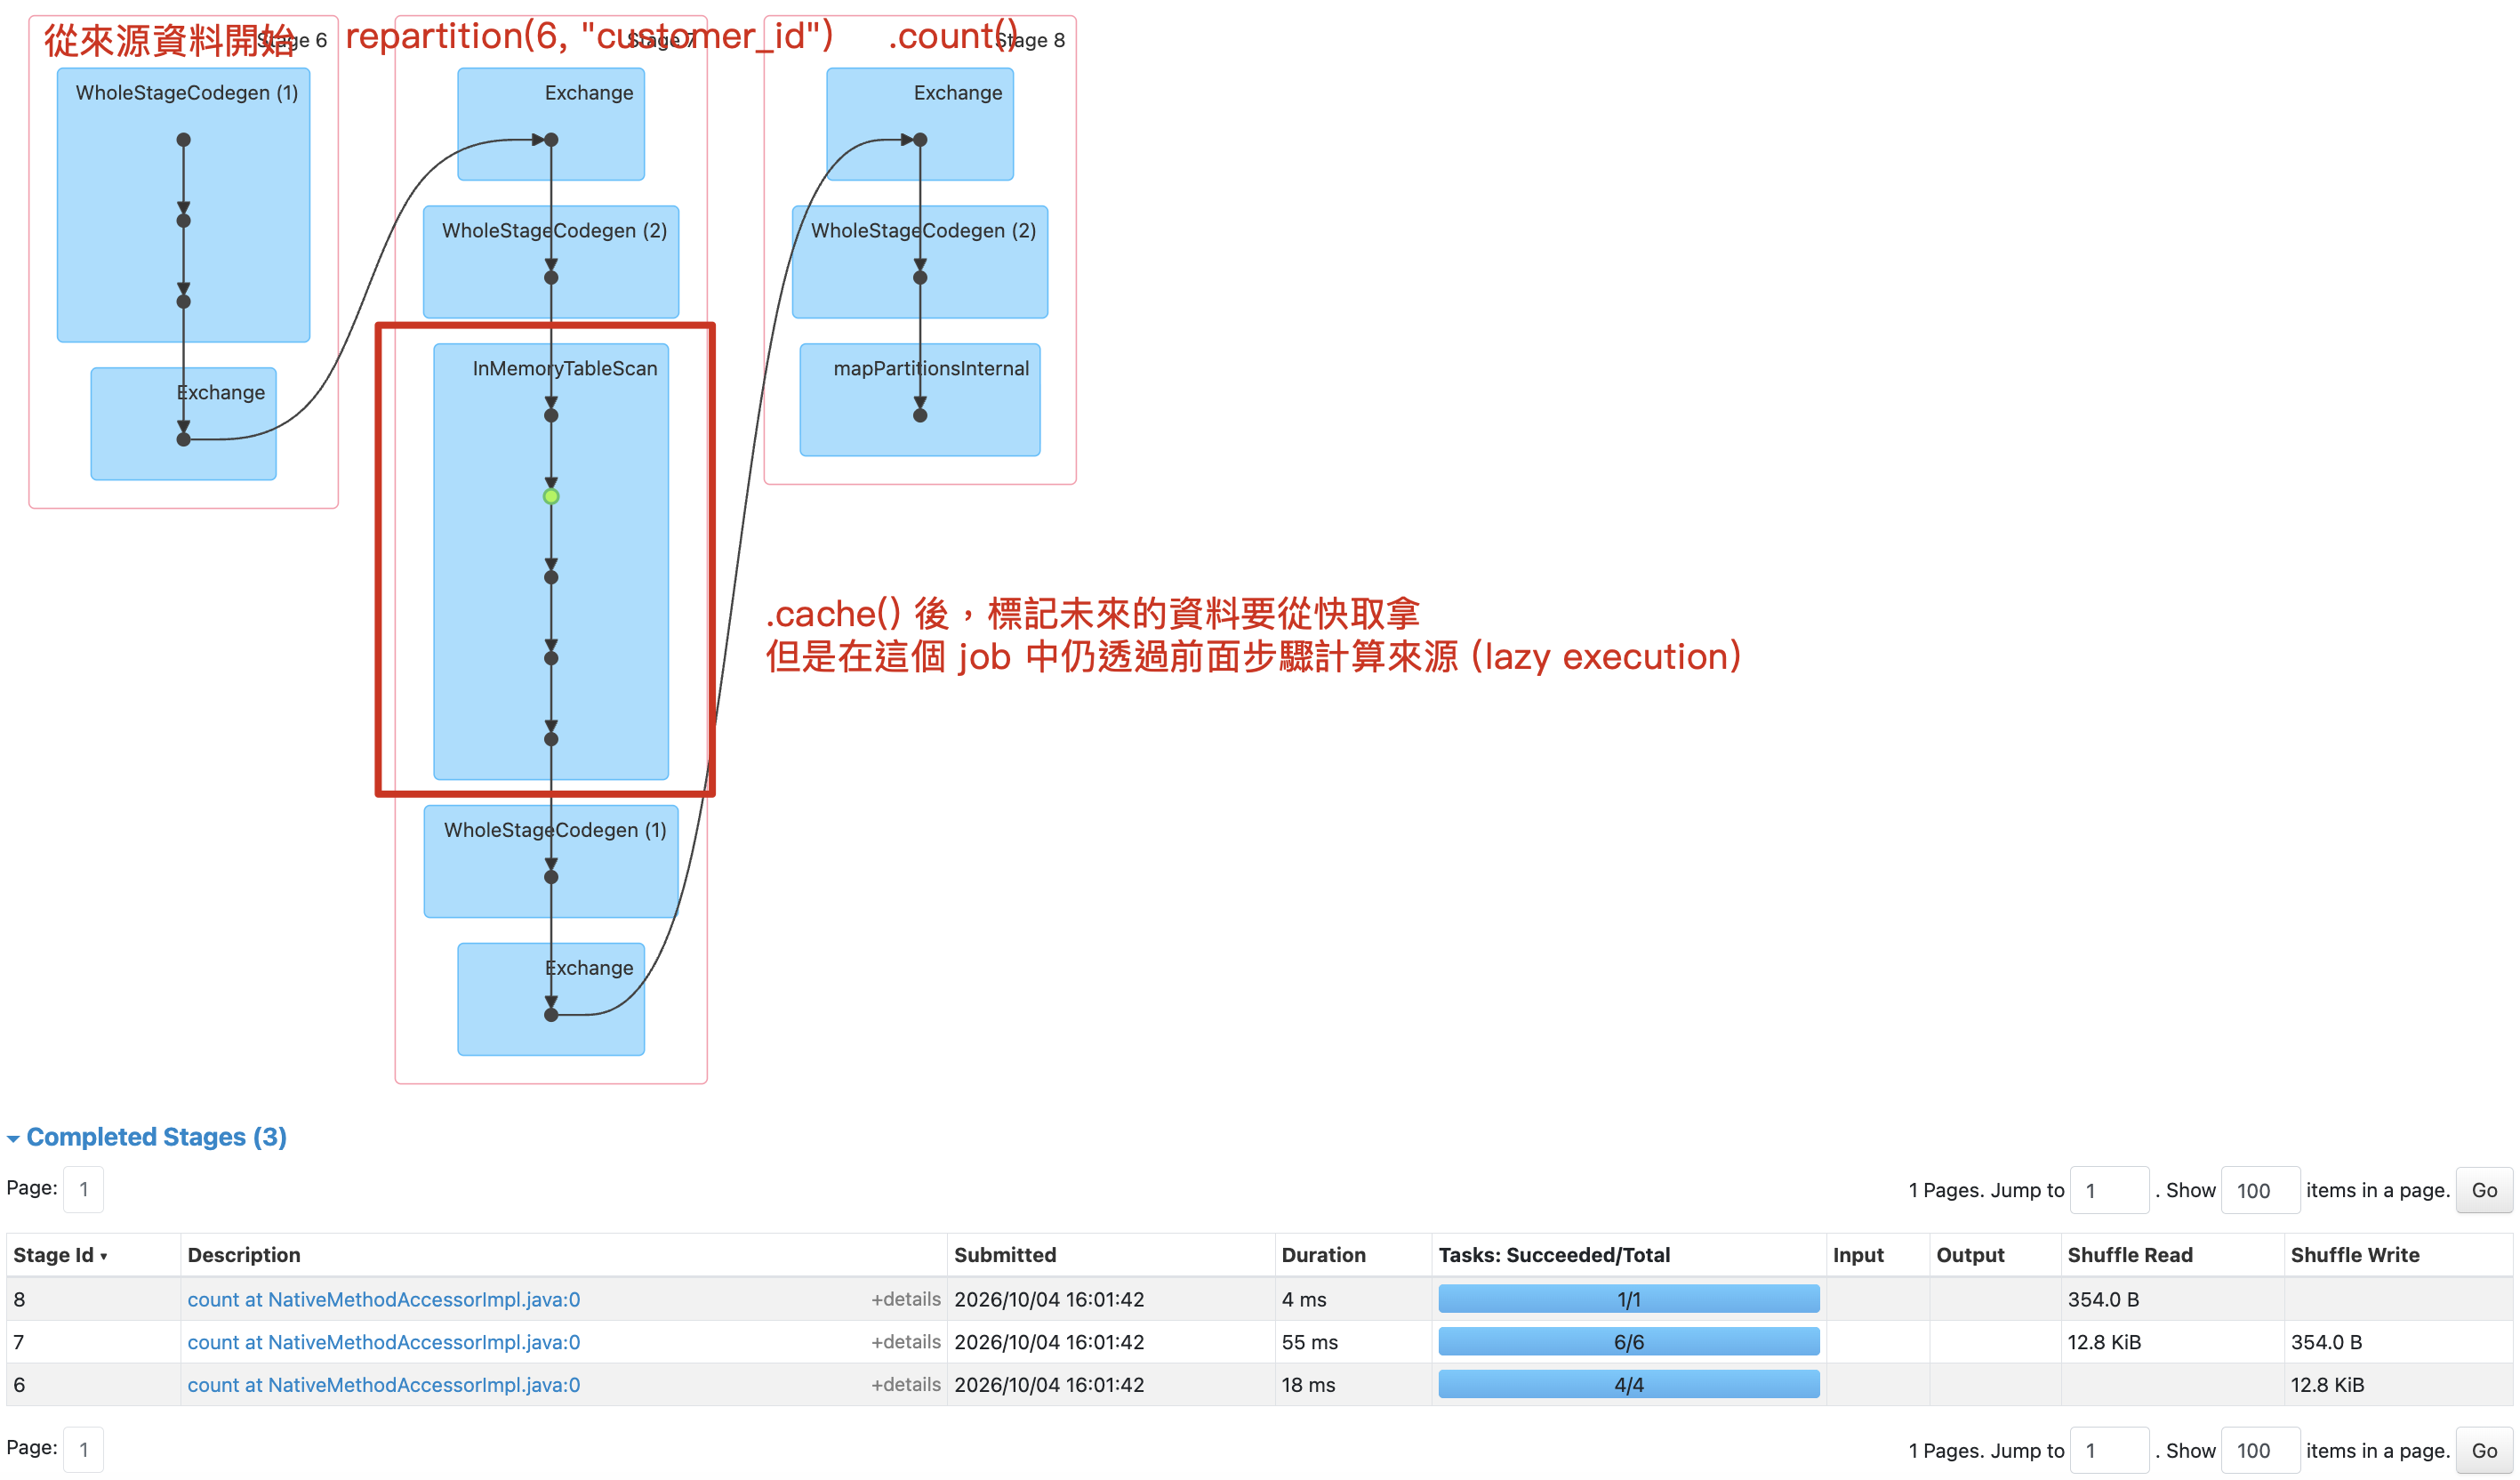
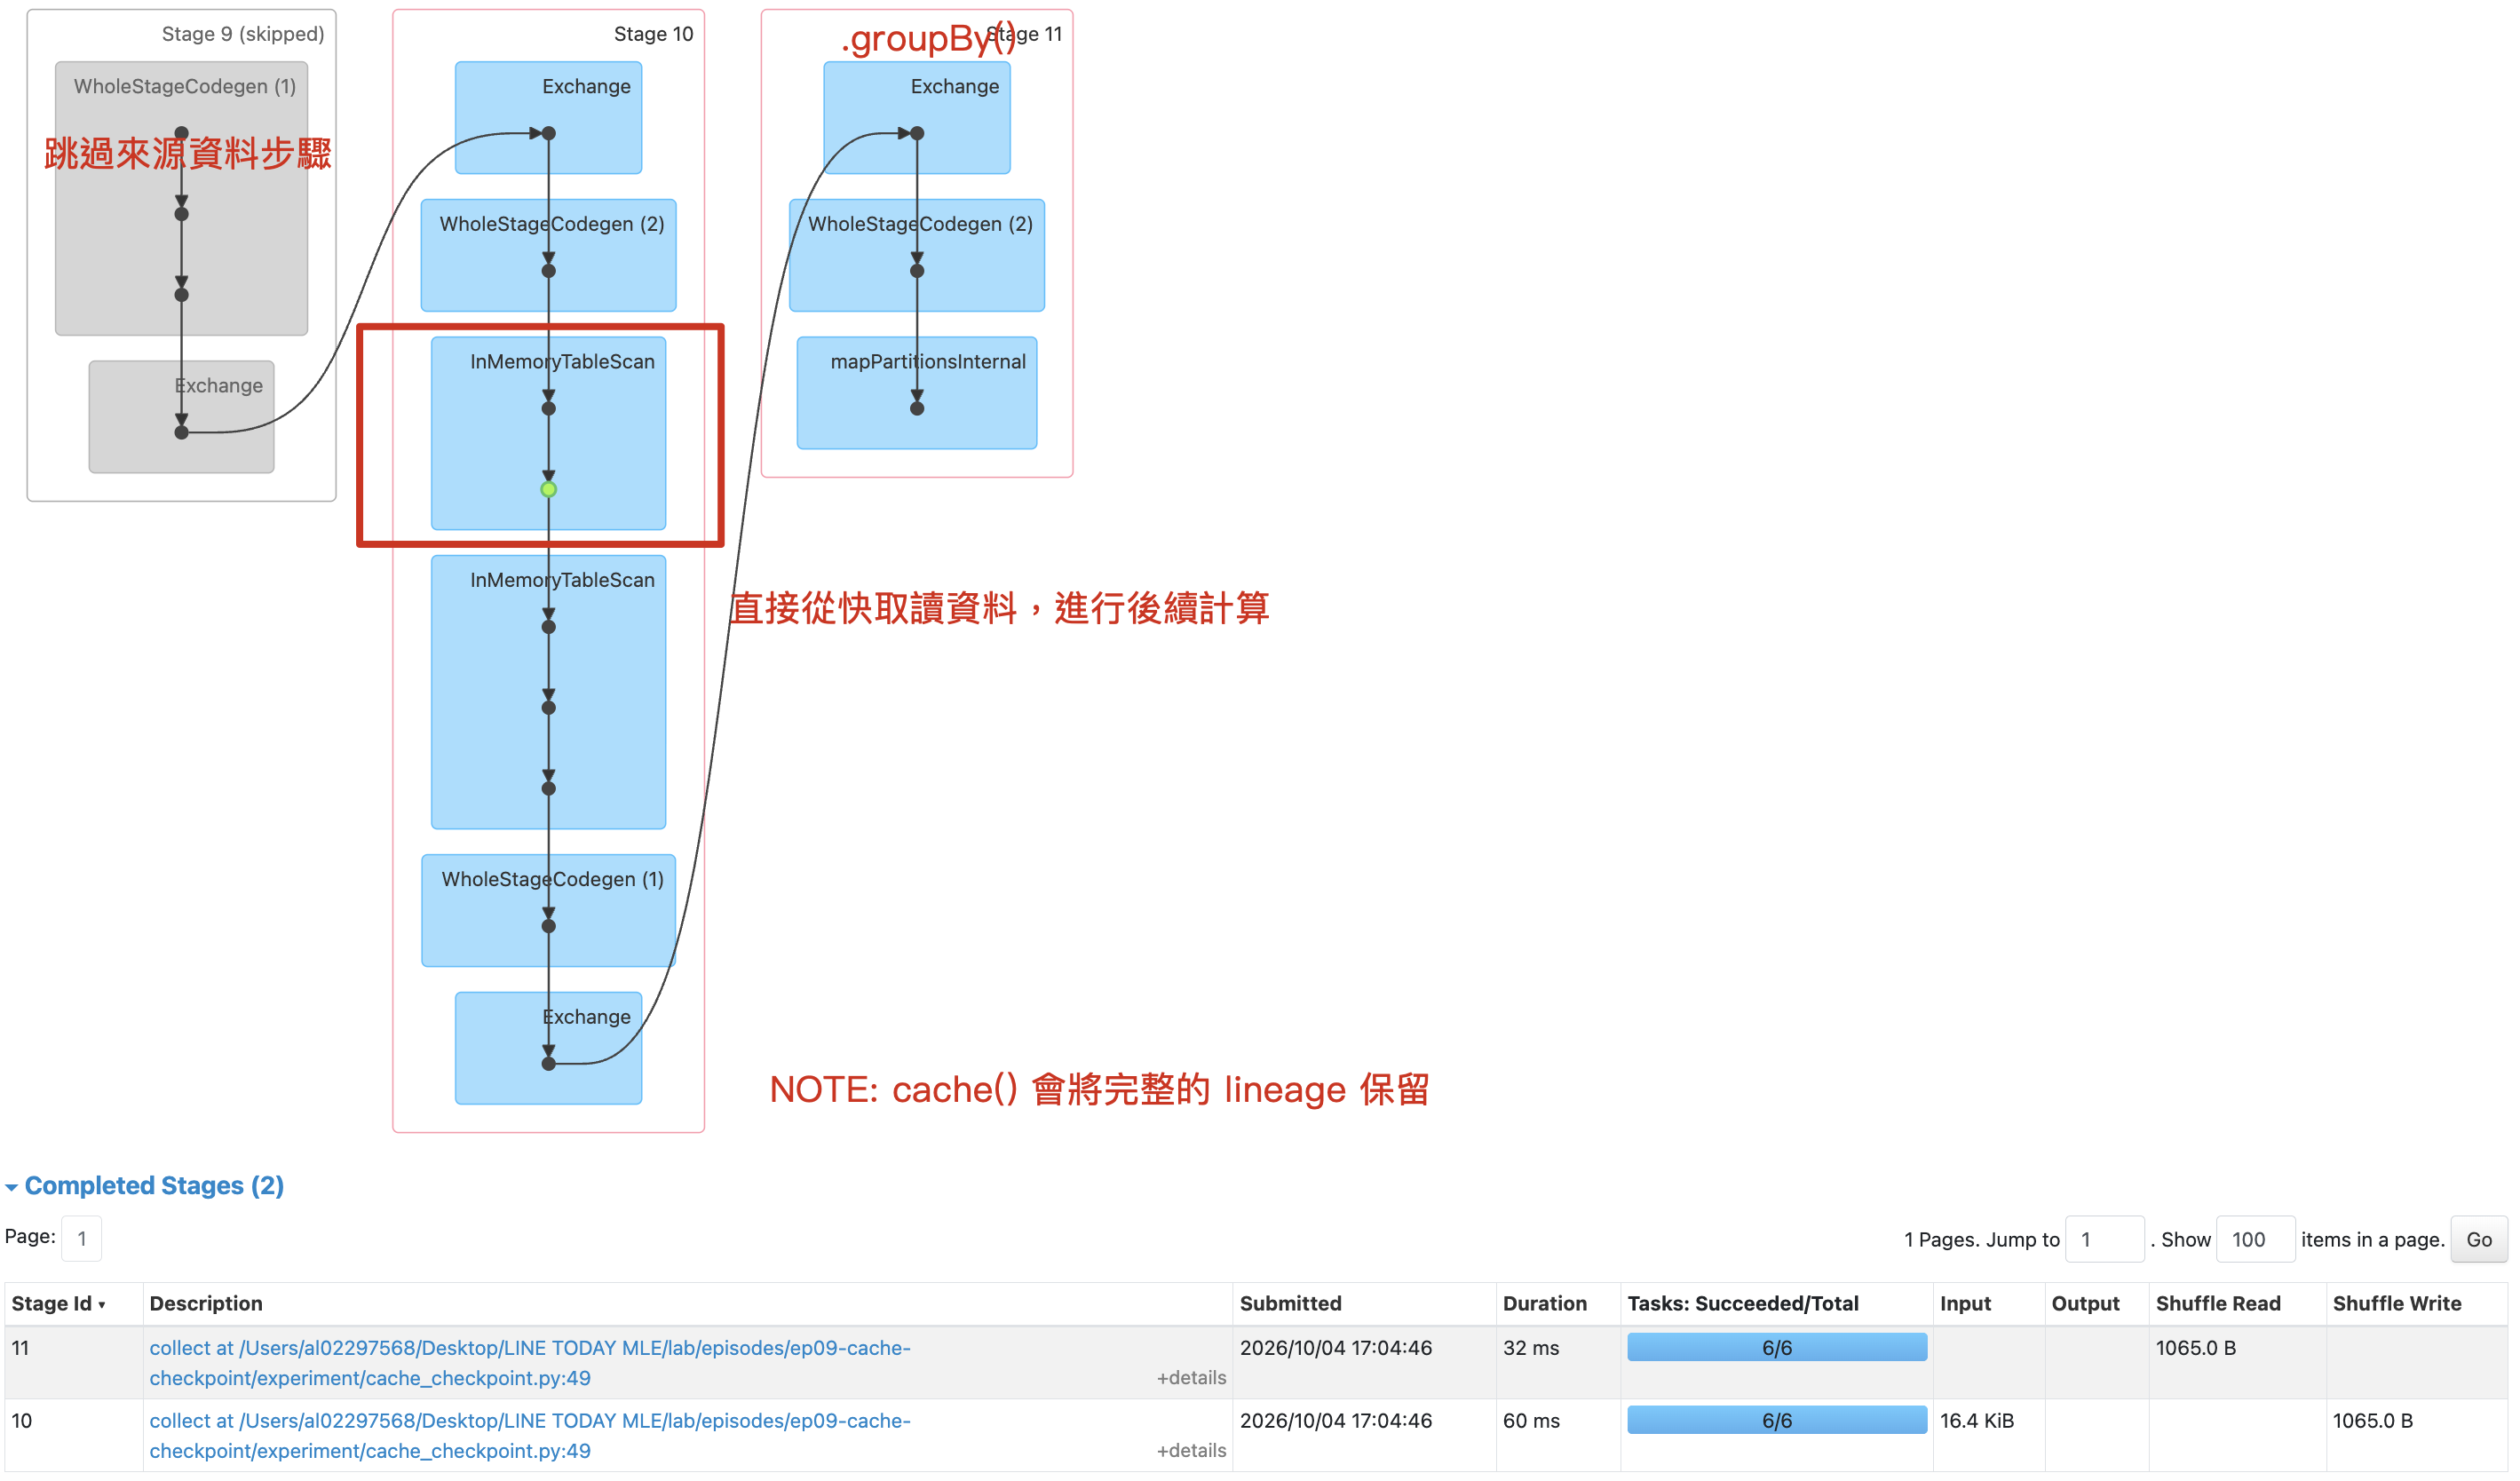
cache() 當下不會讀資料,也不會執行 shuffle。它只是把「這個 DataFrame 的結果值得保存」標到計畫上;第一個 action,也就是這裡的 count(),才會先把原始 lineage 跑完,並將結果存成快取。
因此第一次 materialization 的 UI 仍然看得到來源的 4 個 task 與 customer_id shuffle 的 6 個 task。InMemoryTableScan 已經出現在計畫裡,表示 Spark 將這個 DataFrame 改成可從 cache 讀取的 relation;但第一次 action 之前 cache 還是空的,Spark 必須先把它填滿。
Storage 頁面則讓我確認這次到底存了什麼:6 個 partition 都已快取完成,全部留在 memory,沒有落到 disk。
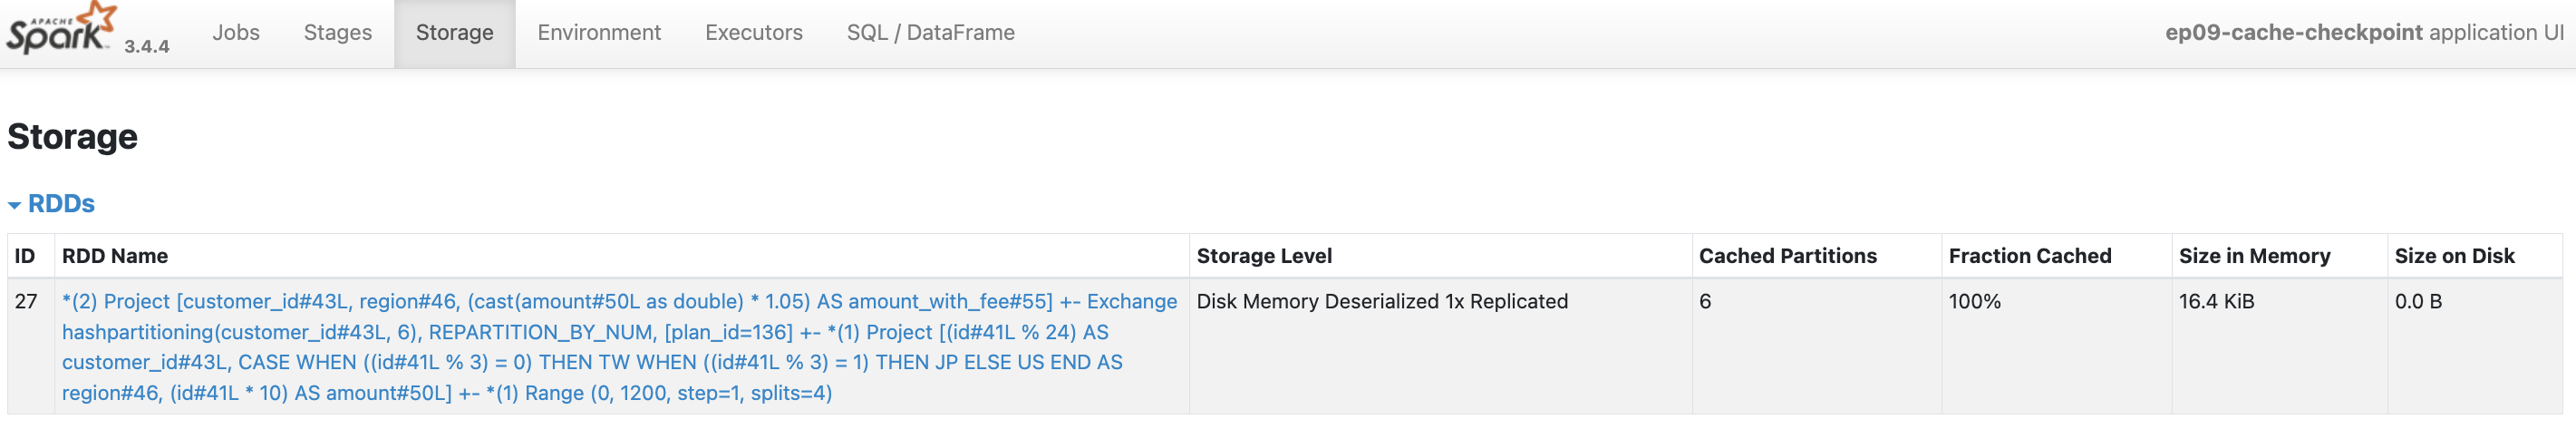
畫面上的 Disk Memory Deserialized 1x Replicated 是 storage level 的能力與優先順序,不代表資料已寫到 disk。這次 Size on Disk 是 0 B,真正代表所有資料都放得進記憶體。
接著才執行第二個 action:
summary = cached_orders.groupBy("region").agg(
    F.sum("amount_with_fee").alias("total_amount")
)

summary.collect()
這一次 Physical Plan 的 InMemoryTableScan 是關鍵證據:原本 build_orders() 的來源讀取與 customer_id shuffle 沒有重跑,Spark 直接從已經依 customer_id 整理好的 cache 結果往下做。不過 groupBy("region") 仍需要自己的 Exchange;cache 能省掉上游工作,不能取消 action 新增的下游 shuffle。
cache() 和 persist() 是什麼關係?在這個 PySpark 3.4.4 實驗中,兩者的預設行為相同:
df.cache()

df.persist()
都會使用 StorageLevel.MEMORY_AND_DISK_DESER。差別是 persist() 可以明確選擇 storage level,例如:
from pyspark import StorageLevel

df.persist(StorageLevel.MEMORY_AND_DISK)
df.persist(StorageLevel.DISK_ONLY)
可以先用這個方向理解:MEMORY_AND_DISK_DESER 傾向以更多記憶體換取較少的序列化成本(計算成本);MEMORY_AND_DISK 傾向儲存序列化後的資料,以降低記憶體使用,但讀取時多一些 CPU 計算成本。
cache 的原始 lineage 仍然存在。快取的某個 partition 因記憶體壓力被 eviction (類似丟掉)時,Spark 可以沿著原始 lineage 重算遺失的部分;這讓 cache 適合「可重算、但希望後續更快」的結果重用。
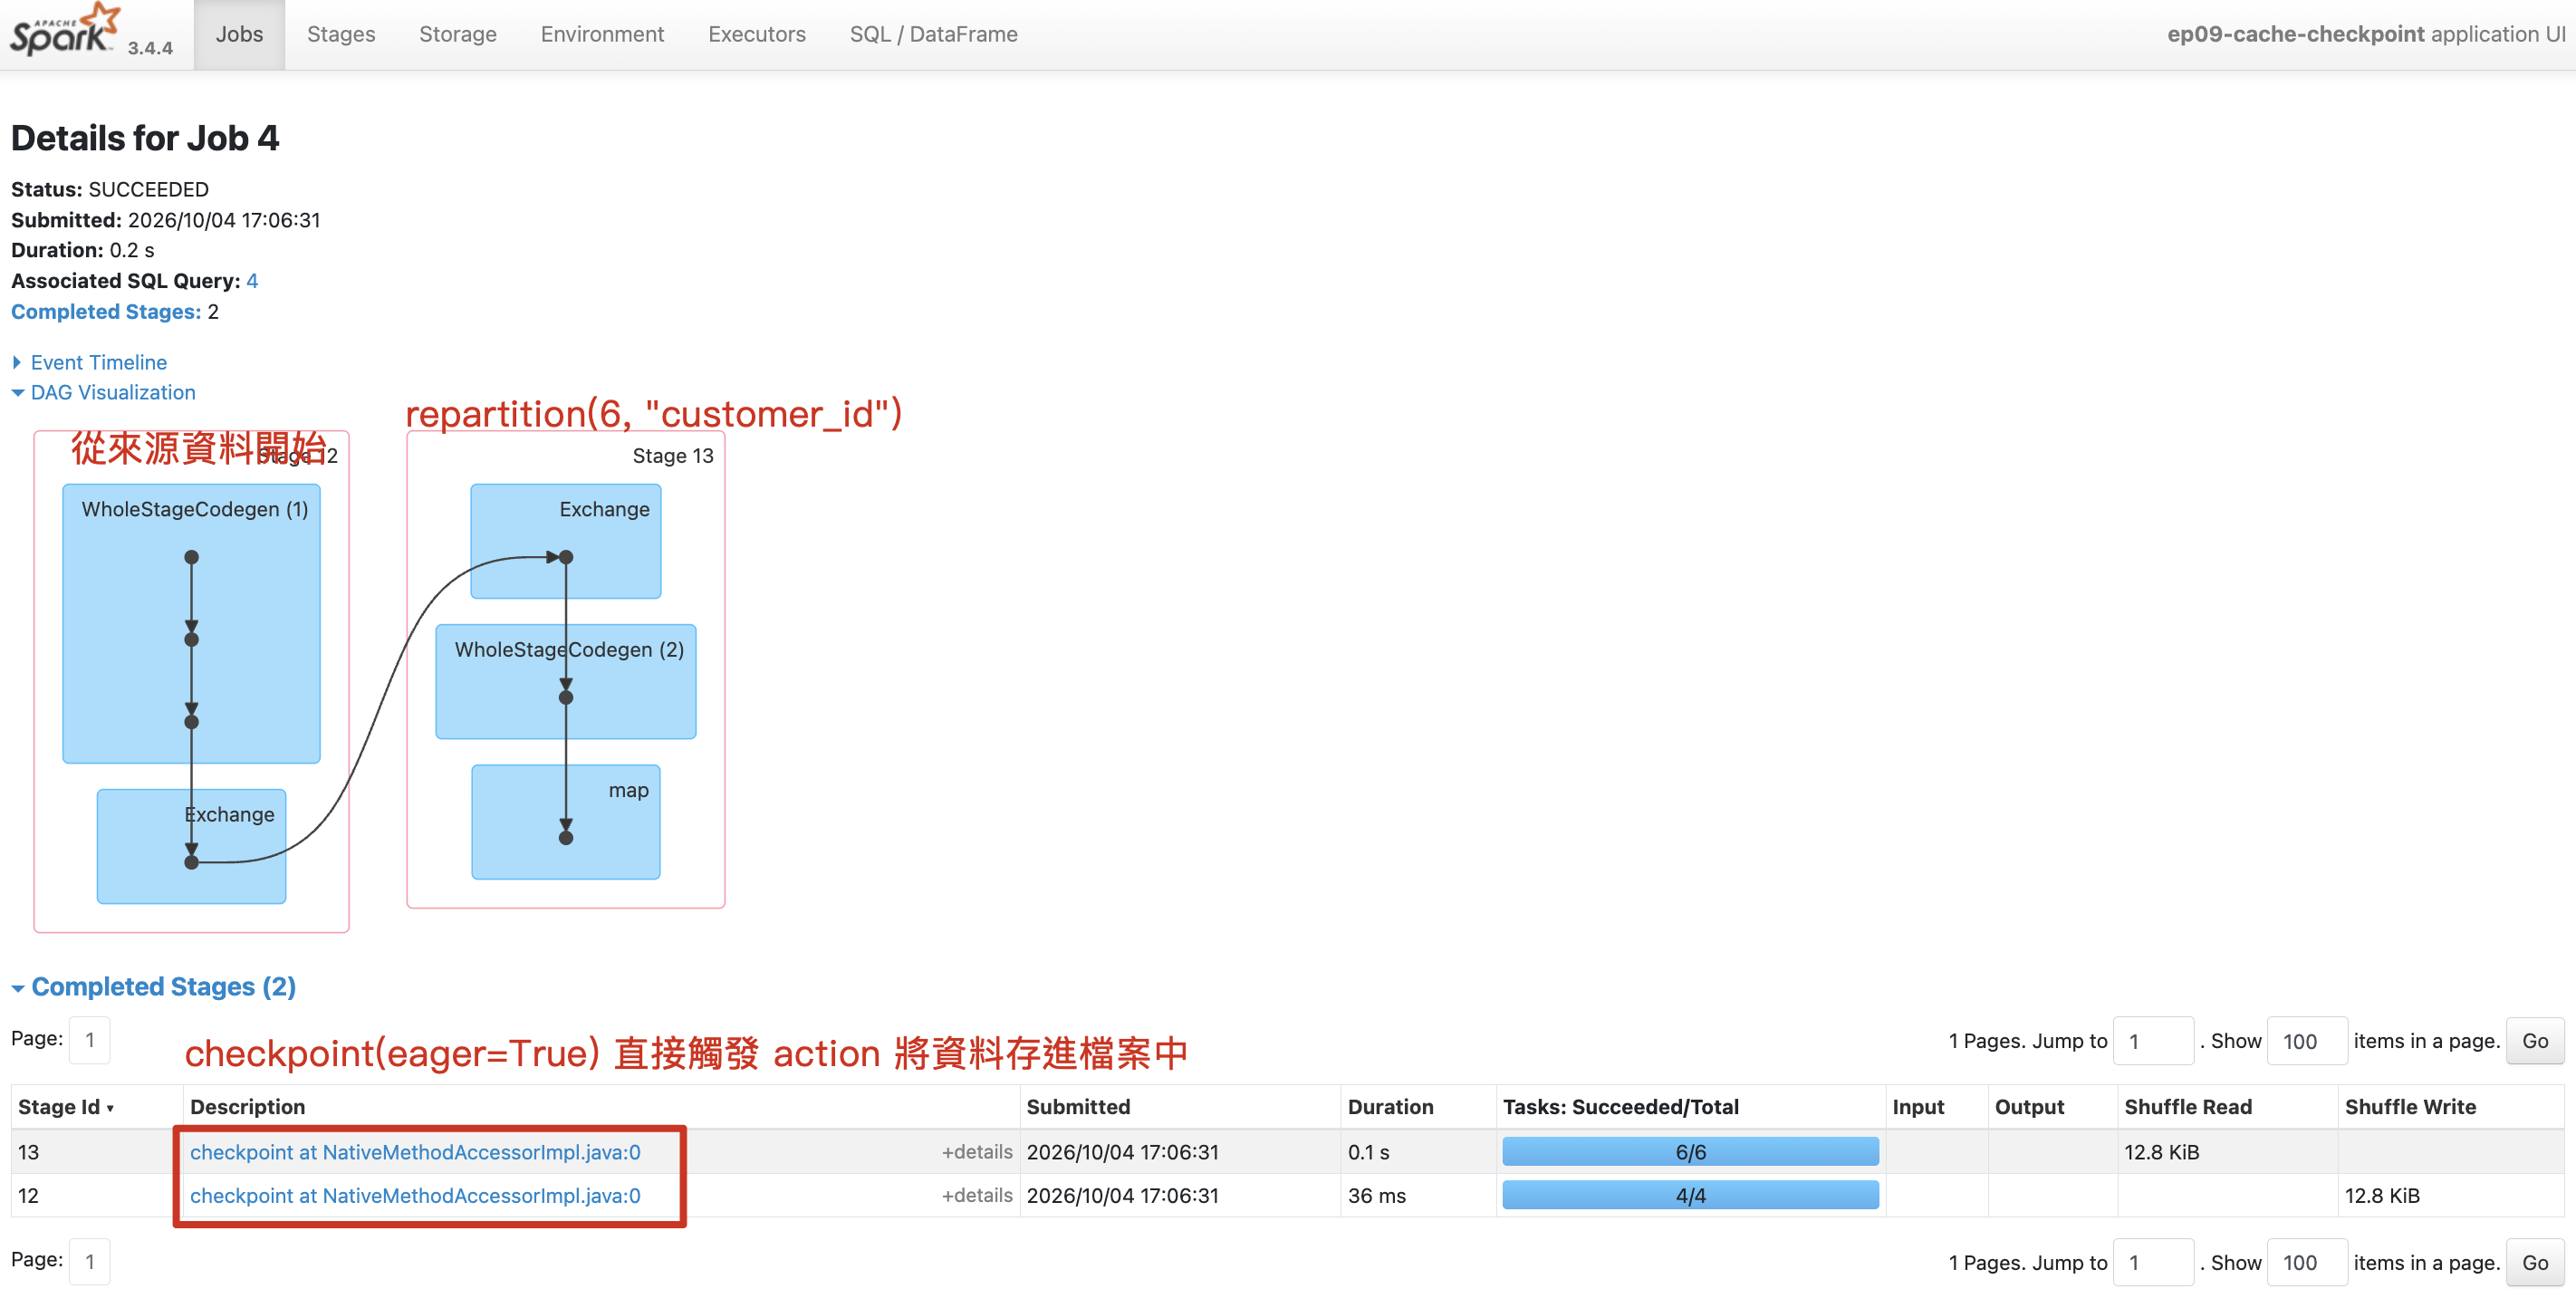
如果我想讓後續工作不再依賴原本冗長的 lineage,選擇是 checkpoint:
checkpointed_orders = build_orders().checkpoint(eager=True)
這個實驗先設定 checkpoint directory。eager=True 是預設值,它使 checkpoint() 立刻觸發一個 Job:來源與 customer_id shuffle 先執行完成,結果寫到 checkpoint 位置。為了讓範例可重跑,我使用的是暫時的本機目錄;正式環境若把 checkpoint 當成容錯邊界,checkpoint directory 必須是可靠、可持久存取的儲存位置。
checkpoint 後再看 Physical Plan,原來的 Range 與 Exchange 不見了,改成從 ExistingRDD 開始。接著的 region 彙總不會回頭重跑原始來源,而是讀取 checkpoint 結果後,才執行自己的 aggregation shuffle。
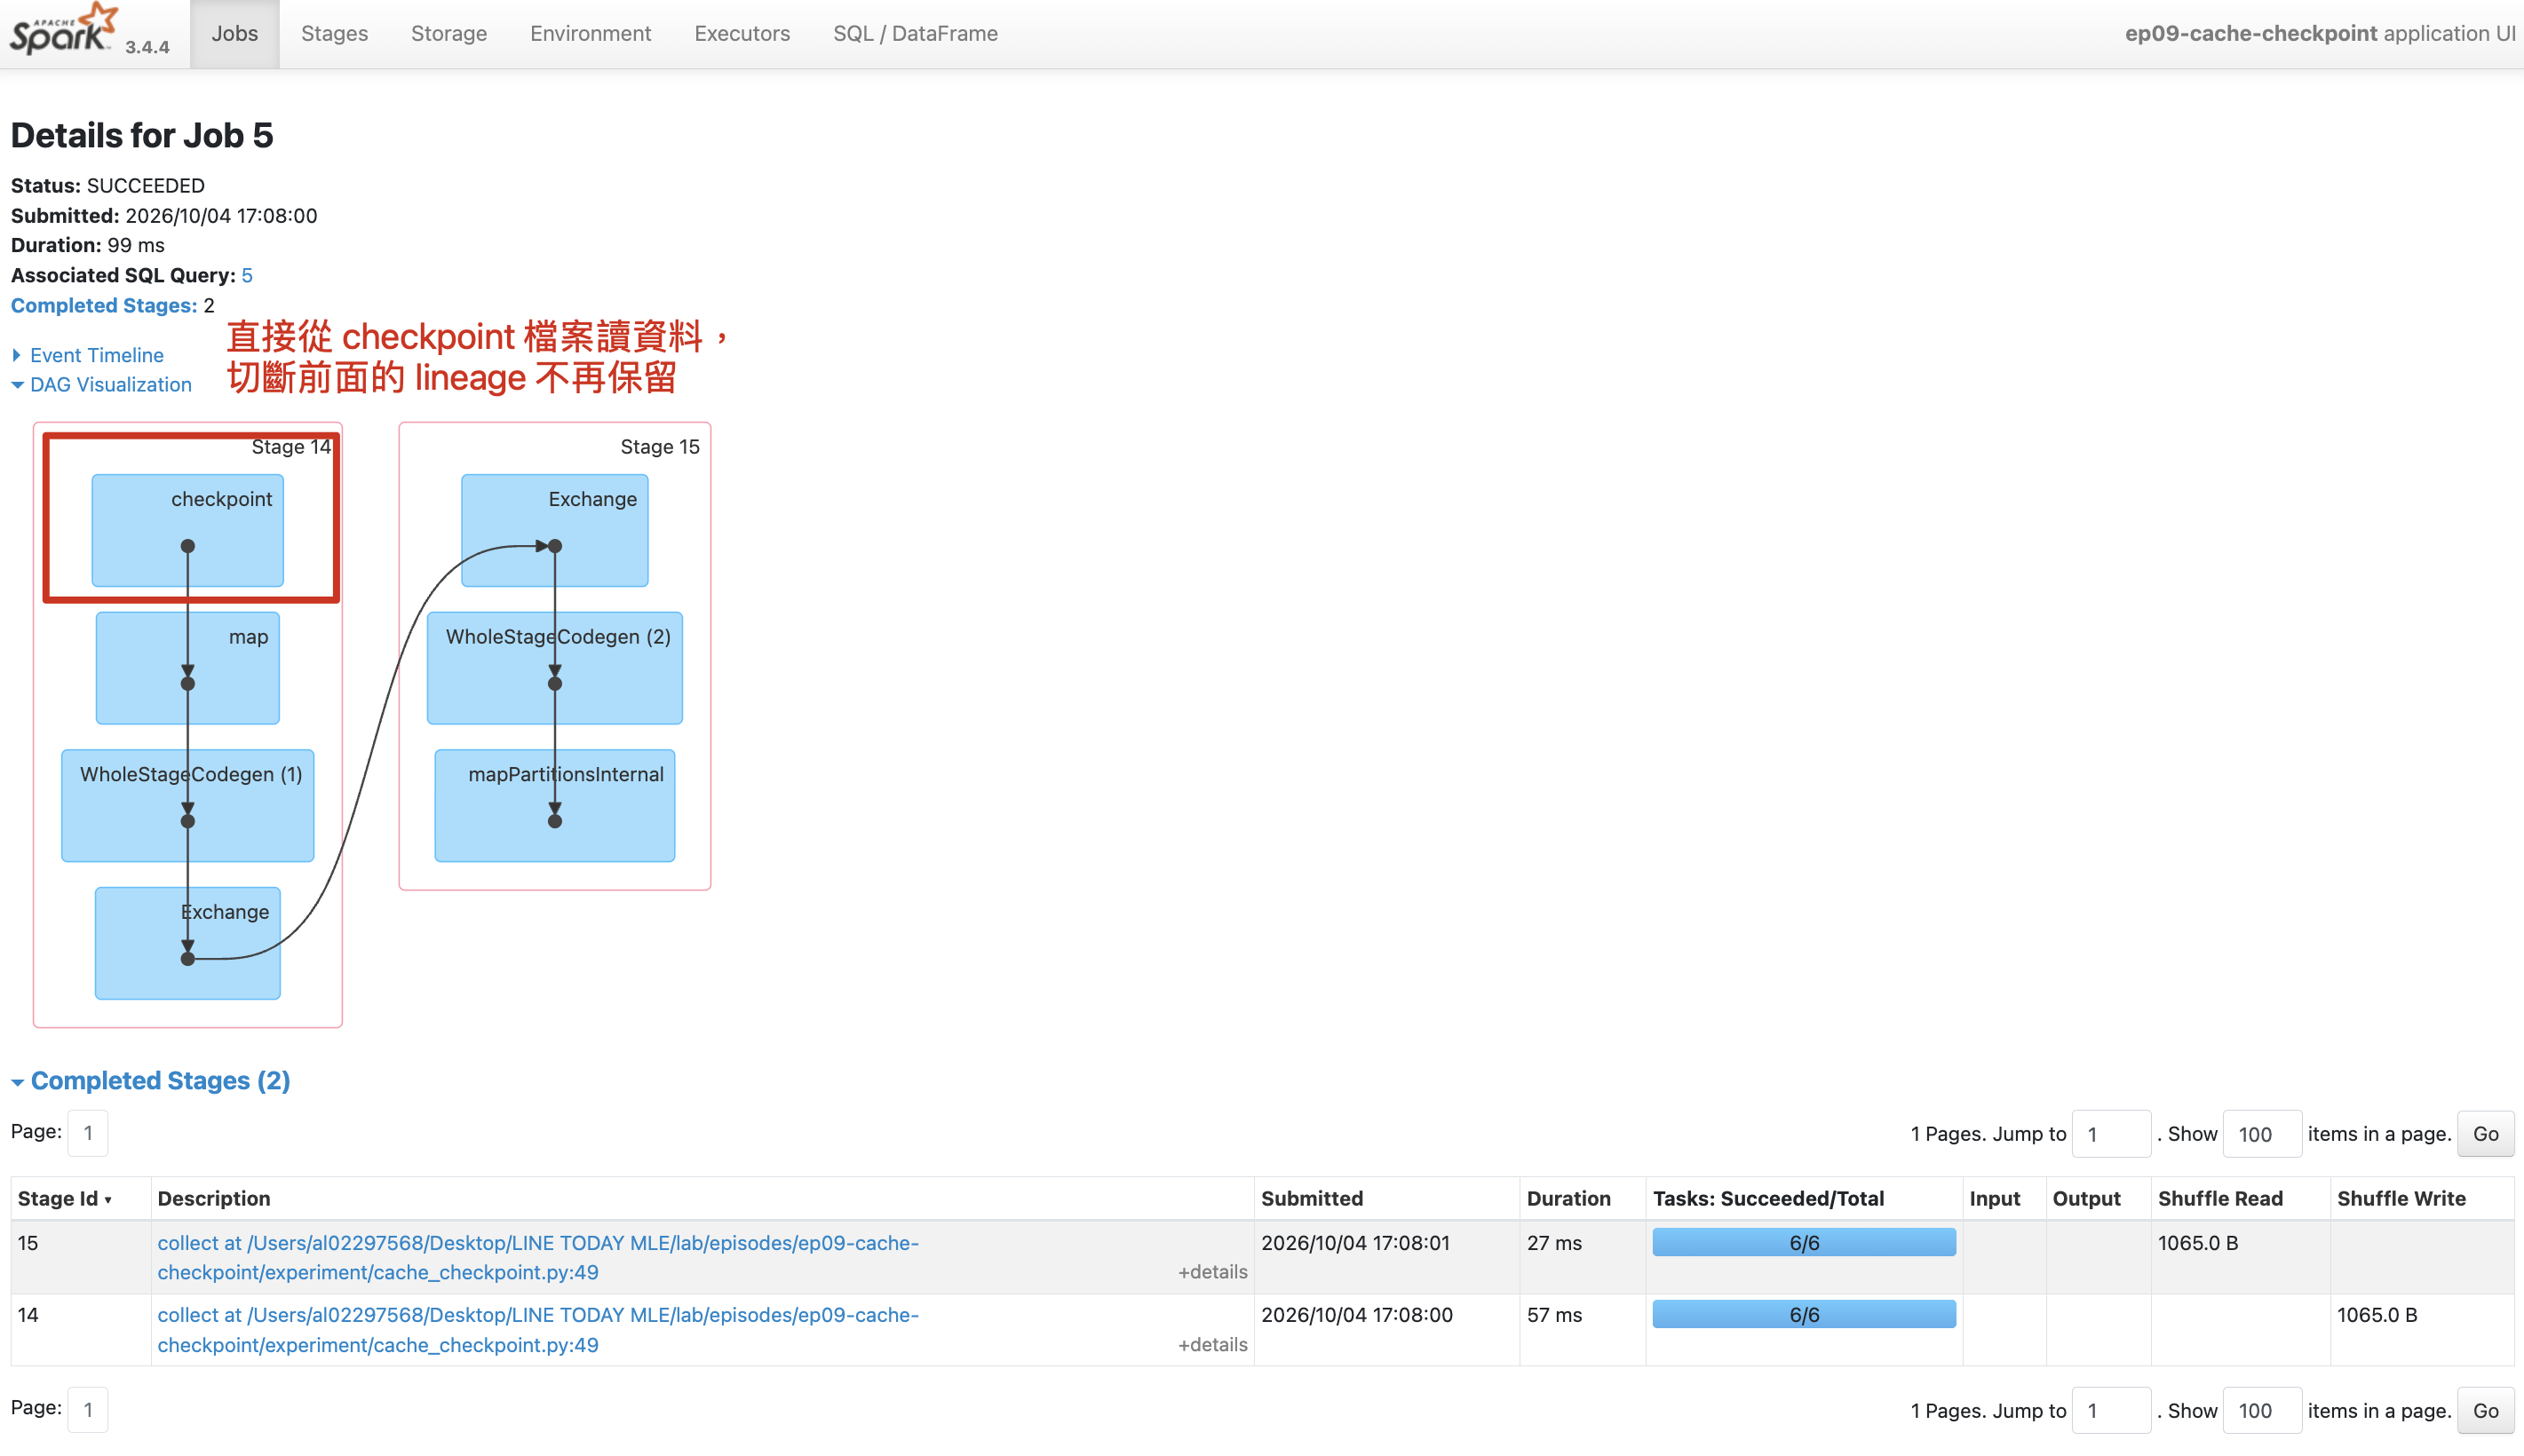
cache 保存的是「下次可以更快讀取」的中間結果;checkpoint 保存的是「從這裡重新開始」的新資料起點。
checkpoint(eager=False) 則會延後這件事:呼叫時不執行,等下一個 count()、write() 或 collect() 才 materialize checkpoint。它適合後面本來立刻就會有 action、又不想先多跑一個 checkpoint job 的流程;但在那個 action 成功前,它還不是一個真正建立完成的切點。
localCheckpoint()?我們團隊曾有一段類似的演進。最早是:
result.cache()
result.count()
result.write.parquet(output_path)
某次在複雜的 ETL 中觀察到執行時間異常長,懷疑前後 action 的 logical plan 可能因 adaptive execution 行為而改變,快取範圍沒有如預期沿用,整個結果又再重算一遍,花了近兩倍執行時間。因此我們改用 checkpoint(),強制切斷原先的 lineage,只保留前面的計算結果變成明確的新起點。
stable_result = result.checkpoint(eager=False)
stable_result.count()
stable_result.write.parquet(output_path)
後來再次碰到其他狀況,又改為:
stable_result = result.localCheckpoint(eager=True)
stable_result.count()
stable_result.write.parquet(output_path)
這是很真實的 ETL 演進,但不代表「AQE 一定讓 cache 失效」。正常情況下,同一個 cached DataFrame 接著 write() 應能讀到 cache;若 UI 又出現上游來源與 shuffle,仍要確認是否引用了不同的 DataFrame、cache 後新增了不可避免的 shuffle,或 cache block 被 eviction。
| 方法 | 預設何時 materialize | lineage | 適合回答的問題 |
|---|---|---|---|
cache()/persist() |
下一個 action | 保留;快取遺失可重算 | 同一結果會被重複使用嗎? |
checkpoint(eager=False) |
下一個 action | 成功 materialize 後截斷 | 我想切斷 lineage,但後面立刻本來就有 action 嗎? |
checkpoint(eager=True) |
呼叫時立刻執行 | 建立後截斷 | 我現在就需要一個可靠的新起點嗎? |
localCheckpoint(eager=True) |
呼叫時立刻執行 | 建立後截斷,但不可靠 | 我能接受本機資料遺失,換取不依賴外部 checkpoint 儲存嗎? |
cache();後者才考慮 checkpoint。若用 localCheckpoint(),要明確接受它不是容錯機制。使用完快取後也應釋放資源:
cached_orders.unpersist()
checkpoint 沒有「刪除 checkpoint 檔」對應的 DataFrame API;就算對 checkpointed DataFrame 呼叫 unpersist(),也不會刪除 checkpoint directory 裡的實體資料。只能在所有下游工作都完成後,由這個目錄的生命週期管理機制清理。實驗使用每次執行都新建的暫時本機目錄,所以可以安全地這樣做:
import shutil
from pathlib import Path

checkpoint_root = Path("/tmp/ep09-checkpoints-for-this-run")

# 所有會讀取 checkpointed DataFrame 的 action 都完成後
shutil.rmtree(checkpoint_root, ignore_errors=True)
正式環境應讓每個 job 使用可辨識、範圍明確的 checkpoint 路徑,並用儲存系統的 lifecycle policy 或排程清理過期資料;不要遞迴刪除多人或多個 application 共用的 checkpoint 根目錄。
我原本把 cache 想成「把 DataFrame 放進記憶體」,現在知道更精確的說法是:它在第一個 action 時 materialize 各個 partition,讓後續 action 可以讀取已算好的結果;但原始 lineage 仍保留,快取也可能被 eviction。
checkpoint 則不是單純更強的 cache。它用寫入 checkpoint 的成本,換取一個被截斷 lineage 的新資料起點。當 Spark UI 裡看到同一段來源和 shuffle 反覆出現時,我至少知道不該只急著加 cache(),而是先分辨我需要的是結果重用,還是計算邊界。
下一段課程會把視角從 Spark 的執行流程移到資料本身:同樣是寫出資料,CSV、JSON 和 Parquet 為什麼會讓 Spark 的讀取方式和成本差這麼多?
🚀 GitHub:
Ep09|同一份 DataFrame 為什麼又跑一次?Cache、persist 與 checkpoint
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — RDD Programming Guide / RDD Persistence:
https://archive.apache.org/dist/spark/docs/3.4.4/rdd-programming-guide.html#rdd-persistence
Apache Spark 3.4.4 — PySpark DataFrame API:
https://archive.apache.org/dist/spark/docs/3.4.4/api/python/reference/pyspark.sql/dataframe.html

 iThome鐵人賽
 看影片追技術
看更多
 jeffery5bai
