

在 Day 14 時,我們替虛擬助教導入了 RAG(檢索增強生成),讓學生可以直接上傳 PDF 檔案,讓 AI 助教檢索內容後再回答。
但真實的學習場景往往充滿限制——如果今天學生使用的學校電子書、線上題庫或講義系統「根本沒有下載權限,只能純複製貼上」呢?
在不能下載檔案的情況下,學生最直覺的操作就是:Control/Cmd+A 全選、Control/Cmd+C 複製,然後把整整 11 個章節、破萬字的文字Control/Cmd+V「整包貼給助教」。
面對這種突如其來的海量文字沖刷,我們今天就來做一場直球對決的硬核極限測試:「不切片、不做向量庫,直接把破萬字的高職電子學(共11章節)完整講義塞進跟助教的對話筐,它還能穩穩當一個會引導學生的 AI 助教嗎?」
打造自動化壓力測試腳本 (test_long_context.py):使用最新 Google GenAI SDK,針對大海撈針(Needle In A Haystack)、引導原則抗稀釋度、Token 消耗與延遲進行指標量測。
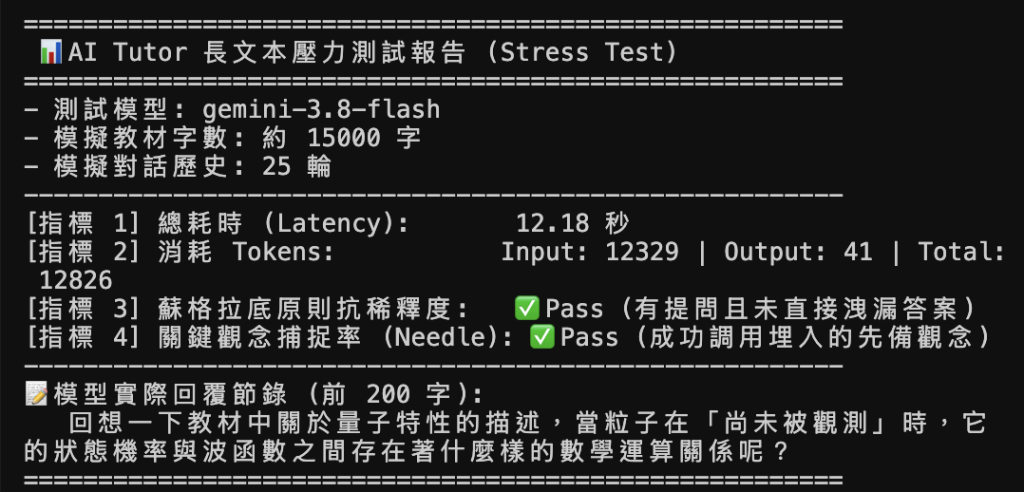
test_long_context.py)為了客觀評估,我們不只靠手動點擊,而是撰寫了一支自動化壓測工具,鎖定三個教育核心指標:
壓測腳本通過後,我們進一步將此能力整合至真實的 geminiService 與 Web 介面。
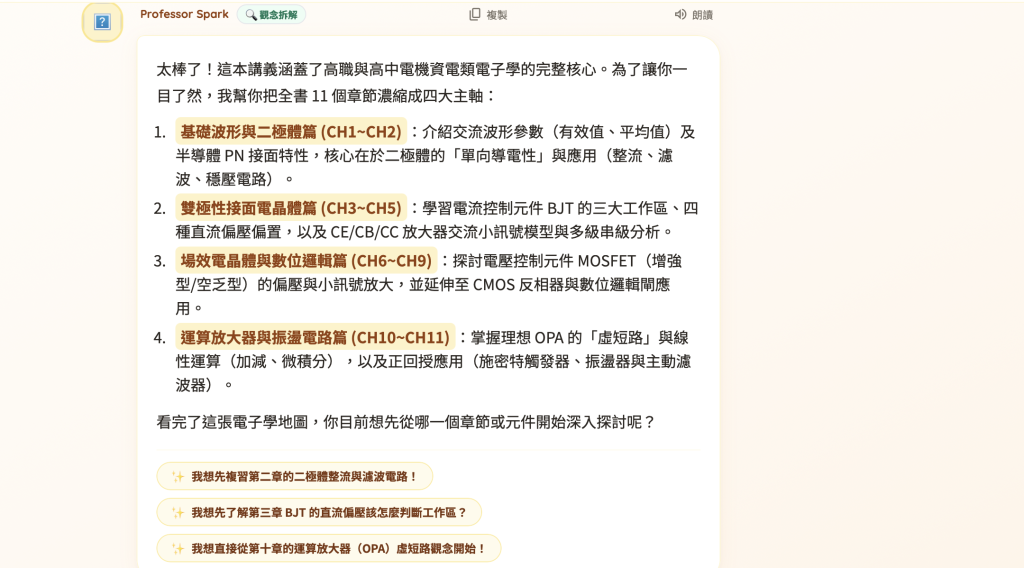
當學生將整本包含 11 個章節的電子學講義一口氣貼上,並要求「介紹每個章節在說什麼並整理重點」時,助教 Professor Spark 在前端展現了全域統整力:
同時在後端終端機中,系統也印出了結構化決策:
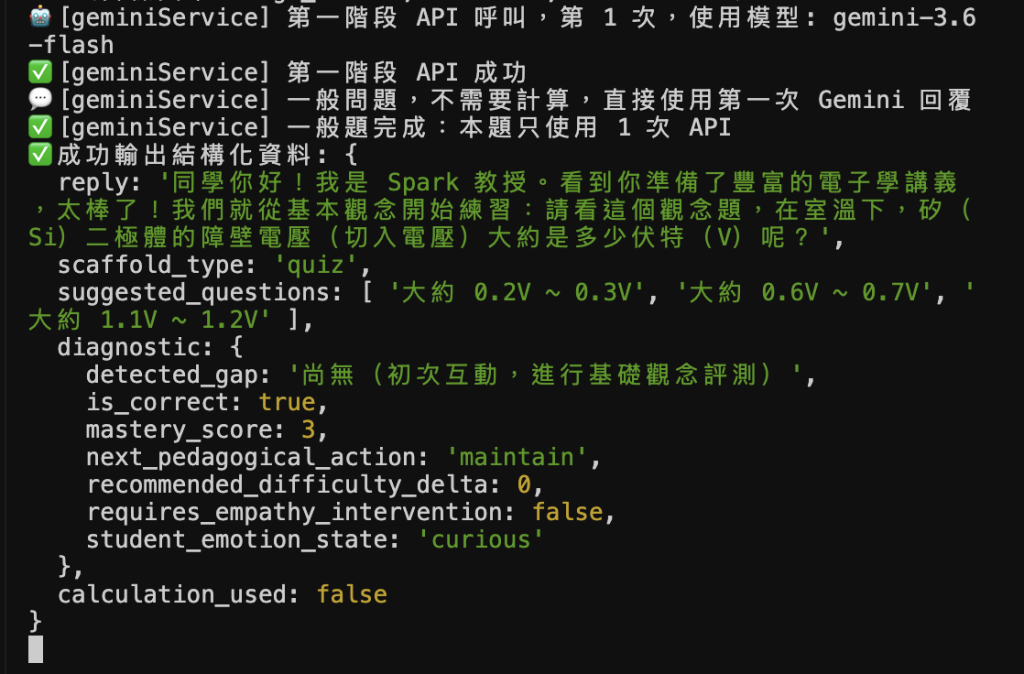
(實測後端診斷 Log:面對萬字教材,AI 依然遵守引導原則,並準確分流不需要計算工具)
server.js)這是我們在真實 Node.js 系統解決 PayloadTooLargeError 的關鍵修改。只要開發需要接收整份教材或長文本的 LLM 應用,這個調整非常重要:
JavaScript
// server.js 節錄
const express = require('express');
const app = express();

// 【關鍵修改】將預設的 100kb 限制大幅提高,以容納破萬字的長篇論文或 Context
app.use(express.json({ limit: '50mb' }));
app.use(express.urlencoded({ limit: '50mb', extended: true }));
test_long_context.py)使用 gemini-3.8-flash 與最新版 SDK 的標準寫法,特別是 types.Part.from_text(text=...) 的強制具名參數:
Python
import os
from dotenv import load_dotenv
from google import genai
from google.genai import types

load_dotenv()
client = genai.Client() # 自動讀取環境變數中的 GEMINI_API_KEY

# 建立超嚴格的 System Instruction 測試抗稀釋度
system_instruction = """你是一位頂尖的 AI 虛擬助教。
請務必嚴格遵守以下教學原則:
1. 採用蘇格拉底式引導 (Socratic method)。
2. 嚴禁直接爆出最終答案。
3. 每次回覆只能問一個關鍵問題,引導學生思考。"""

# 將教材內容與提問封裝,注意 from_text 必須加上 text= 參數
user_content = types.Content(
    role="user",
    parts=[types.Part.from_text(text=f"【教材內容】\n{material}\n\n【我的問題】\n{question}")]
)

# 帶入設定檔並發送請求
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents=[user_content], # 如果有對話歷史,可以使用 history + [user_content]
    config=types.GenerateContentConfig(
        system_instruction=system_instruction,
        temperature=0.2,
    )
)
print(response.text)
透過產生大量無意義文字,並在正中間(Lost-in-the-middle 易發區)插入特定觀念以驗證模型能力:
Python
def generate_mock_material(word_count: int, needle: str) -> str:
    """
    產生指定字數的模擬教材,並在中間段落插入隱藏觀念 (Needle)。
    """
    # 建立用來消耗 Token 的冗長背景知識
    base_paragraph = "這是一段模擬的學科教材內容,涵蓋了基礎科學、物理學、以及進階理論的探討..." * 15

    paragraphs = []
    current_words = 0
    while current_words < word_count:
        paragraphs.append(base_paragraph)
        current_words += len(base_paragraph)

    # 【關鍵】模擬 Lost-in-the-middle:精準在陣列正中間插入 Needle
    middle_index = len(paragraphs) // 2
    paragraphs.insert(middle_index, f"\n\n{needle}\n\n")

    return "\n".join(paragraphs)
TypeErrortypes.Part.from_text("內容") 直接拋出 TypeError: from_text() takes 0 positional arguments but 1 was given。types.Part.from_text(text="內容"),順利通過編譯。PayloadTooLargeError: request entity too largeexpress.json() 預設 body 大小限制僅有 100kb,對於純對話夠用,但只要學生貼入數萬字講義或論文,Request Body 就會輕易被撐爆。server.js,將 json 與 urlencoded 的 limit 顯式提升至 50mb,徹底打通超長 Context 在前端與後端間的傳輸通道。在壓力測試過後就得知它能把高職資電類 11 個章節的繁雜內容,提煉成清晰的四大主軸地圖,並根據全局先備知識,由淺入深地拋出測驗與引導。對學生而言,即使拿到的是無法下載的線上加密講義,只要「複製貼上」,AI Tutor也可以立即進入狀況,讓個人化學習的良好體驗又多了一項。
完成了長文本壓測、Socratic Prompt、多模態 Vision、RAG、Function Calling 工具調用與學習紀錄儲存,我們的 AI 虛擬助教系統已經集齊了所有拼圖。
明天 Day 27【Full Demo】,我們將用一個真實學生的完整解題與診斷歷程,帶來最完整、最震撼的端到端全功能成果展示!


 iThome鐵人賽
 看影片追技術