
Day 20 我先定義 Gemini 的工作:整理設備回報的摘要與議題,理由要能指回原文,未知資訊不能自行補齊。接下來,我想把這份任務搬進程式,讓每次處理都留下可以查回的紀錄。
我仍從 N201「溫度顯示已恢復,但告警一直重複,值班時很困擾。」開始。這條設備回報流程是設計情境,尚未代表真實設備的執行成果。
單則驗證時,我會依序準備請求、呼叫模型、保存完整回應,再從保存的內容取出摘要與議題。先確認這條路徑接得起來,才讓 N202、N203 進入迴圈。只在終端機看到一句回答,還不足以證明下次能知道它分析了哪段文字、使用哪份規則。
REST 操作先確認專案、模型與位置,再用有效的 Bearer 權杖送出請求。專案指出這次使用的資源範圍,權杖辨識呼叫身分,權限則決定這個身分能做什麼。專案名稱填對,不代表另外兩項也正確。
Python SDK 使用 ADC 時,認證程式會依環境尋找憑證。官方列出的搜尋來源包括環境變數指定的憑證、本機 ADC 檔案,以及環境附加的服務帳戶;gcloud CLI 使用的登入憑證與 ADC 也不應混為一談。
假設換了終端機,專案的 Shell 變數變成空白,我會先補回設定,而不是直接重新登入。反過來,變數有值也不代表已取得有效認證。找不到某個憑證檔案,只能證明那個位置沒有檔案,不能直接判定整個環境無法認證。
排錯紀錄會留下使用的身分與設定,權杖本身則不放進輸出檔或文章。
REST 讓我直接看見網址、授權標頭與 JSON 請求;Python 則透過 google-genai 建立客戶端,再呼叫 client.models.generate_content()。官方 SDK 提供 Gemini Developer API 與 Google Cloud 平台的共用介面,但仍須確認實際選用的後端及設定。
我這次沿用 Google Cloud 專案路徑,避免把另一種入口的金鑰設定直接接進來。比較兩種呼叫時,會核對模型、位置、API 版本、系統指令、N201 本文及生成設定。
如果請助理產生 Python 程式,我也會逐項讀回:它是否選了正確後端?有沒有傳入 Day 20 的固定規則?是否只印回答,卻沒有保存回應?套件與方法是不是現行文件支援的寫法?
即使條件已對齊,兩次生成文字仍可能不同。因此,我比較的是摘要是否完整、議題是否符合定義、理由是否有依據,而不是逐字相同才算成功。
取得回應後,我不會立刻假設第一個候選結果一定存在,也不會只取第一段文字就丟掉其他欄位。官方回應格式包含候選內容、finishReason、usageMetadata 與 modelVersion,它們分別協助判讀輸出、停止原因、用量與實際模型版本。
對 N201,我會先檢查請求是否成功,再確認有沒有可用文字,以及生成為什麼結束。若因輸出上限而停止,就將結果列為待檢查,不能只因前半段看起來合理,就當成完整摘要。
即使 finishReason 是 STOP,也只代表正常停止生成,不代表分類正確。若回答把「溫度顯示已恢復」擴寫成「設備已完全正常」,仍要依 Day 20 的原文驗收退回。
完整回應保存後,讀取檔案與抽取文字是本地處理,不需要為了重新查看答案再呼叫模型。這也呼應 Day 18:取得結果與後續保存,是不同階段的責任。
Google Cloud 的錯誤文件區分認證、權限、請求與資源問題。像 401 涉及認證,403 涉及權限;429 則可能與配額或共用服務容量有關,仍須閱讀錯誤內容。
我會依錯誤安排下一步: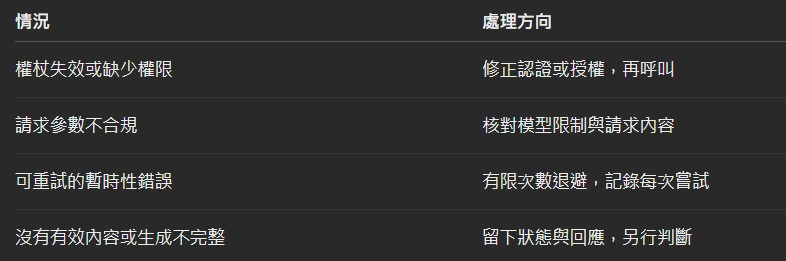
退避是逐步拉長等待時間,降低連續重送的壓力,不是替專案重設配額。嘗試次數或處理時間到達上限,就要留下出口。
若 N202 失敗,我會保存它的紀錄,再依批次設計決定是否繼續 N203。這個處理方式要由程式明確實作,不能因為改用 SDK,就假設所有重試與逐則續跑都已完成。
回答只有一句,不代表請求只有一句的用量。送入的系統指令、分類定義與本文,都屬於請求的一部分;我會從回應的 usageMetadata 保存實際提供的用量欄位,而不是拿畫面上的中文字數估算。
若選用模型另外回傳思考用量,也一併保留。計算前要先核對各欄位定義,以及當時適用的輸入、輸出與思考計費規則,避免把總量和其組成重複加總。
同一則 N201 若分別用 REST 與 SDK 呼叫,就留下兩份呼叫紀錄;重試也各自保存能取得的用量。沒有回傳用量時標示未知,不能補成零,再宣稱沒有費用。
我會分開看三件事:回應記錄的用量、依適用單價計算的估算,以及實際帳單。這篇不沿用固定價格,也不從一次短測試推定整批或整月成本。
最後,我會將回報編號、文字版本、提示版本與完整設定連結起來;每次嘗試另外記錄模型、執行時間、狀態、完成原因、回應位置及可取得的用量。只留「成功」兩個字,無法回答之後的追問。
Google Cloud 提供請求回應記錄功能,可將抽樣內容存入 BigQuery 供分析,但需要設定,不能假設已經啟用。抽樣也不保證涵蓋每則回報,因此我仍要保存自己的逐則處理紀錄。
這些紀錄延續 Day 18 的版本與去重要求。相同文字、相同設定下的重試可以有多次嘗試,後續仍要選定採用哪份結果;若改了本文、提示或模型,則另建分析版本,避免覆蓋後失去比較依據。
Day 22 再把流程擴大為整批議題分類,加入結構化輸出與 BigQuery 載入。到那時,我才能從每則回報一路查回它送出了什麼、取得什麼,以及哪些結果通過了驗收。


 iThome鐵人賽
 看影片追技術