
Day 21 把單次 Gemini 呼叫拆成請求、回應與處理紀錄。接著,我想將整批設備回報整理成議題分類,再寫入 BigQuery。這次實作主線是逐則讀檔、呼叫、解析 JSON、寫出結果與載入資料表;我更在意的是,每一關如何判定成功。
我仍沿用 N201 的重複告警困擾、N202 的操作改善回饋,以及 N203 的校正時間詢問。這條流程用來說明設計,尚未代表真實設備的批次驗證成果。
假設 N201、N203 取得結果,N202 失敗,程式不能只輸出兩列分類就宣布完成。我會從輸入清單保留三則回報的處理紀錄,讓失敗資料有去向,也讓補跑知道該處理哪一則。
呼叫方式延續 Day 21 的 Google Gen AI SDK:逐則讀取完整本文,將固定規則與當次回報送入 generate_content(),再保存回應。官方 SDK 提供這個程式入口,但讀檔、逐則配對與保存流程仍須由我設計。
這次不只在提示寫「請回 JSON」,而是設定 response_mime_type="application/json",並提供 response_schema。官方文件說明,結構化輸出可以限制欄位、型別與必要項目,也支援字串 enum;只設定 JSON MIME 類型,仍可能得到格式不完整的內容。
我將 topic 限定為 Day 20 的「告警處理、操作介面、校正資訊、其他/待判」,另要求 reason 與 evidence。對 N201,期望的結構可以是: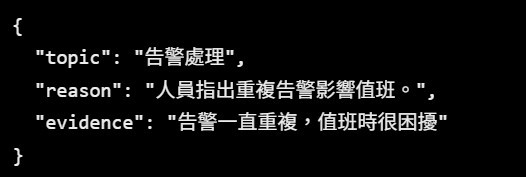
這是預期輸出形式,不是實際 API 回應。回報編號由程式從輸入資料附上,不請模型重新產生;這樣能減少回答正確、編號卻接錯的情況。
取得回應後,我先確認生成狀態與可用內容。官方回應包含 finishReason 等欄位,可以協助判讀停止原因;正常停止仍不能證明分類正確。
接著才解析 JSON,檢查必要欄位、型別與類別清單。若 evidence 要求逐字引用原文,就確認它確實存在於這次送出的文字,而不是模型改寫後看起來相似的句子。
最後才驗收語意。N201 即使回了合法 JSON、類別也在清單裡,若理由寫成「感測器故障導致誤報」,仍超出原文。N202 談操作順暢,不能因為語氣正面,就改用「讚美」取代議題定義。
因此,我會分開保存格式檢查與內容驗收狀態。片段存在、欄位完整,只能通過部分檢查;遇到含糊或多議題的文字,仍可能需要人工確認。
「其他/待判」是對文字內容的判斷。例如「這台最近怪怪的,請協助看看」,模型有取得本文並完成整理,卻缺少足以選定議題的資訊,可以留待確認。
API 失敗則不同。N202 若沒有取得有效回應,不能填入「其他/待判」湊齊分類列數。回應被阻擋、生成中斷或解析失敗,也應留下各自原因。
官方錯誤文件指出,請求不合規、認證、權限與資源耗盡有不同處理方向。我會只對符合重試條件的錯誤採有限次數退避;內容驗收不合格則另外處理,不一律當成暫時性服務錯誤。
紀錄至少分清生成是否完成、驗收是否通過,以及是否成功入表。如此,查到空值時才知道它是未生成、未通過驗收,還是尚未載入。
補跑前,我先用「回報編號、文字版本、分析設定版本」尋找缺少的結果。這延續 Day 18 的辨識方式;到了 Gemini,分析設定還要納入提示、類別定義、Schema、模型與生成參數。
相同條件下的重試,保留同一份結果識別,另記每次嘗試。若不只一份回應通過驗收,就明確選定採用哪一份,不讓它們全部進入統計。
假設 N201 原本選擇單一主要議題,之後改成允許多個議題,輸出結構與統計意義都變了。這應建立新設定版本,不能直接覆蓋舊結果,再拿兩者當成同一種分類。
成功結果會逐則保存,補跑只處理缺少或需重做的項目。程式印出進度可以協助觀察,仍不能取代可讀回的保存紀錄。
通過檢查後,我先將結果寫成可載入檔案。若使用 CSV,就交給 CSV 寫入工具處理理由中的逗號與引號;若要連同版本、狀態及原始回應保存,則沿用 Day 18 討論的 JSON Lines 設計。
載入時明確指定 BigQuery Schema,再核對載入工作與暫存表內容。模型回應的 Schema 管生成格式,BigQuery Schema 管資料表結構,兩者都正確,仍須檢查資料是否對應到正確原文。
對 N201,我會核對編號、文字版本、採用的分析設定與議題;合併正式表前,再檢查必要欄位及相同結果識別是否重複。後續 MERGE 的匹配條件,也沿用既有版本設計。
若 N202 已生成且驗收通過,只在載入階段失敗,就重試寫入已保存結果。不能直接再次呼叫 Gemini,否則可能取得不同分類,卻以為只是補做同一次載入。
假設 N201、N203 已通過驗收並入表,N202 還在處理,議題分布只能描述目前納入的兩則,並另外說明整批處理涵蓋率。等 N202 補入後,占比改變可能只是分母變了,這與 Day 19 的提醒相同。
統計時,我會先選定每則回報採用的分析版本並去重,再按議題計數。重試次數、不同版本與多次載入紀錄,都不能增加回報數;「其他/待判」則保留為可見的一類。
分類是否可靠,還要另做驗收。Google Cloud 的評估資料文件將提示、回答與可選的人工參考答案分開,並建議資料代表實際輸入。我會保存這些對照,使用未參與提示調整的回報檢查分類與理由,不把模型自己的回答當成標準答案。
到這一步,我要能從分類表查回原文、設定與處理紀錄。Day 23 再嘗試在 BigQuery 的 SQL 裡直接呼叫模型;入口改變後,這些驗收責任仍然需要保留。


 iThome鐵人賽
 看影片追技術