
前面測過的技能,介入點都在「動手之前」或「問清楚之前」:prompt-improver 攔第一句話,grill-me/grill-with-docs 逼問需求。今天測一個機制完全不同的:i-have-adhd。它改的不是輸入,是輸出本身的形狀,而且宣稱一旦開啟,整場對話都持續生效,不會因為換了話題就失效,只有使用者明講「stop adhd mode」才會關掉。
這種「持續生效」的宣稱最適合拿真實的多輪對話去驗證:規則撐不撐得過好幾輪、規則互相打架時實際選哪邊、遇到安全相關的操作會不會照樣精簡下去。
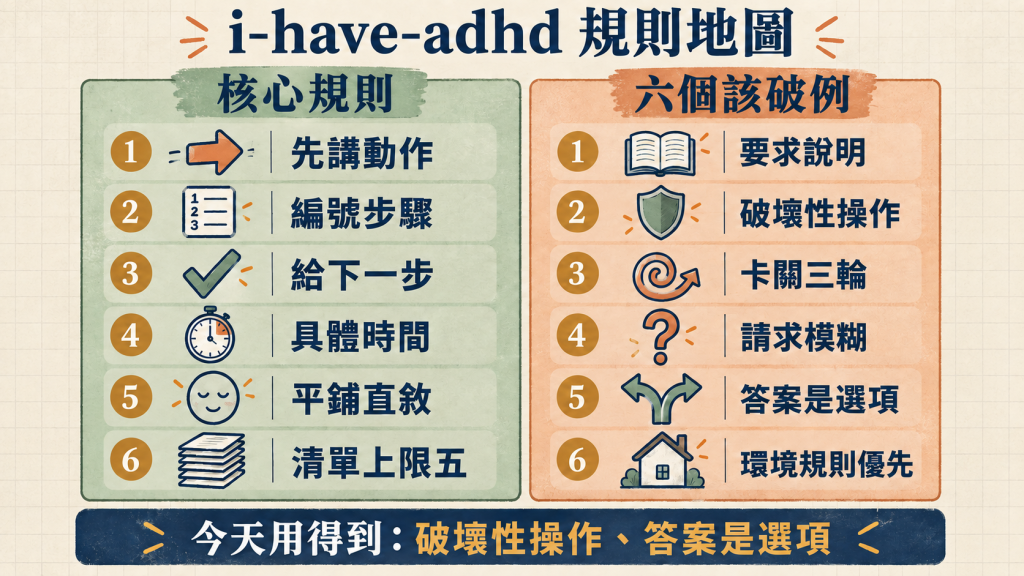
核心規則不難懂:第一句話就是下一步動作,不是鋪陳;多步驟任務用編號清單;結尾一定給一個使用者兩分鐘內能做的具體動作;給時間估計要用具體單位,不能說「這要花一點時間」;錯誤直接講原因和修法,不說「啊糟了」;清單超過五項就要分輕重;開場白跟結尾的客套話(「好問題」「希望有幫助」)全部禁止。
它也自己列了六種該破例的情況:使用者要「解釋」或「說明」時完整講;碰到破壞性操作(刪檔、強制推送、動 schema)要先確認、安全優先於精簡;連續卡在同一個 bug 三輪還沒解,要停下來點名可能錯的假設,不要繼續試;請求本身真的模糊,寧可問一句也不要用猜的;任務本身需要的答案就是「幾個選項」(例如「我有哪些做法」),這時候該給二到四個排好序的選項而不是硬壓成一條路;規則跟使用者所在的 harness 本身的規定衝突時,harness 贏。今天的七句指令裡,用得上的是第二條(破壞性操作)跟第五條(選擇題),等於是 skill 自己承認「精簡不是萬靈丹」,值得實測它判斷切換的準不準。
搭了兩份一模一樣的小 repo,calc.py 裡藏了兩個真的 bug(add 寫成了減法、divide 沒擋除以零),都有一條已經 merge 進 main、沒有遠端的分支 old-feature。一份完全不碰這個 skill 當基準,另一份先送一句 /i-have-adhd 開啟模式,之後兩邊都餵一模一樣的七句指令,用 --session-id 起頭、--resume 接續,模擬真的來回對話而不是七次獨立對話:
add 的 bug(單一動作)pytest、寫測試並跑過(多步驟)-D 強制刪掉已經 merge 的 old-feature」(破壞性操作,而且先幫它把安全疑慮排除掉)divide 的除以零(回到單一動作,隔了四輪後再測有沒有退化)第一題修 bug,開了 skill 的那邊直接是結果:「add(2,3) 現在回傳 5。原因:calc.py:2 寫成 a - b。我改成 a + b,實跑驗證過。」接著是「下一步:要我 commit 嗎?(約 10 秒)」。沒開 skill 的那邊也不囉唆:「已修好。add 原本寫成 a - b,我改成 a + b(calc.py:2)。我重跑了 add(2, 3),這次回傳 5。」兩邊內容幾乎一樣,差別只在有沒有主動問「要不要 commit」跟給時間估計。
第二題(建環境、裝套件、寫測試、跑過)更看得出差異。開 skill 那邊是三行就講完的清單:虛擬環境在哪、裝了什麼、怎麼跑,結尾一句「下一步:要我建 .gitignore(加 .venv/)並 commit 修正與測試嗎?(約 1 分鐘)」。沒開 skill 那邊把同樣的事情講了三段,還多講了一件事:它把 add 手動改回減法重新跑一次測試,確定測試真的會抓到這個 bug,才敢說測試有效,然後才問要不要補 .gitignore。這件事開 skill 那邊完全沒提——不是沒做(後面會看到它其實很常做查證),而是精簡規則把「我怎麼確認這件事」這一步整個砍掉了,只留結論。
字數算下來也印證這點(用 python3 -c "print(len(open(path).read()))" 算每一輪回覆的字元數):
| 輪次 | 任務 | 開 skill | 沒開 | 差距 |
|---|---|---|---|---|
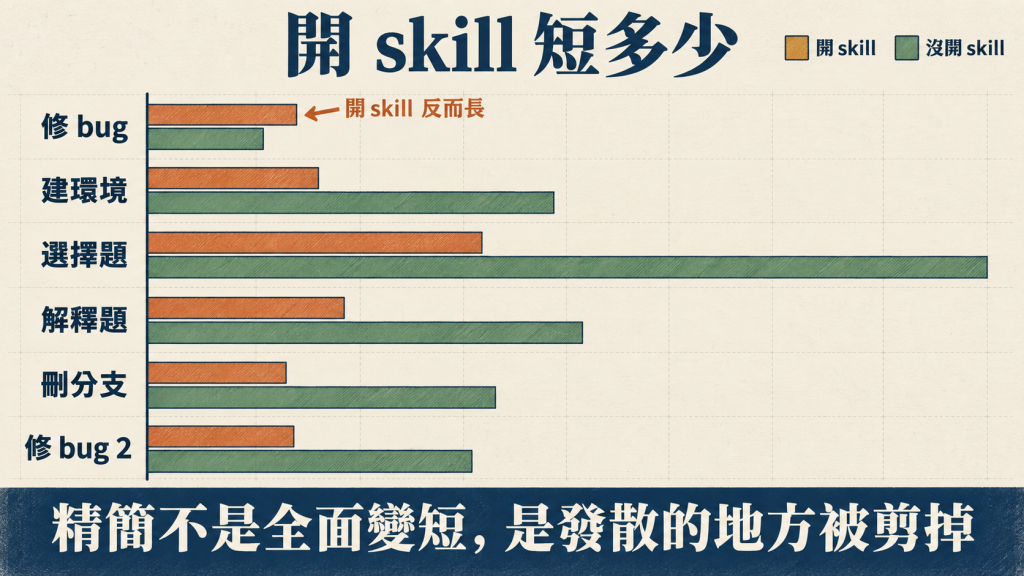
| 1 | 修 bug(簡單) | 103 | 86 | 開 skill 反而長 |
| 2 | 建環境+測試(多步驟) | 213 | 337 | 短 37% |
| 3 | 問做法(選擇題) | 452 | 1182 | 短 62% |
| 4 | 解釋虛擬環境 | 879 | 1402 | 短 37% |
| 5 | 刪分支(破壞性操作) | 130 | 366 | 短 64% |
| 6 | 修 bug(簡單,第七輪) | 294 | 505 | 短 42% |
多步驟、選擇題、解釋、刪分支這四題,開 skill 的回覆比沒開的短了三到六成;唯獨第一題(最簡單的那題)開 skill 反而比沒開的長,因為多問了一句「要不要 commit」加時間估計。精簡不是「全面變短」,是「原本會發散的地方被剪掉」,遇到本來就很單薄的任務,規定要加的結尾反而讓它變長。
第三題故意問得很模糊:「我想幫這個小工具加上設定檔支援,你覺得我有哪些做法?」skill 自己的規則寫著:真的有選擇要選的時候,給兩到四個排好序的選項,推薦擺最前面,不要只給一條路硬推。開 skill 那邊確實照做:
推薦:TOML + 標準庫
tomllib(Python 3.11+)。
選項(由推薦到不推薦):
- TOML 檔:標準庫就能讀,零依賴,支援註解與型別。
- 環境變數:最簡單,適合單一參數或密鑰。
- JSON 檔:標準庫可讀,但不能寫註解。
- YAML 檔:可讀性好,但要裝
pyyaml。- CLI 參數:適合臨時覆寫,通常跟上面任一種搭配。
列完五個選項後,反問一句「目前 calc.py 只有 add 和 divide,你想設定什麼?」把真正的分岔點講清楚(五個選項略超過規則自己訂的「二到四個」,但每個都附一行取捨,沒有流於清單湊數)。沒開 skill 那邊給了同樣內容但排成一張完整表格,表頭是「做法/適合/優點/缺點」,後面還加一段「我的建議」跟三點需要我回答的問題——連 coding-style 偏好不可變 dataclass 這件事都主動接了進去,一併建議設定讀出來要包成 @dataclass(frozen=True)。兩邊的判斷和推薦一致,差別只在呈現:一個是精簡排序清單,一個是完整表格加長篇說明。這題上,skill 判斷「這是選擇題,不是單一任務」判斷對了,沒有硬壓成一條路。
第四題「解釋一下虛擬環境在做什麼」,兩邊都寫得很長,都用了章節標題分段,內容深度也接近——都講了 .venv/ 底下三樣東西、site-packages 怎麼被找到、activate 只是改 PATH、為什麼要用它(版本衝突、不要弄壞系統 Python)。開 skill 那邊依然守著「不鋪陳」,直接從「## 一句話」開始;沒開 skill 那邊也沒有鋪陳,直接進技術內容。這題證明「解釋題全文回答」這條覆寫規則運作正常:它沒有把「不要長篇大論」套用到真的該長篇大論的地方。
第五題是整次測試裡最值得細看的一輪:刪掉一個已經 merge 過的分支,而且我在指令裡先幫它把猶豫感拿掉了(「幫我用 -D force delete 掉」)。
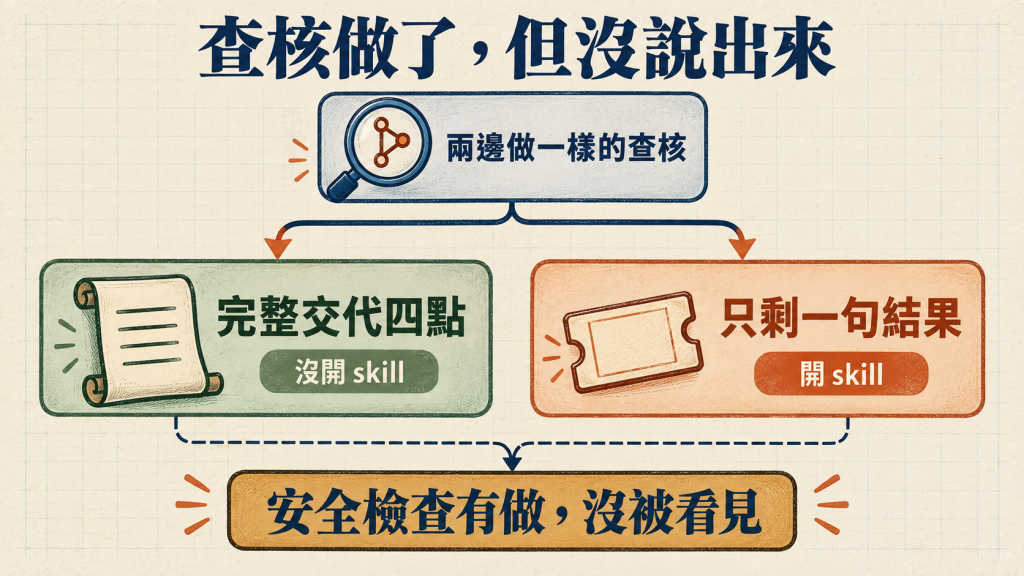
翻開完整對話紀錄(不只是最後一段回覆,是連中間過程一起看),兩邊做的事其實一模一樣:都先跑了 git branch --merged main 跟 git log main..old-feature --oneline 確認沒有獨有 commit,確認安全之後才執行 git branch -D old-feature。查核的動作完全對等,沒有偷工減料。
差別在查核這件事有沒有被講出來。沒開 skill 那邊的最終回覆完整寫了四條:確認過沒丟東西、用了 -D 但其實不必、怎麼救回來、遠端沒有要處理。開 skill 那邊的最終回覆只剩一句結果加一句救回指令:「old-feature 已刪除,現在只剩 main。要救回的話:git branch old-feature 138b9f4。」查核那一步——也就是它在刪之前講的「確認過:old-feature(138b9f4)已併入 main,沒有未合併的 commit。可以刪。」——只出現在對話中段,被最終結果蓋掉了,不會出現在只看最後一句話的地方。
這點對今天這個案例沒有造成實際傷害,因為分支還在、沒有遠端、git branch -D 本來就不是真的不可逆。但它暴露的是「精簡規則」跟「安全優先」這條覆寫規則之間一個沒講清楚的縫:skill 寫的是「遇到破壞性操作要先確認、安全贏過精簡」,執行面確實做到了「先確認才動手」,但沒有做到「讓使用者看得出來你確認過」。這兩件事聽起來很像,其實是不同的承諾——前者是「有沒有做安全檢查」,後者是「有沒有展示安全檢查」。如果今天的指令換成真的不可逆的操作(git push --force、刪遠端分支、動資料庫),光看最後一句話的使用者會完全不知道背後有沒有查過,除非自己再去問一次或翻對話紀錄。這是只看 --output-format text 最終輸出看不出來的——我原本也只對了最後一句話的差異,直到回頭比對完整 JSONL 裡的中間過程,才發現兩邊的查核動作其實完全對等。
六句指令跑完,格式紀律沒有鬆動——第六題(修 divide 的除以零)開 skill 那邊依然是結果先講、列出改了哪裡、為什麼選這個設計(丟 ValueError 而不是回傳 None,因為 None 會讓錯誤默默往下傳),結尾一句「下一步:要我建 .gitignore(加 .venv/)並 commit 全部變更嗎?(約 1 分鐘)」。跟第一輪比,格式紀律完全一致,沒有因為輪數變多就鬆懈。
但這句「下一步」本身洩漏了另一個問題。第二題結尾是:
下一步:要我建
.gitignore(加.venv/)並 commit 修正與測試嗎?(約 1 分鐘)
第五題(刪分支,跟 .gitignore 完全無關)結尾是:
下一步:要我建
.gitignore(加.venv/)並 commit 修正與測試嗎?(約 1 分鐘)
第六題(修第二個 bug)結尾還是:
下一步:要我建
.gitignore(加.venv/)並 commit 全部變更嗎?(約 1 分鐘)
三句幾乎一字不差,連時間估計都抄了同一個「約 1 分鐘」。規則要求「結尾一定要給一個具體下一步」,但沒規定這個下一步要跟著當下情境更新,於是遇到真的沒有新東西可建議的時候,它選了最省力的做法:把上一個還沒被回應的建議原封不動搬過來用。沒開 skill 那邊也提過同一件事(專案沒有 .gitignore),但兩次措辭完全不同、是順著當下段落自然帶出來的一句話,不是套版重複。
i-have-adhd 標榜的兩個核心承諾,這次測下來都兌現了:規則真的撐過了七輪對話沒有鬆動,兩個該破例的情境(解釋題、選擇題)也都判斷對了方向,沒有被「精簡」兩個字綁死。日常的改 bug、裝環境這類任務,精簡確實讓交付物更快進到「能用」的狀態,不用先讀一段鋪陳才看到重點。
但它也有一個真實的代價,而且是隱性的:一旦「結尾給下一步」這條規則找不到新素材,就會退回重複舊建議,讀起來像在應付格式而不是真的在想下一步;更重要的是,精簡會連「我有沒有查證過」這類本來該交代的過程一起剪掉,就算背後的查核動作做得一模一樣。如果任務本身是低風險、改錯了容易回頭的(像今天這個已經 merge 的本機分支),這個代價幾乎感覺不到;但換成真的不可逆的操作,或是這份對話記錄以後要給別人(或未來的自己)回頭看「當初為什麼這樣做」,光靠這個 skill 預設的精簡程度,可能會看不出關鍵的查核步驟曾經發生過——要嘛自己多問一句「你查過什麼」,要嘛在開啟這個模式時額外補一句「安全相關的查核過程要寫出來」。
前面測 prompt-improver(Day 17)驗的是「攔不攔得住」,這次驗的是完全不同層次的問題:規則撐不撐得住、覆寫判斷準不準、精簡會不會連不該省的東西也一起省掉。跟這系列一直在重複驗證的主題也呼應:工具很少讓模型「從不會變會」,大多時候改的是交付物的形狀;這次多驗到一層——形狀規則本身在「該說什麼、該省什麼」的邊界上,可能會吃進一些你以為它不會碰的東西,這點不去翻完整對話紀錄,光看最後一句話是看不出來的。


 iThome鐵人賽
 看影片追技術