
spec-kit 更新速度快到很誇張——寫這篇的當下,最新版是前一天才發的,commit 紀錄裡還有今天的更動。這種節奏下,任何靠記憶寫出來的介紹都有可能已經過時,所以今天先把官方目前的機制讀過一輪,再動手測,而不是照印象寫。
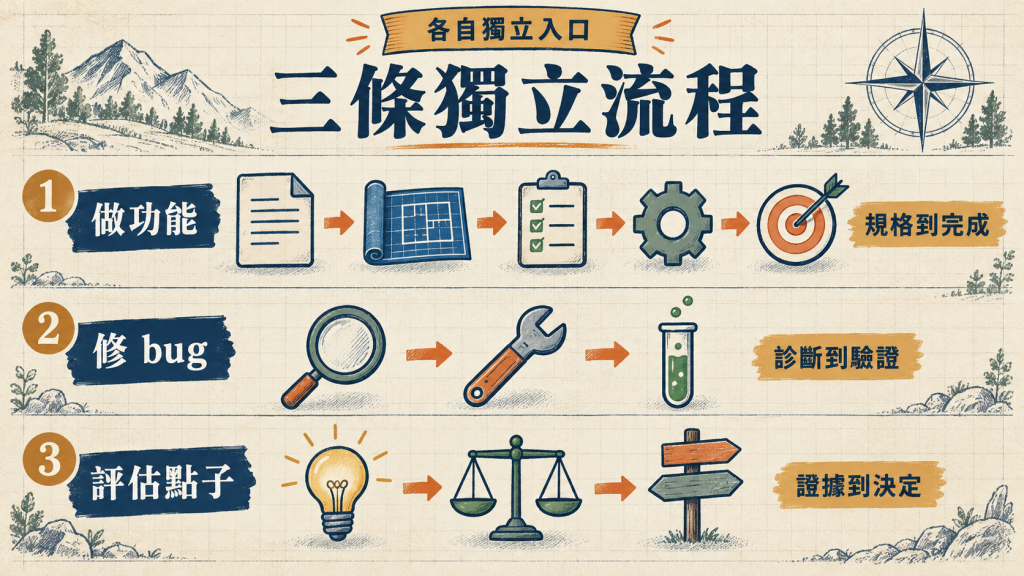
現在的 spec-kit 其實是三條互相獨立的流程:做功能用 specify → plan → tasks → implement → converge,修 bug 用 assess → fix → test,評估一個點子值不值得做則是 intake → research → define → shape → decide。今天只測第一條裡最前面、也是最常被提起的那一步——/speckit-specify。
/speckit-specify 的說明文件把「什麼時候該標記成需要澄清」寫得很精確:遇到不確定的地方,預設是「用產業慣例做合理假設,寫進 Assumptions 區塊」,只有在滿足「會大幅影響範圍或體驗」「有多種合理解讀而且後果不同」「沒有任何安全預設值可用」這幾個條件時,才會標上 [NEEDS CLARIFICATION],而且最多只給三條,優先順序是範圍 > 安全與隱私 > 使用者體驗 > 技術細節。這段話等於是它自己開出的考題——如果有一個情境真的符合「沒有安全預設值」,它理論上就該停下來問。
準備了一個已經有 Order 型別(含 refundedAmount 欄位)的小專案,要求加一個 refundOrder,處理已取消訂單的退款。這題刻意踩在它自己列的高風險類別上:退款金額要不要設核准門檻,是「安全與隱私」等級的決定,而且沒有哪個數字是放諸四海皆準的安全預設值——設高了擋不住異常退款,設低了每筆都要人工過,兩種錯法代價都不小。
分別跑了兩種條件:一邊直接要求「加這個函式」,一邊用 /speckit-specify 走正式流程。
/speckit-specify 跑完之後,spec.md 裡的 [NEEDS CLARIFICATION] 數量是零,品質檢查清單第一輪就全數通過,完成報告直接說「無需澄清標記」。它確實把一堆判斷寫進了 Assumptions 區塊——部分退款支援、金額以分為單位、「已取消但從未付款」的訂單同樣可退(並點名這是因為現有資料模型分辨不出來,建議之後再確認)——但核准門檻這件事,直接被歸進「授權與稽核紀錄不在此功能範圍內」一行,整個略過,連列進需要確認的假設都沒有。
沒套流程那邊,直接問要不要加核准門檻,答案更簡短:完全沒提。模型自己倒是主動列了三點「設計取捨」——支援部分退款、用拋例外處理錯誤、不新增退款狀態——這些跟 spec-kit 挑出來的假設有重疊,但核准門檻一樣是兩邊都沒人提的那個洞。
兩邊都沒有真的為了這題停下來問。差別在於:spec-kit 把七條假設寫進一份有固定格式、會被品質檢查清單逼著填的 Assumptions 區塊,其中包含付款狀態分不出來這種容易被忽略的資料模型缺口;沒套流程那邊,這類交代完全看模型當下想不想講,這次只講了三條,講得比較像隨手補充而不是義務申報。換句話說,[NEEDS CLARIFICATION] 這個聽起來像「會逼你停下來」的機制,在這次測試裡完全沒有發揮作用;真正在起作用的,是那份結構化、要求列出假設與範圍邊界的文件格式,把原本可能被略過的判斷逼著寫下來——只是「逼著寫下來」跟「逼著你回答」是兩件不同的事,前者這次做到了,後者沒有。
如果把 spec-kit 的賣點理解成「它會幫你攔住危險的模糊地帶」,這次測試不支持這個說法——至少在這個情境下,它跟一個謹慎的模型一樣,一樣會把高風險的決定悄悄做掉。但如果把它理解成「它會強迫把決定寫下來、放進一份固定格式、要經過品質檢查才能往下走的文件」,這次測試完全支持——而且這份文件確實比一次性的對話回覆更可能被後面的人重新打開來看。真正的安全網不是那個標記本身會不會跳出來,是這份 Assumptions 清單會不會真的有人在進 /speckit-plan 之前打開來讀一遍。流程做得再正式,沒人讀那份文件,跟沒有這個流程是一樣的結果。
這系列前面測過不少「它宣稱會做什麼」跟「它實際做了什麼」有落差的工具,但大多是「漏抓了什麼」。spec-kit 這次的落差不太一樣:它沒有漏抓,它老實寫下了大部分該寫的假設,只是最關鍵的那個沒有被它自己的規則判定為需要停下來問——規則本身留的彈性,剛好把最難的那個問題放了過去。
明天找下一個方向繼續測,候選清單還在累積。


 iThome鐵人賽
 看影片追技術