
這系列第 21 天,第一次測完全不寫程式的工具:SEO 稽核。claude-seo,作者 AgriciDaniel,MIT 授權,17,263 顆星。今天不只做 A/B 對照,而是完整拆解這個工具——裝了什麼、怎麼裝、哪些功能免費、實測長怎樣,最後告訴你怎麼拿它解決真的 SEO 問題。
多數「AI 寫 SEO 文章」工具賣的是生內容,claude-seo 不一樣:這是技術稽核與策略規劃工具,核心主張是「可證偽,不是宣傳」——每條建議都附第一性觀察、依賴關係,還有「這條建議錯了要怎麼知道」。官方 README 講得直白:多數工具給你「建議」,這個給你「證據+建議+建議錯了會怎樣」。
兩種人適合:接案 SEO 顧問,15 分鐘稽核加實際 0-100 分數,寫提案前先有東西可以拿出來;自己維運網站、部落格、電商的人,不想訂閱付費 SaaS,先把基本功做好。
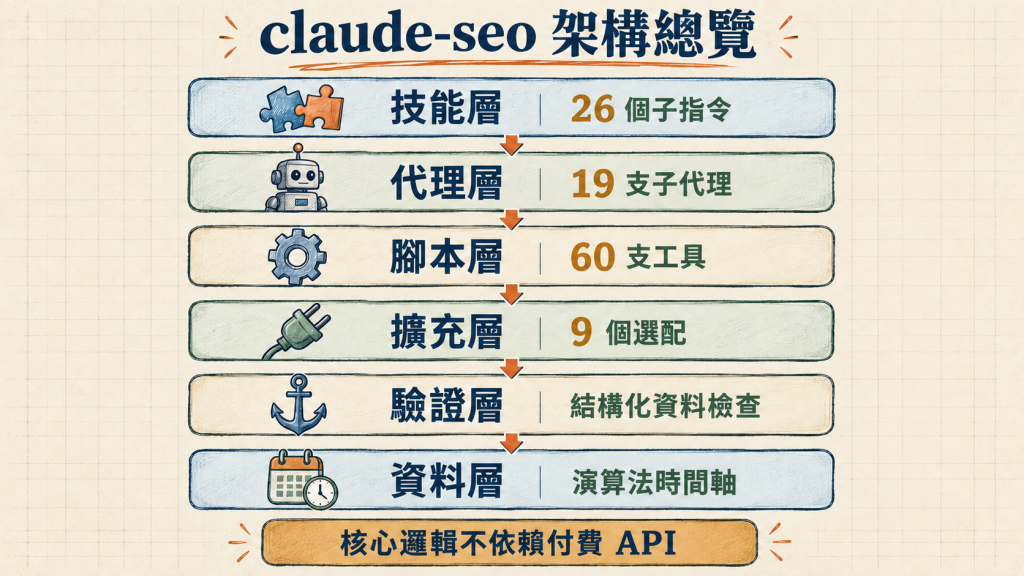
拆開這個 repo,結構分成幾層:
skills/:26 個子技能,每個對應一個 /seo <指令>,是整套工具的主要介面。agents/:19 支子代理定義檔,/seo audit 下去會同時派出最多 17 個子代理平行跑,站級稽核從原本要幾小時縮短到幾分鐘。scripts/:將近 60 支 Python 工具,做實際的抓取、渲染、驗證、算分,所有技能都透過統一的 scripts/claude-seo run <script>.py 呼叫,不是裸跑 Python。extensions/:9 個選配的 MCP 擴充(DataForSEO、Google、Banana/Gemini 生圖等),裝了才解鎖即時付費資料源,核心功能完全不需要它們。hooks/:一個驗證 JSON-LD 結構化資料格式的 hook。data/google-updates.json:內建的 Google 演算法更新時間軸,給稽核時比對用。這個分層設計值得注意的地方:26 個子技能裡,核心邏輯幾乎都不依賴付費 API——靠的是直接抓 HTML/HTTP、讀 Common Crawl 的公開資料、跑 Lighthouse 式的啟發式規則。真正需要額外帳號或花錢的,是想要「即時排名資料」「Google Search Console 欄位資料」「商用等級反向連結資料庫」這類進階功能,而且這些都是選配,不裝也不影響核心稽核能力。
安裝走 Claude Code 官方 marketplace,三行:
/plugin marketplace add AgriciDaniel/claude-seo
/plugin install claude-seo@agricidaniel-claude-seo
/seo setup
/seo setup 會建立獨立的 Python 執行環境、裝 Playwright 的 Chromium,跟系統 Python 完全隔開,不會弄髒全域套件或動到 PATH。
我自己卡在這一步:系統 python3 是 3.9.6,這外掛要求 3.10 以上,直接跑會失敗。改用環境變數指定直譯器才成功:
CLAUDE_SEO_PYTHON=/opt/homebrew/bin/python3.14 ... /seo setup
設定完用 /seo doctor 檢查環境,我這邊確認 ready: true、browser_ready: true。系統 Python 版本偏舊的話,先查版本再動手,別卡在這步就放棄。
把整個技能清單按「要不要額外付費」分三類,直接對應你的情境:
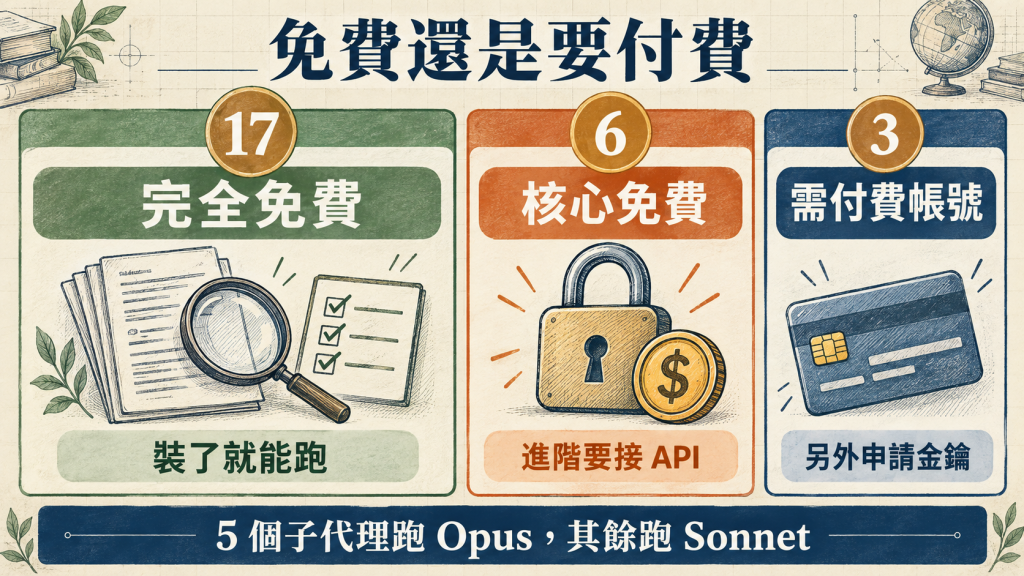
完全免費,裝了就能跑(純 HTML/HTTP 分析、Common Crawl、啟發式規則):
seo — 總入口seo-audit — 全站稽核seo-page — 單頁深度分析seo-technical — 技術稽核seo-content — E-E-A-T 內容品質seo-schema — 結構化資料seo-sitemap
seo-hreflang
seo-drift — 部署前後回歸偵測seo-agentic — AI agent 可讀性seo-geo — AI 搜尋引用力seo-competitor-pages
seo-content-brief
seo-cluster
seo-plan
seo-programmatic
seo-flow — 41 條證據導向提示詞庫核心免費,進階功能要額外接:
seo-images — alt text/效能免費,圖片排名要 DataForSEOseo-local — NAP 一致性免費,即時 GBP 資料要 APIseo-ecommerce — 商品 schema 免費,即時 Shopping 資料要 APIseo-maps — 三層:免費用 Overpass+Geoapify,付費層接 DataForSEO 或 Google Maps APIseo-backlinks — Common Crawl 免費層,商用等級資料庫是付費層;注意 Common Crawl 爬取週期可能長達數月,資料不夠即時seo-sxo — 預設用內建 WebSearch 當 fallback,精準度較低;接 DataForSEO 能換成即時 SERP 資料需要帳號或付費:
seo-google — 要 Google Cloud 專案 + API key,但有免費額度seo-dataforseo — 要裝付費的 DataForSEO extension,提供 79 個以上的 MCP 工具seo-image-gen — 要裝 Banana/Gemini extension一個成本提醒:seo-content、seo-geo、seo-sxo、seo-cluster、seo-drift 這 5 個子代理預設跑 Opus,其餘 13 個跑 Sonnet——這是官方文件自己寫的(README.md requirements 段)。跑一次完整的 /seo audit,成本不只是「這個工具免不免費」,還有 Claude 本身的 token 成本,評估划不划算時別漏算。
/seo technical 稽核一個真的網站說明文件讀再多,不如實際跑一次。我搭了一個小測試部落格:一個首頁、一篇文章、robots.txt 裡寫了「擋掉 GPTBot」,想看這個工具能不能看出這樣設定夠不夠。指令很簡單:
/seo technical http://localhost:8921/
幾分鐘後,交回來一份 40/100 分的稽核報告,而且存成了一份完整的 Markdown 檔案留存。先看最核心的部分——AI 爬蟲設定判斷:
只擋 GPTBot 不夠。你的 robots.txt 語法正確,但只擋了 OpenAI 的訓練爬蟲。其他 14 個 AI UA 全部被
User-agent: *的Allow: /放行,包括 OAI-SearchBot、ChatGPT-User、ClaudeBot、CCBot、Google-Extended、Meta-ExternalAgent、Bytespider。
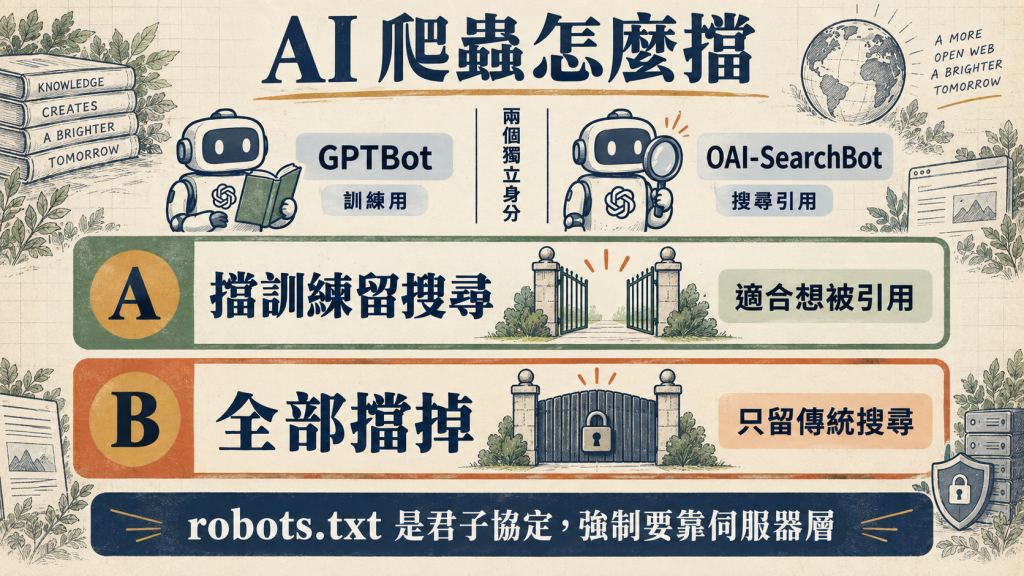
這個判斷是對的——GPTBot 只管 OpenAI 的模型訓練,OAI-SearchBot 才是決定 ChatGPT 搜尋會不會引用你內容的那個,兩者是完全獨立的 UA token,擋一個不會連帶擋另一個。報告附了一張完整的 15 列 AI 爬蟲表格,每一列寫清楚用途、目前有沒有被擋、以及有什麼需要注意的地方(例如「擋 Google-Extended 不影響 Google 搜尋排名」「ChatGPT-User、Perplexity-User 這類使用者觸發型爬蟲不一定遵守 robots.txt」)。
更值得留意的是它怎麼驗證「robots.txt 擋不擋得住」這件事——不是憑常識講一句「robots.txt 只是君子協定」就交差,是真的對著我的測試伺服器打了 curl -A GPTBot / 和 curl -A ClaudeBot /,兩次都回 200,然後才下結論:伺服器本身沒有做 UA 過濾,robots.txt 的效力完全建立在爬蟲自願遵守上,想要真的擋住就得在 CDN 或 nginx 層加規則。
報告最後直接給了兩份可以複製貼上的 robots.txt 範本。方案 A(只擋訓練、保留搜尋引用,適合希望被 AI 搜尋引用的部落格):
# AI 訓練爬蟲:禁止
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: anthropic-ai
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Bytespider
User-agent: Meta-ExternalAgent
User-agent: Amazonbot
Disallow: /

# AI 搜尋與使用者觸發:允許
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Allow: /

User-agent: *
Allow: /

Sitemap: https://<你的網域>/sitemap.xml
**方案 B(連 AI 搜尋引用也一起擋,只保留傳統搜尋引擎):**把上面方案 A 裡「允許」區塊的六個 UA(OAI-SearchBot、ChatGPT-User、Claude-SearchBot、Claude-User、PerplexityBot、Perplexity-User)整組移進「禁止」區塊,其餘不變。報告特別提醒:Googlebot、Bingbot 沒被列入這份清單,傳統搜尋不受影響,但 Bing 的資料會餵給部分 AI 產品,沒辦法單靠 robots.txt 完全隔離——這種「規則表面上看起來乾淨、實際上還是有滲透路徑」的細節,正是這類技術文件容易漏掉的地方。
完整的扣分明細也值得看一眼,示範了「量化分數」怎麼做到有憑有據,不是隨便估一個數字:缺 sitemap 扣 8 分、唯一的內部連結 404 扣 15 分、canonical 指向錯誤網域扣 5 分、缺 viewport 扣 6 分、缺 Open Graph/Twitter Card 扣 4 分、缺 JSON-LD 扣 4 分、缺安全標頭(CSP、X-Content-Type-Options、Referrer-Policy 這類)扣 5 分、缺 Cache-Control/壓縮扣 3 分、用預設 404 頁扣 2 分、AI 爬蟲覆蓋不足扣 8 分,總共扣 60 分,從 100 分變成 40 分。報告也老實註明:如果扣掉「純粹是本機開發伺服器造成、上線後會自動消失」的那幾項,內容層面的分數大概落在 60 分,提醒我上線後要重測一次才準。
這次稽核還意外抓到一個我自己沒注意到的真實 bug:首頁唯一的內部連結指向 /posts/architecture-notes,但伺服器上的檔案其實是 architecture-notes.html,連結少了副檔名,實測回應是 404。這不是我刻意埋的測試題,是搭測試頁面時手滑留下的真實疏漏——反而成了「這個工具真的有去點、去抓,不是憑空生成」的額外證明。報告裡的每一條問題後面都附著實際跑出來的 curl 指令與回應碼,不是空泛的「建議檢查一下」。
為了公平起見,我也在完全沒裝這個技能的情況下,請 Claude 用自己既有的知識對同一個網站做了一次一樣的稽核。結果老實說:基礎判斷幾乎一樣準——一樣正確分辨出 GPTBot 跟 OAI-SearchBot 是兩回事,一樣抓到 404 連結、缺 sitemap、canonical 指向錯誤網域這幾個問題。這說明現在的模型本身對 SEO 知識的掌握已經不差,不是裝了這個技能才「從不會變會」。
真正的差別在於交付的東西。沒裝技能那次,翻對話紀錄只看到三個單純的 curl 呼叫(抓 robots.txt、抓首頁、驗證那個 404 連結),「robots.txt 只是君子協定」這個結論是用既有知識直接斷言的,沒有真的用不同的 User-Agent 去打一次這台伺服器驗證;裝了技能那次,則是真的另外跑了 curl -A GPTBot 和 curl -A ClaudeBot 兩次,拿這台伺服器自己的實測結果去支撐同一個結論。裝了技能的版本還多做了三件事:給出一個可以拿來逐次追蹤進步的量化分數(40/100,附完整扣分明細)、生出兩份可以直接複製貼上的 robots.txt 範本而不是要你自己再組一次、以及把整份報告存成檔案方便之後比對。換句話說,這個技能補的不是「知不知道」,是「有沒有多做一步去證實」跟「產出的東西能不能直接拿去用」。
如果你自己維運部落格、Threads、newsletter 或個人品牌網站,這幾個情境可以直接對應到指令:
/seo technical <url>,今天示範的就是這個。/seo page <url>,門檻最低,輸入一個網址就有完整輸出。/seo geo <url>,這是這個工具標榜的「GEO 時代 SEO」賣點,技術部落格、知識型內容特別適合關心這塊。/seo content-brief <主題>,會給逐段字數、關鍵字密度指引。/seo schema <url>,規則明確,錯了就是錯了,很適合拿來核對。/seo audit <url>,會自動派發適用的子技能(也包含前面列的免費技能),並誠實在報告裡標出哪些需要額外資料源(DataForSEO、Google API)的部分沒有資料可用,不會假裝有查到。/seo drift,概念上像是「SEO 版的 git diff」,先建一個基準點,之後再跑就會告訴你哪裡變差了,很適合接在發文或改版流程的最後一步。/seo cluster,用語意相似度把關鍵字分群、規劃 hub-and-spoke 式的內容架構,對經營個人品牌網站、長期寫作的人特別有用——先有架構,比想到哪寫到哪更不容易留下內容空缺。實際使用時,一個合理的節奏是:平常寫新文章前先跑一次 /seo content-brief,發布後用 /seo page 快速檢查這一篇,累積到一定篇數後跑一次 /seo audit 抓全站層級的問題,改完東西之後用 /seo drift 確認沒有不小心讓分數倒退——不需要每天都跑全套,依照實際發文節奏安排就好。
seo-backlinks 免費層靠的是 Common Crawl,爬取週期可能長達數月,拿到的反向連結數字可能不夠新。seo-cluster、seo-sxo、seo-content-brief 這類沒接 DataForSEO 時會退回用內建的 WebSearch,工具自己也會在輸出裡誠實標註「精確度降低」,不是悄悄用比較差的資料充數。localhost 這類非公開網址也有限制——sitemap_discovery.py 會直接拒絕非公開的 HTTP/HTTPS 網址,今天只能繞過去用 curl 手動驗證,真正要測完整功能(Core Web Vitals、HTTPS 檢查)還是得對著真實上線的網域跑。這系列前面二十天測的幾乎都是寫程式相關的技能,今天第一次踏進完全不同的領域,也剛好驗證了同一件事可以換不同形式重演:基礎判斷力,模型自己已經不差;工具真正加的分,是「有沒有多驗一次」「產出的東西能不能直接拿去用」。這個結論跟前面測 ui-test、grill-with-docs 時看到的模式是一致的——差別不在懂不懂,在有沒有把懂的東西,做成一份真的可以照著做的交付物。
明天想找一個完全不同的方向繼續測,這系列的候選清單還在累積。


 iThome鐵人賽
 看影片追技術