
假設同事跟你說:「剛剛網站很慢,送出一直轉圈圈。」
你打開網站,卻發現現在很正常。那要回答他剛剛發生什麼事,總不能只說「可是我這裡可以啊」XD
這時候我們得回去找紀錄,也就會用到今天的 CloudWatch。它裡面有 Metrics、Logs 好幾個入口,先用這個問題來看:那時候主機有多忙?程式又留下什麼事件?
看這張圖,左邊是 CPU 隨時間變化,右邊是程式留下的事件。圖中的數字與錯誤都是示意,不是某台主機的實測結果
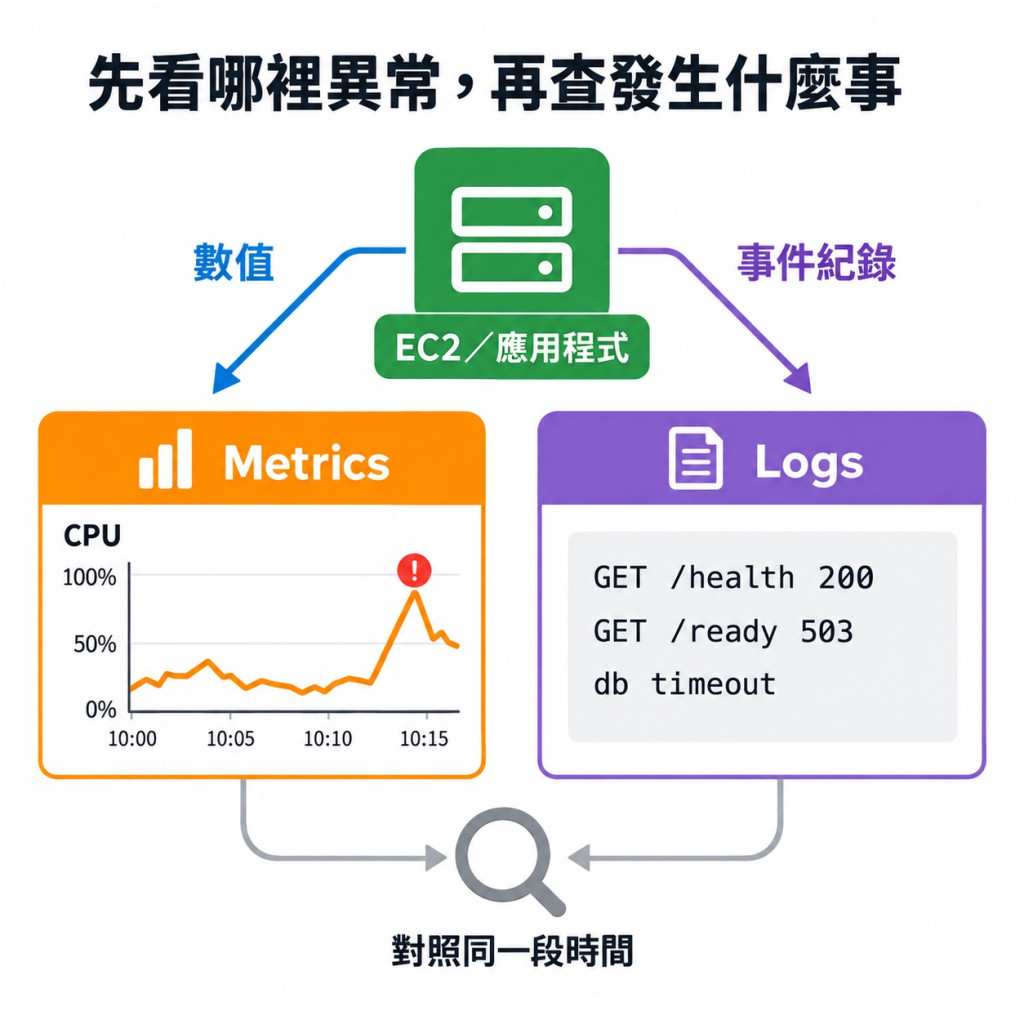
左邊這類數值叫 Metrics(指標),右邊程式留下的事件則是 Logs(紀錄)
假設同事說的是下午兩點,我們就把兩邊都切到那段時間。CPU 有沒有升高?程式有沒有 DB timeout,也就是等資料庫回應等到逾時?先把時間對起來,才不會拿現在很低的 CPU,回答兩小時前的問題
CPU 高也還沒告訴我們是哪支 API 出錯,看到 timeout 也不能直接下結論要升級 EC2。這兩種資料要放在一起看
EC2 有原生的 CPU、網路流量與狀態檢查等指標。基本監控下,像 CPUUtilization 通常是五分鐘一筆
詳細監控可提高到一分鐘,不過費用也要一起考慮(欸,附上(EC2 監控資料)
但你不會因此直接看到 Linux 記憶體使用率、檔案系統用了百分之多少。這些作業系統裡的資料,需要另外收集,例如安裝 CloudWatch Agent。今天先看 EC2 已經提供的指標,還不用另外安裝 Agent
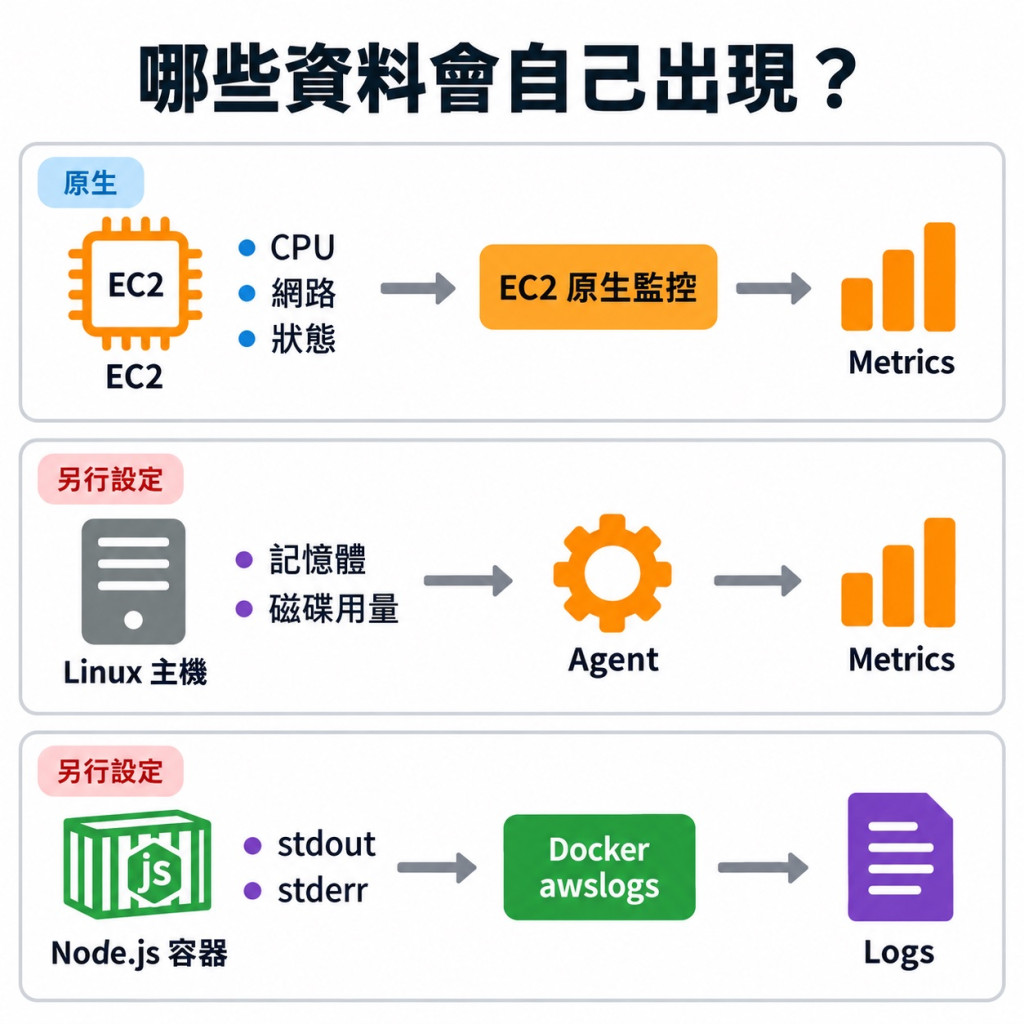
所以如果你在 CloudWatch 找不到記憶體使用率,先別急著重建圖表,要先問這份資料有沒有送進來。下面把三種來源畫在一起,等下我們要做的是最下面那條 Docker → Logs
到 CloudWatch → Metrics → Classic metrics → EC2 → Per-Instance Metrics,找到自己的 InstanceId,勾選 CPUUtilization。新版把側欄入口改叫 Classic metrics,進去後再從 Browse 選指標
先選最近一小時、統計方式 Average、Period 五分鐘。Period 是每個統計區間的長度
這裡就是把每五分鐘的 CPU 使用情況整理成一個平均值。時間範圍內要有主機執行的資料
Stop 很久的主機,最近一小時空白不代表 CPU 是 0,也不代表 CloudWatch 壞掉
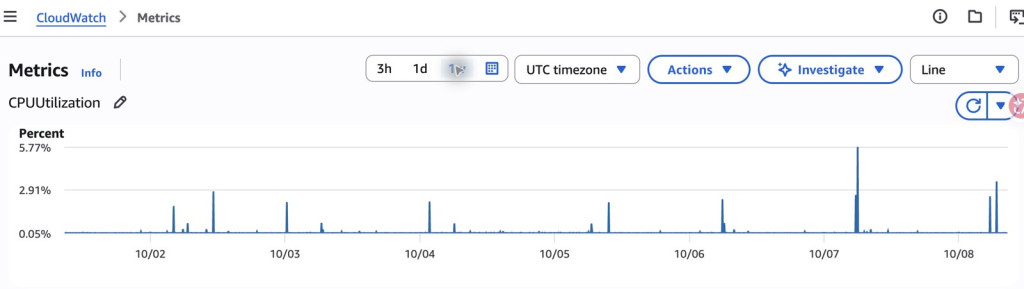
下面是這次在東京區打開的 CPU 歷史圖表,時間選 1w,把一週的變化放在一起看。橫軸是時間,縱軸是 CPU 百分比。有一小段凸起,也不等於網站當時壞掉,還要對照那段時間的紀錄
選圖表時留意三件事:
可以再加上 NetworkIn、NetworkOut 與 StatusCheckFailed,存成一個小型 Dashboard,也就是把這幾張圖放在同一頁的監控看板,方便下次回來看。但這些都正常,也不能保證會員登入、寄信與資料庫操作全部正常,因為那是應用程式的工作
不會哩。console.log 寫出的正常輸出叫 stdout,console.error 寫出的錯誤輸出叫 stderr,這個 Docker 可以收集到,所以你在主機上看得到 docker compose logs。如果要進 CloudWatch 的話,還要安排一個把紀錄送過去的方法
如果是 Docker Container,我們使用 Docker 內建的 awslogs logging driver,讓 Docker 把這個服務的輸出送到 CloudWatch Logs。這和另外安裝 Agent 收主機檔案,是不同做法,附上(Docker awslogs 設定)
先用有管理權限的身分,到東京區 CloudWatch → Logs → Log Management → Log groups → Create log group,建立 /practice/demo-api,Retention setting 選 1 week (7 days),Log class 維持 Standard
建立時就把保存天數選好,避免練習紀錄一直累積。下面是這兩個欄位的實際畫面,截圖部分是停在提交前

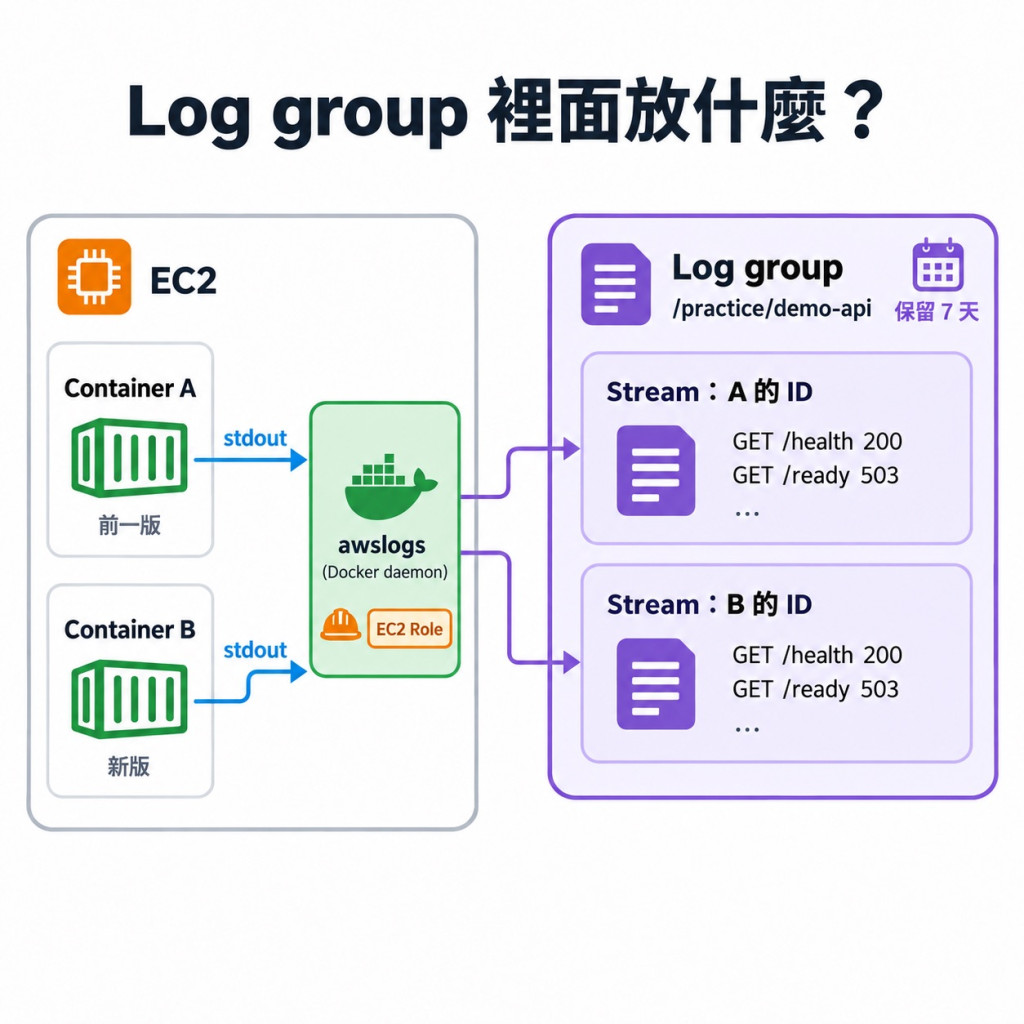
Log group 是同一類紀錄放的位置,裡面的 Log stream 則分開保存不同來源的事件。這次沿用 Container ID 作為 stream,換了 Container 就能分開看
在 AWS 網頁 → IAM → Policies → Create policy → JSON,貼上下方內容,YOUR_ACCOUNT_ID 換成自己的帳號 ID,例如命名 DemoApiWriteLogs 後建立
接著到 EC2 → Instances → 選正在跑 API 的主機 → Security → IAM role,點進這台主機實際掛上的 Role。在 Permissions → Add permissions → Attach policies 搜尋並附加 DemoApiWriteLogs。
然後沿用前面 pull ECR 的 Role
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Action": ["logs:CreateLogStream", "logs:PutLogEvents"],
    "Resource": "arn:aws:logs:ap-northeast-1:YOUR_ACCOUNT_ID:log-group:/practice/demo-api:log-stream:*"
  }]
}
只讓它建立這個群組下的 stream 與寫入事件。Log group 已由管理者建好,所以主機不必拿建立任意 log group 的權限,也附上(CloudWatch Logs 權限)
而送紀錄的是 EC2 上的 Docker daemon,也就是在主機背景運作、管理容器的 Docker 程式,它使用主機的 Role。不要為了送 Logs 再把一組 Access Key 塞進 Container。這部分也要確認主機能對外連到東京 CloudWatch Logs 服務
我們切到 SSH 登入 EC2 的 deployer 視窗,執行 cd ~/demo-api-deploy,先用 cp compose.yaml compose.before-awslogs.yaml 備份,再用 nano compose.yaml 開檔下。在 api 服務內,將原本 driver: local 那一整段 logging 改成下面這段。其他 Image、port、資料庫設定都保留,不要把整個 services 區塊蓋掉:
services:
  api:
    # 保留這裡原有的 image、ports、env_file、volumes 等設定
    logging:
      driver: awslogs
      options:
        awslogs-region: ap-northeast-1
        awslogs-group: /practice/demo-api
我們沒有指定固定 stream,Docker 會使用 Container ID;也沒有啟用自動建立 group,名稱填錯會報錯,不會悄悄多建一個
下面要改的是自己電腦的程式碼。打開 demo-api/server.cjs,在 http.createServer(async (req, res) => { 下一行加入這段;若沿用還沒接資料庫的版本,則放在 http.createServer((req, res) => { 下一行:
res.on('finish', () => {
  console.log(JSON.stringify({
    time: new Date().toISOString(),
    method: req.method,
    path: req.url.split('?')[0],
    status: res.statusCode
  }));
});
finish 表示伺服器已完成這次回應的輸出,這時記錄方法、路徑和狀態碼。例如剛剛測的 /health,正常應留下 GET、/health、200
存檔後,照 ECR 篇重新登入、build、push 未用過的 Tag,例如 v3
回 EC2 修改 Compose 的 image 成同一版,再往下重建。只在自己電腦改 console.log,雲端的舊容器不會跟著更新
這只是這個小範例的請求摘要,不記錄網址 ? 後面的 query、Cookie、Authorization 或整包 body。實際網站若把個資放在路徑,也要遮罩或改記路由樣板,不能原樣收進 Logs
回到 EC2 的 deployer 視窗,在 ~/demo-api-deploy 執行。假如 ECR 登入 Token 已過期,先照 Day23 用主機 Role 重新登入,再 pull:
docker compose config --quiet
docker compose pull
docker compose up -d --force-recreate
curl -i http://127.0.0.1:8080/health
logging driver 要套用到新建的 Container,所以會重建服務,練習時會有短暫中斷。回 CloudWatch 的 /practice/demo-api,打開最新 stream,找剛剛時間的 /health 與 200
如果沒看到,先查 Container 是否成功啟動、Role 是否允許寫入、Region 與 group 名稱是否一致,再確認程式真的有輸出~
Logs 會有收集與保存費用,Dashboard、其他監控項目也有各自的計價,所以今天先收必要事件,並設定七天保留,也附上(CloudWatch 計價)
到這裡,至少有地方能回頭查「剛剛怎麼了」
接著你可能會想,雖然數據有了,但他會主動回報嗎?
下一篇我們就來加上 Alarm 和通知,讓條件持續發生時主動寄信,不用整天盯著這張圖哩,我們明天見 :D


 iThome鐵人賽
 看影片追技術