
Mini Hermes 是我們透過 Claude Fable 5 輔助開發,蒸餾出 Hermes Agent 的必要功能,接著用 LangChain Deep Agents 重構出一套適合地端小模型的實驗性框架。
以下逐項分享:
怎麼蒸餾:挑了哪些機制、為什麼調整成開發框架
整包程式碼架構總覽
實測 demo
核心原則:不是「把 Hermes Agent 的原始碼整包搬過來改一改」。
真的這樣做,得到的東西對地端小模型來說會太過笨重:skill / 工具龐雜,小模型光是搞懂「這一堆工具裡該用哪一個」就先亂了。所以做法反過來:只參考 Hermes Agent 架構裡最核心的幾層機制,先想清楚打造地端小模型 harness 的「第一性原理」,接著生成最小化必要的版本。
最後挑出來的六個關鍵功能是:
- Channel(通訊管道)
- Memory(長期記憶)
- Planning and Execution(規劃與執行)
- Review(背景學習)
- Skill / Tool using(技能與工具)
- Command(對話指令)
之後也陸續針對這六個功能各自都做了「瘦身」,背後其實都是同樣的原因:小模型記性差、容易在工具呼叫上打轉、容易被複雜 schema 搞混,所以每一項都要用功能輕量化補小模型的短板,而不是要求模型自律。
首先請 Claude Fable 5 協助理解 Hermes Agent 關鍵功能的原始碼: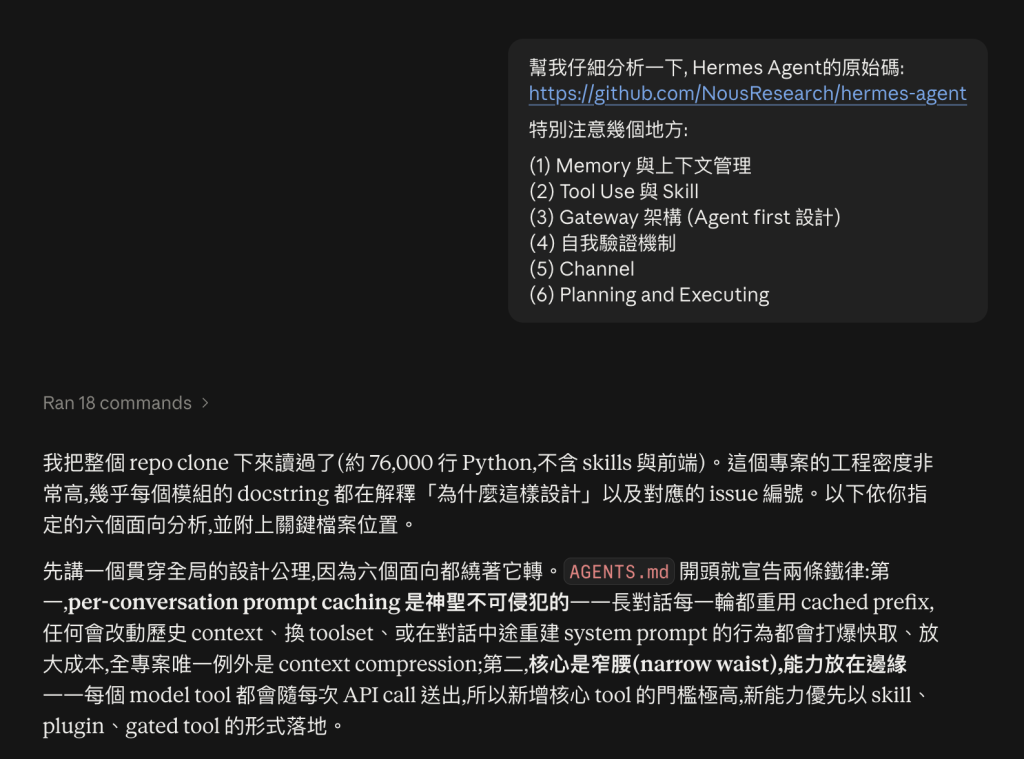
經過多輪提問蒸餾出精簡功能後,也陸續做了兩個定位上的調整。
選 Deep Agents 的理由很單純:開發上有共同標準可以 follow。Deep Agents 已經內建了 planning(write_todos)、檔案系統 backend、sub-agent 委派、progressive disclosure 的 skill 系統這些基礎建設,不用自己重造輪子,不同團隊接手時也有一套業界標準的模式可以套用。
以下是請 Claude Fable 5 進行重構的初步提問: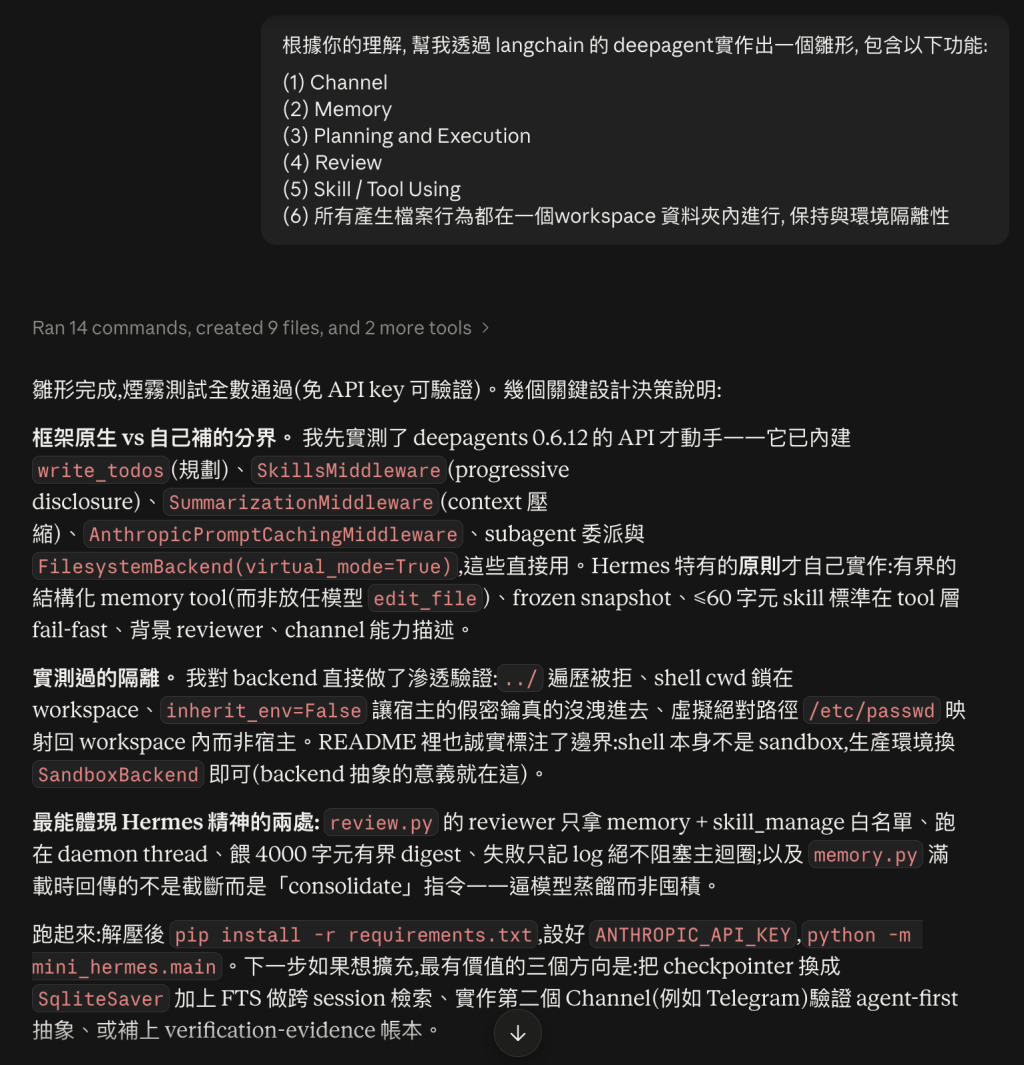
目標不是做出一個「萬能的 agent」,而是做出一個「利於複用與開發」的 agent 框架,所以程式碼刻意分成 core/(底層 harness)跟 customize/(你加的東西:工具、workflow、垂直應用)。
以下是請 Claude Fable 5 協助轉為通用開發框架的初步提問: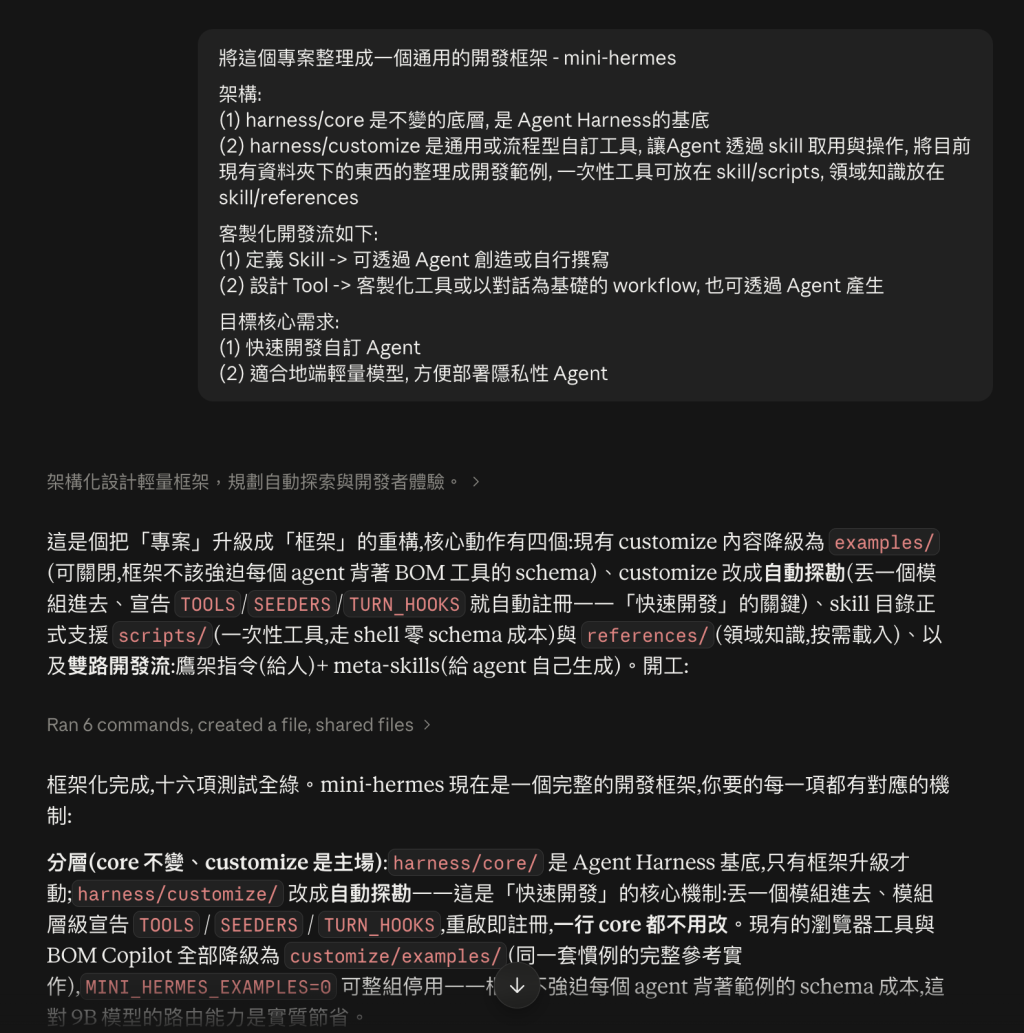
/harness 分為 /core 核心功能與 /customize 自訂功能:
core/        框架本體:穩定,一般不需要修改
customize/   你加的東西:工具、workflow、垂直應用都放這裡
main.py      主程式:選 channel、跑主迴圈
core/ 提供的是「核心功能」:Channel、記憶、技能使用、文件讀取、圖片讀取等基礎底層功能。customize/ 則是非核心的客製化功能(自訂工具)。實際檔案結構:
mini_hermes/
├── main.py                 # serve/run_turn:整個對話回合的主迴圈
├── scaffold.py             # 產生新 tool/workflow 骨架的小工具
└── harness/
    ├── core/
    │   ├── workspace.py     # 檔案系統邊界(虛擬目錄、逃逸防護)
    │   ├── channels.py      # 通訊管道:CLI / Telegram / HTTP API
    │   ├── agent.py         # build_agent:組裝 model + tools + checkpointer
    │   ├── brakes.py        # TurnBrake:每回合呼叫次數煞車
    │   ├── turn_context.py  # 回合範圍的 session 狀態、待交付檔案佇列
    │   ├── memory.py        # MEMORY.md / USER.md
    │   ├── skills.py        # skill_manage 工具、預設 skill 播種
    │   ├── store.py         # DB 持久化 + 跨對話搜尋
    │   ├── documents.py     # 上傳檔轉換:xlsx → CSV、PDF → 文字、圖片 → 描述
    │   ├── vision.py        # 看圖引擎:圖片 → 文字描述(另一顆多模態模型)
    │   ├── review.py        # 回合後背景學習迴圈
    │   └── trace.py         # 每回合一行 JSONL 除錯紀錄
    └── customize/
        ├── __init__.py
        ├── vision_tools.py         # look_at_image:圖片追問
        ├── stagehand_browser.py    # 自然語言瀏覽器操作
        └── examples/               # 範例
customize/ 底下的每個客製化功能,會在啟動時被框架底層掃描,確認以下四個變數是否存在:
TOOLS = [...]          # 掛進 agent 的工具清單
SEEDERS = [...]        # build_agent 時執行一次(通常用來寫入預設 SKILL.md)
TURN_HOOKS = [...]     # 每個使用者回合開始時執行(重置回合內狀態)
SESSION_HOOKS = [...]  # /new /start 清空 session 時執行(清外部化狀態)
新增一個自訂工具、寫好這幾個變數,重啟就自動生效。
1. channel.receive()   收訊、白名單檢查
2. main.py 指令攔截     /status 這類指令直接回覆,不進模型
3. run_turn()          TURN_HOOKS 重置 → agent.stream() 開跑
4. 串流中               工具呼叫 → send_status();token → send_stream()
5. 回合結束             用量估算/自動壓縮、待交付檔案送出、trace 記錄
6. channel.receive()   再次被呼叫,代表上一輪完全定案
以下分享幾個實際運行的實測 demo。
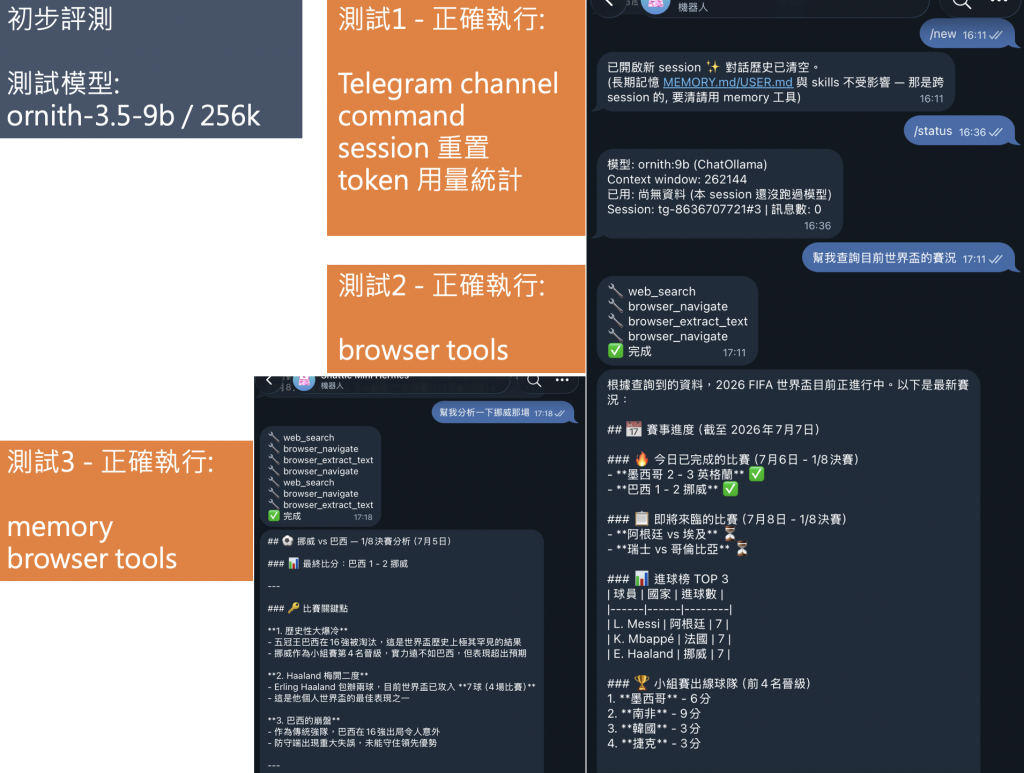
測試模型是地端的 ornith-1.5:9b(256k context window),這裡先做了兩個基本功能檢查:/new 正確重置 session、/status 正確回報模型與 context window 長度(262144,訊息數 0),接著丟一個需要真的上網查資料的問題:「幫我查詢目前世界盃的賽況」。
Telegram 上可以看到完整的工具歷程:
🔧 web_search
🔧 browser_navigate
🔧 browser_extract_text
🔧 browser_navigate
✅ 完成
回覆是一份整理過的賽況摘要,包含已完成賽事比分、即將開打的賽程、進球榜 TOP 3、小組賽出線名單,格式是清楚的 Markdown 表格與清單。
追問「幫我分析一下挪威那場」,又跑了一輪 web_search → browser_navigate → browser_extract_text → browser_navigate → web_search → browser_navigate → browser_extract_text,回來一份有標題、比分、三個關鍵點分析的完整報告。
一輪查詢的完整流程大致是:
使用者提問
  → web_search(關鍵字)           多引擎依序嘗試,單一引擎失敗只 continue
  → browser_navigate(url)       導航 + 回傳標題與開頭摘錄(省一次來回)
  → browser_extract_text()      抓整頁文字,內容雜湊沒變就不重複灌入
  →(視需要)再一輪 navigate/extract
  → 每次工具呼叫都先過 TurnBrake.check(),累積到上限就被強制喊停
mini_hermes/harness/
├── core/
└── customize/
    └── examples/
        └── custom_tools.py      # 自訂瀏覽器工具

workspace/skills/
└── playwright/SKILL.md          # Playwright MCP skill
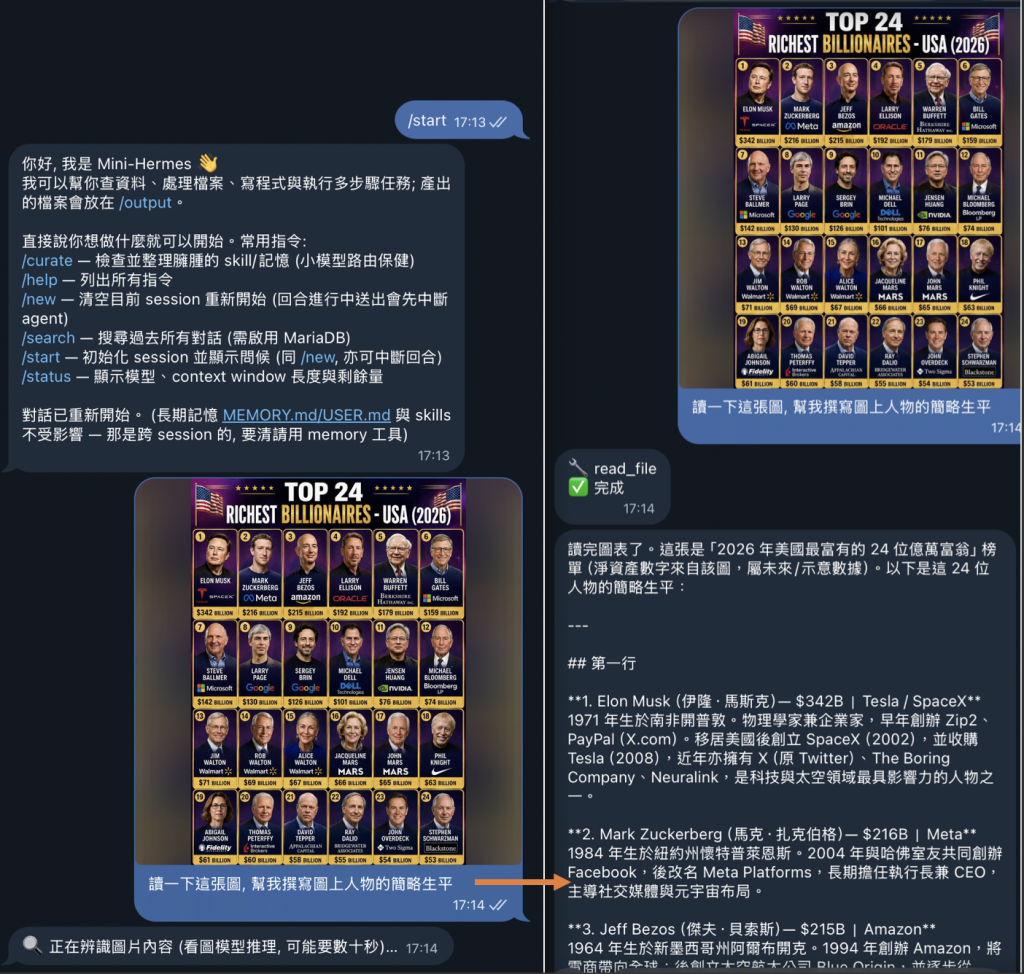
先用 /start 重置 session,看到問候語跟指令清單(/curate /help /new /search /start /status)。接著上傳一張「2026 美國最富有 24 位億萬富翁」的資訊圖,並附文字「讀一下這張圖,幫我撰寫圖上人物的簡略生平」。
上傳的瞬間,聊天室先跳出一則過場訊息:
🔍 正在辨識圖片內容(看圖模型推理,可能要數十秒)…
接著工具歷程只有一次 read_file 呼叫,✅ 完成,然後就是一篇完整、按圖上排列順序(從「第一行」開始)逐一寫出 24 位人物簡略生平的回覆。
圖片閱讀流程如下:
使用者傳圖(Telegram photo 欄位)
  → _ack_ingest():先送「📥 收到圖片,處理中…」並開始 typing
  → 下載到 workspace/uploads/
  → ingest_image():
       ├ Pillow 縮圖
       ├ 呼叫看圖模型
       ├ 描述落盤 <原檔>.vision.txt
       └ 回傳「已用看圖模型看過這張圖」+ 描述前 1500 字 + 完整檔案路徑
  → 這段說明內嵌進當回合的訊息,主模型(地端 9B 文字模型)當回合就「看得到」內容
  → 使用者要求「撰寫 24 人簡略生平」,1500 字的內嵌摘要不夠寫完整份
  → 模型呼叫 read_file,直接讀完整的 .vision.txt 內容,補齊剩下的細節
mini_hermes/harness/core/
├── vision.py         # 看圖引擎
├── documents.py      # ingest_file 的圖片路由分支
└── channels.py       # Telegram 處理

mini_hermes/harness/customize/
└── vision_tools.py   # look_at_image 工具
這個 demo 是刻意用來示範「怎麼用這個框架長出一個真正垂直應用」的案例,對應到自訂的 bom-copilot skill 跟 bom_workflow 工具。主要有兩個操作情境:
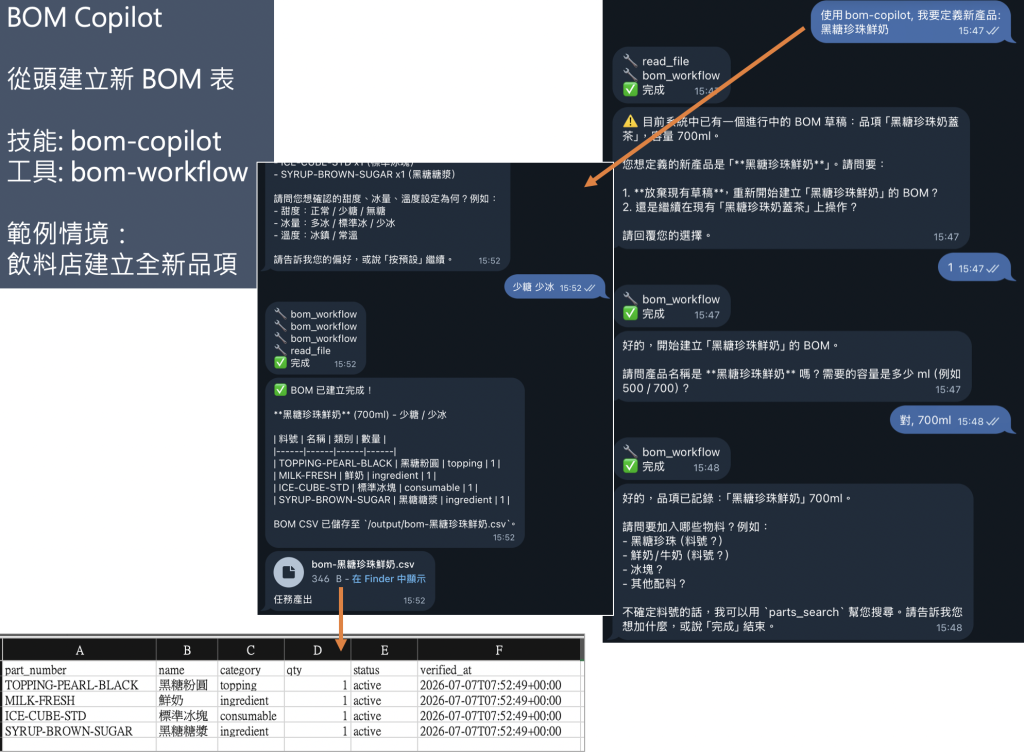
使用者:使用 bom-copilot,我要定義新產品:黑糖珍珠鮮奶
🔧 read_file / bom_workflow ✅完成
Agent:⚠️ 目前系統中已有一個進行中的 BOM 草稿:品項「黑糖珍珠奶蓋茶」,容量 700ml。
       您想定義的新產品是「黑糖珍珠鮮奶」。請問要:
       1. 放棄現有草稿,重新開始建立「黑糖珍珠鮮奶」的 BOM?
       2. 還是繼續在現有「黑糖珍珠奶蓋茶」上操作?

使用者:1
Agent:好的,開始建立「黑糖珍珠鮮奶」的 BOM。請問產品名稱是黑糖珍珠鮮奶嗎?
       需要的容量是多少 ml(例如 500/700)?

使用者:對,700ml
Agent:好的,品項已記錄:「黑糖珍珠鮮奶」700ml。請問要加入哪些物料?例如:
       - 黑糖珍珠(料號?)/ 鮮奶/牛奶(料號?)/ 冰塊?/ 其他配料?
       不確定料號的話,我可以用 parts_search 幫您搜尋。

(...加料過程省略...)

Agent:請問您想確認的甜度、冰量、溫度設定為何?
使用者:少糖 少冰
🔧 bom_workflow ×3 / read_file ✅完成
Agent:✅ BOM 已建立完成!
       黑糖珍珠鮮奶(700ml)- 少糖/少冰
       | 料號                | 名稱     | 類別       | 數量 |
       | TOPPING-PEARL-BLACK | 黑糖粉圓 | topping    | 1    |
       | MILK-FRESH          | 鮮奶     | ingredient | 1    |
       | ICE-CUBE-STD        | 標準冰塊 | consumable | 1    |
       | SYRUP-BROWN-SUGAR   | 黑糖糖漿 | ingredient | 1    |
       BOM CSV 已儲存至 /output/bom-黑糖珍珠鮮奶.csv。
       📎 bom-黑糖珍珠鮮奶.csv(346 B)
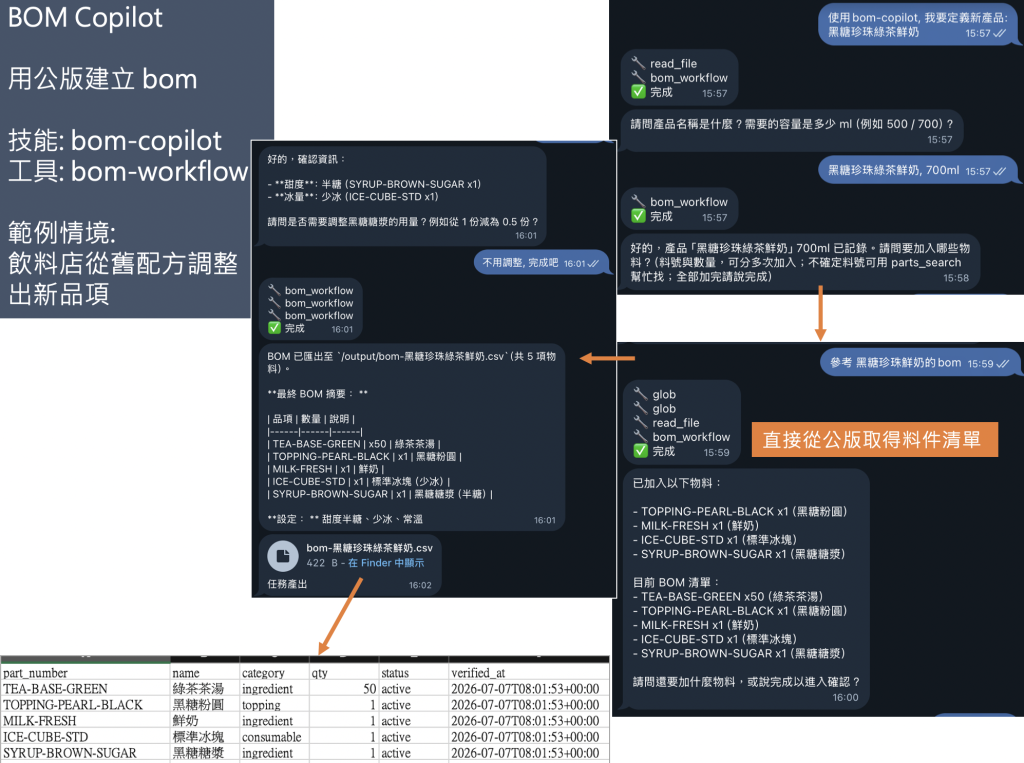
使用者:使用 bom-copilot,我要定義新產品:黑糖珍珠綠茶鮮奶
Agent:請問產品名稱是什麼?需要的容量是多少 ml(例如 500/700)?
使用者:黑糖珍珠綠茶鮮奶,700ml
Agent:好的,產品「黑糖珍珠綠茶鮮奶」700ml 已記錄。請問要加入哪些物料?

使用者:參考 黑糖珍珠鮮奶的bom
🔧 glob / glob / read_file / bom_workflow ✅完成
Agent:已加入以下物料:
       - TOPPING-PEARL-BLACK x1(黑糖粉圓)/ MILK-FRESH x1(鮮奶)
       - ICE-CUBE-STD x1(標準冰塊)/ SYRUP-BROWN-SUGAR x1(黑糖糖漿)
       目前 BOM 清單(已自動補上綠茶基底):
       - TEA-BASE-GREEN x50(綠茶茶湯)
       - TOPPING-PEARL-BLACK x1 / MILK-FRESH x1 / ICE-CUBE-STD x1 / SYRUP-BROWN-SUGAR x1
       請問還要加什麼物料,或說完成以進入確認?

Agent:好的,確認資訊:甜度半糖(SYRUP-BROWN-SUGAR x1)、冰量少冰(ICE-CUBE-STD x1)。
       請問是否需要調整黑糖糖漿的用量?
使用者:不用調整,完成吧
🔧 bom_workflow ×3 ✅完成
Agent:BOM 已匯出至 /output/bom-黑糖珍珠綠茶鮮奶.csv(共 5 項物料)。
       設定:甜度半糖、少冰、常溫
       📎 bom-黑糖珍珠綠茶鮮奶.csv(422 B)
bom_workflow 這種「多步驟人機協作」的工具,標準走法是三層分工:
| 層級 | 職責 |
|---|---|
| 主對話迴圈 | 人機協作本身(提問 → 回合結束 → 使用者回答 → 續接) |
| Tool(狀態機) | 階段轉移、欄位校驗、草稿存檔:確定性程式碼,模型只當傳話筒 |
| Skill(知識) | 何時啟用、每種違規怎麼解釋、規則的權威定義 |
它的整個流程如下:
product → parts → ready → exported
   │         │       │
   │         │       └─ export 動作把 CSV 寫進 /output,標記 exported
   │         └─ 使用者說「完成」且驗證全過才推進到 ready;
   │            驗證沒過會退回 parts,附上問題清單要求修正
   └─ 產品名稱、容量驗證通過才推進到 parts
因此情境二裡「參考 黑糖珍珠鮮奶的bom」這句話,流程走的是這條路:glob → glob → read_file → bom_workflow。模型先用 glob 找到 /output/bom-黑糖珍珠鮮奶.csv 這份先前的產出檔,read_file 讀出內容,再把裡面的料件透過 bom_workflow 一次性加進新草稿,等於是拿既有品項的 BOM 直接當範本,只需要在上面加減修改,不必每個品項都要從零開始一個一個料號問起。
SKILL.md 技能檔內容:
---
name: bom-copilot
description: "Guide the user step-by-step to build a validated drink recipe BOM."
allowed-tools: bom_workflow parts_search
---
rules.yaml 技能附檔是真正的規則定義,摘要幾條跟飲料店情境最直接相關的:
- id: LID-MUTEX
  type: mutex
  parts: ["LID-FLAT-90MM", "LID-DOME-90MM", "LID-HOT-90MM"]
  message: "杯蓋互斥,一杯只能擇一"

- id: HOT-DRINK-NO-ICE
  type: forbidden
  when: {part: "CUP-350ML-HOT"}
  forbid: {part: "ICE-CUBE-STD"}
  message: "熱飲不可加冰塊"

- id: CAPACITY-MATCH
  type: attribute_match
  scope: {category: "packaging", part_prefix: "CUP-"}
  attr: "capacity_ml"
  condition: ">= order.volume_ml"
  message: "杯子容量需 >= 訂單所需總液體容量(含冰/配料預留空間)"
三種規則型別(mutex 互斥、requires 相依、attribute_match 屬性條件)剛好對應到飲料 BOM 常見的三類問題:杯蓋只能選一種、熱飲杯一定要搭配熱飲蓋、杯子容量要撐得住訂單所需的量。
workspace/skills/bom-copilot/
├── SKILL.md            # 何時啟用、Procedure、Violation Scripts
└── rules.yaml          # mutex / requires / attribute_match 規則定義

mini_hermes/harness/customize/examples/
├── bom_workflow.py     # 狀態機工具:start/submit/status/export
├── bom_rules.py        # 規則引擎求值邏輯
└── parts_catalog.py    # parts_search 用的料件目錄

workspace/output/
├── bom-黑糖珍珠鮮奶.csv        # 情境一產出
└── bom-黑糖珍珠綠茶鮮奶.csv    # 情境二產出
這一篇從「怎麼蒸餾出框架」講到三個實驗 demo,整個 AI 協同開發的流程是一個循環:
跟 AI 討論關鍵架構 → 寫一個初版 → 小模型實測 → 從卡住的地方回頭迭代機制
實驗也體現了 LangChain Deep Agents 這個 SDK 是真的可以做出你自己的輕量版龍蝦或輕量版 Hermes Agent,雖然還有許多需要再優化的地方。


 iThome鐵人賽
 看影片追技術