
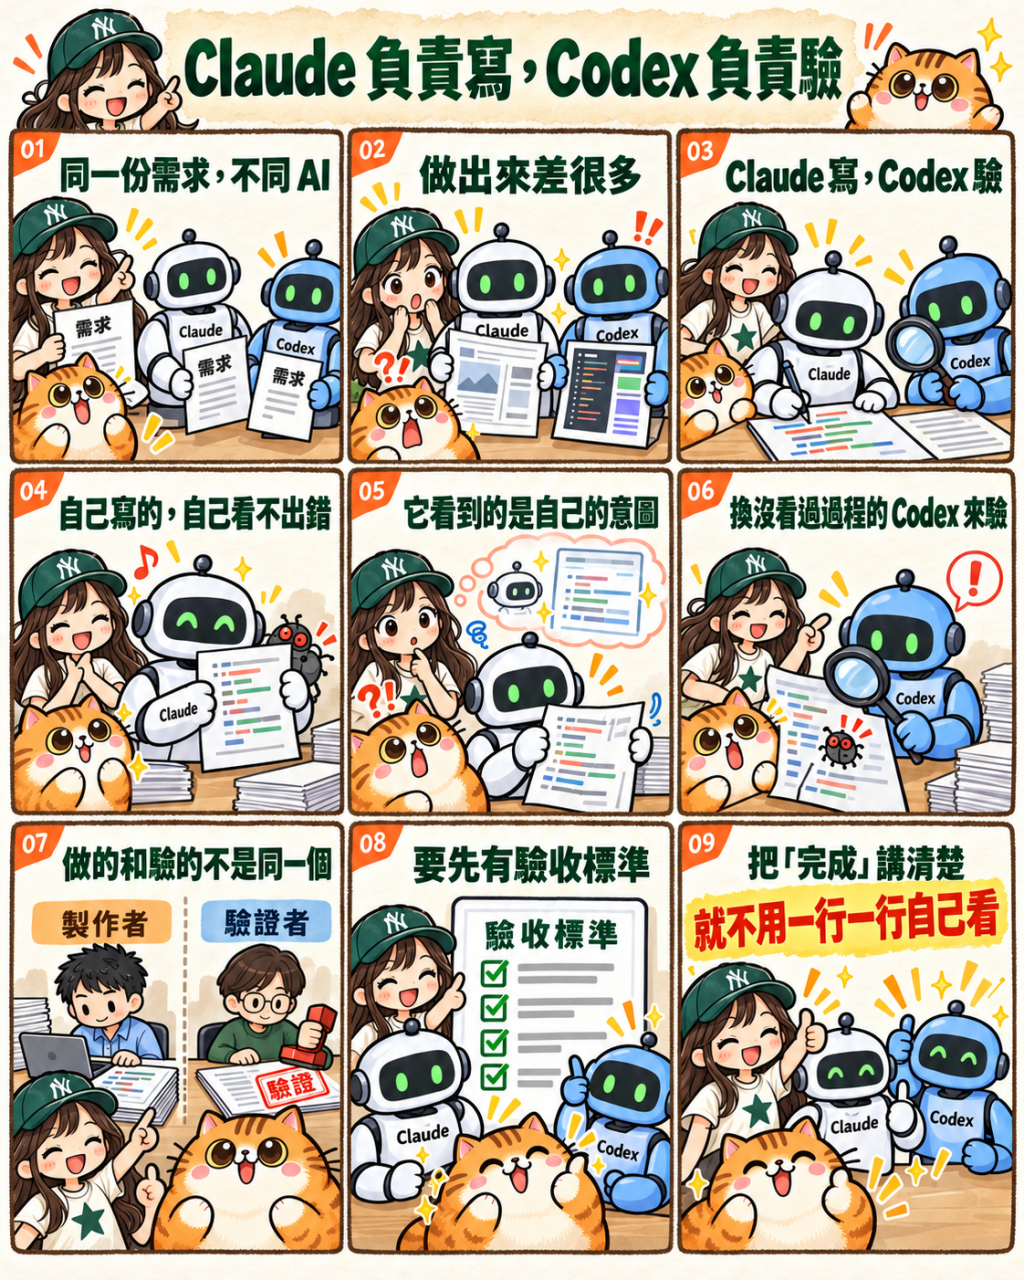
同一份需求,丟給不同的AI,做出來的東西可以差非常多。
一開始只是好奇做了比較,後來慢慢變成一種固定的工作方式:
讓claude負責寫,codex負責驗。
為什麼不讓claude自己寫、自己檢查?
因為它跟人一樣,自己寫的東西,自己很難看出問題。
就像自己寫的報告,自己校對三次,還是會漏掉那個錯字,
它知道自己「想」做什麼,所以檢查的時候,
看到的是它的意圖,不是它真正寫出來的東西,
換一個完全沒看過過程的codex來驗,它只能看結果。
需求寫了什麼?程式做了什麼?兩個對不對得起來?
這其實就是公司裡早就在做的事:負責Design的工程師,跟驗證工程師往往不會同一人。
帶同學這樣做之後,有一個額外的收穫。
要讓第二個AI近來驗證,你必須先有一份寫清楚的需求和驗收標準。
不然它要拿什麼來驗?
所以繞了一圈,又回到Day 5。
「什麼叫完成」講得清楚,寫的claude有方向,驗的codex有依據。
而我們,終於可以擁有兩個超級大腦幫我們處理。


 iThome鐵人賽
 看影片追技術