
昨天測的 react-doctor 用決定性規則管「該不該被抓出來」;今天測的 code-review-excellence 剛好是另一個極端——它完全不碰規則,純粹是一份教你怎麼審查程式碼的說明書,塞進同一個會讀 diff 的模型腦袋裡。拿同一段改動,一邊直接叫它看 diff,一邊叫它套上這份技能再看,原本預期會看到「抓得更多」的差別,結果看到的是另一件事。
準備了一段很普通的改動:一個分頁函式漏算了最後一筆;一個下單函式套用自動重試卻沒管冪等性——伺服器其實已經建立訂單,只是回應在路上遺失,client 會以為失敗而重送,結果多出一張一樣的訂單;還有一段用型別系統限制排序欄位、看起來安全,但執行期完全沒擋的字串拼接。兩邊都抓到了這三個問題,連嚴重度判斷都一致:off-by-one 最確定,重複下單風險最高,SQL 防護只在編譯期有效排第三。對同一個模型來說,套不套這份技能,「看不看得出問題」幾乎沒有差。
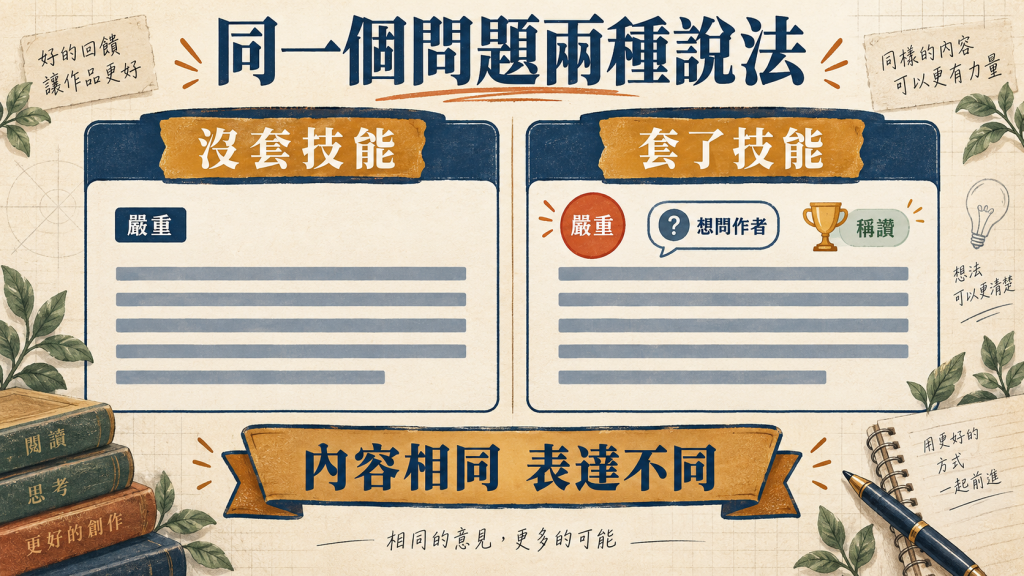
沒套技能那邊,四個檔案各自寫一段文字分析,用「嚴重/高/中」這種字眼標等級,給完建議就結束。套了技能那邊,每一條都先貼一個標籤——🔴 blocking、🟡 important、🟢 nit、🎉 praise——文末還給了一句明確結論:「🔄 Request Changes」,外加一張用測試、正確性、安全、可維護性四個維度打分的總結表。遇到「這個約定有寫進文件嗎」這種可以直接下指令的地方,它改成問句:「想問作者,這個約定有寫進 JSDoc 嗎?」這正是這份技能裡「用提問取代命令」那條技巧的具體落地,不是巧合——它真的照著技能寫的方式在輸出,而不是碰巧用詞相似。
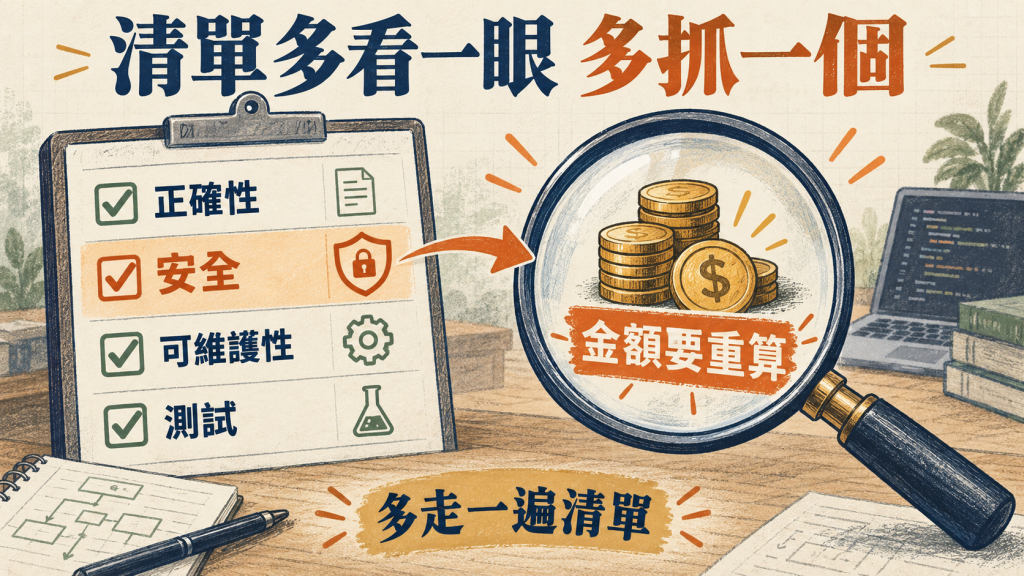
兩邊重疊的發現之外,套了技能那邊多抓到一條:下單函式裡的金額欄位是前端傳來的,後端應該自己重算,不該直接信任這個數字。沒套技能那邊沒提到這條。這不是巧合——技能文件裡明確列了一份安全檢查清單,要求過一輪「敏感資料外洩」「輸入驗證」這幾項,逼著它多走一遍清單,而不是看到最顯眼的幾個問題就收工。多數時候技能只是換了說法,但偶爾,逼自己照清單多看一眼,真的會多抓到東西。
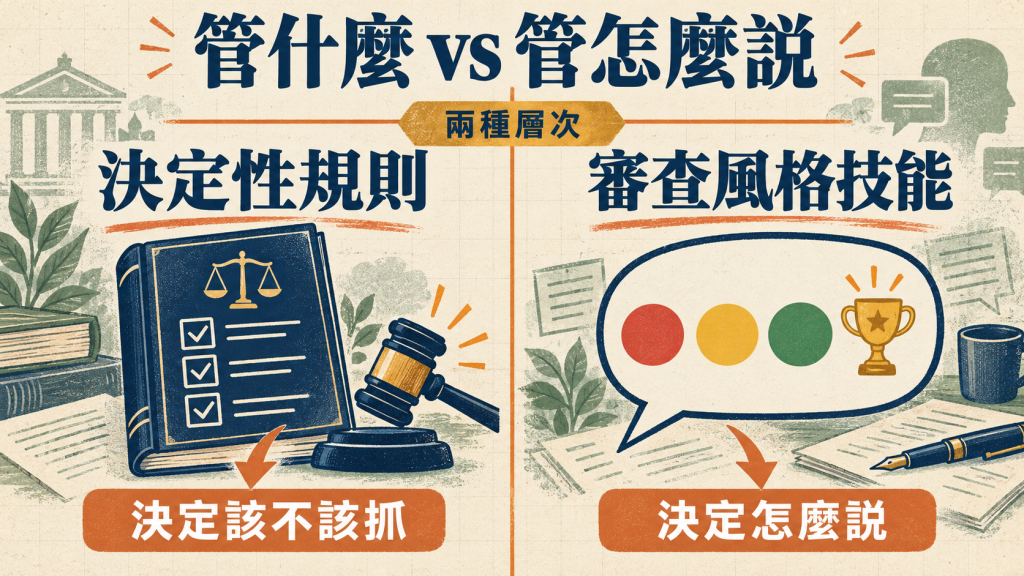
一個人單獨看 diff,「抓不抓得到」從來不是瓶頸——有能力的模型本來就看得到大部分東西。真正的瓶頸是一群人、一堆 PR 長期累積下來,留言的嚴重度判斷、語氣、該不該卡住合併的決定,會不會每個人每次都不一樣。這份技能解決的正是這件事:把「這條一定要改」和「這條只是建議」講清楚,把命令式語氣換成討論式的,強制留一句明確決定,甚至強制留一句稱讚——這些都不是技術判斷,是讓審查這件事可以被信任、可以被重複執行的社交契約。跟昨天的 react-doctor 放在一起看特別清楚:一個管「該不該被抓出來」,一個管「抓出來之後怎麼說」,兩者解決的是完全不同層的問題。
這系列前面測的技能,大多改變的是模型「做了什麼」或「看到了什麼」。code-review-excellence 幾乎沒有改變它看到什麼,改變的是它怎麼把看到的東西講出來——而這恰好是團隊協作裡最容易被低估、卻最常真正卡住流程的那一層。
明天找下一個方向繼續測,候選清單還在累積。


 iThome鐵人賽
 看影片追技術