
今天介紹的 react-doctor,標語寫得很直接:「你的 agent 寫的爛 React,這個抓得到。」它的存在前提本身就值得玩味:agentic coding 已經普遍到需要一個專門的工具,去抓「AI 寫程式碼時特別容易犯」的那一類錯,而不是泛泛的程式碼品質問題。
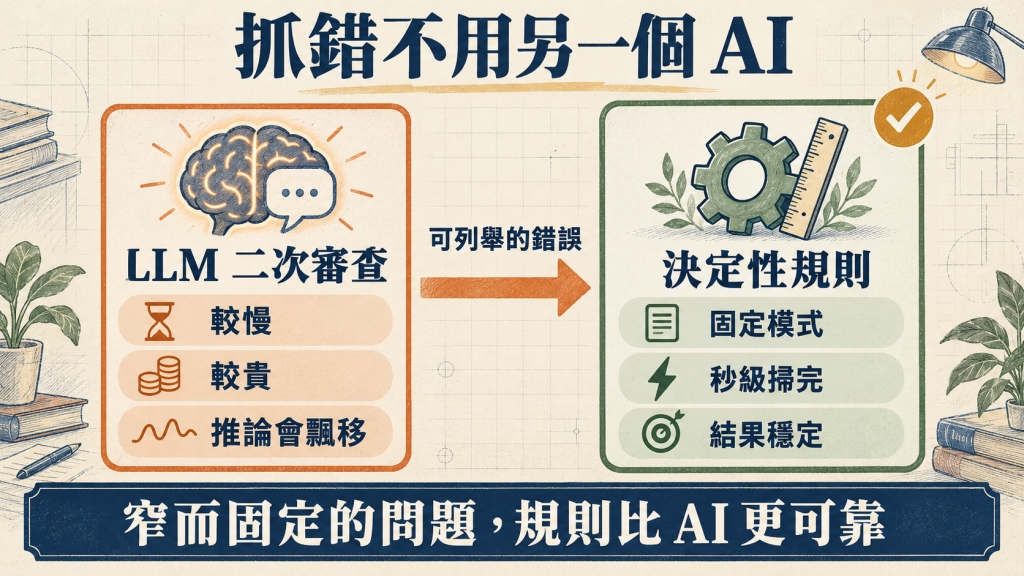
最有意思的地方不是它抓到什麼,是它怎麼抓。它是決定性的靜態分析,不是另一包 LLM review。這個選擇本身就是一種態度:agent 寫壞 React 最常見的幾種模式,其實高度可列舉——useEffect 裡直接 fetch 沒處理競態、拿到 response 不檢查狀態碼就解析、promise 鏈少了 .catch——這些都是結構固定、可以用語法規則精準描述的錯誤,交給決定性規則一次寫死,比每次都叫一個 LLM 重新判斷一次更快、更便宜,也不會因為當次推論狀態不同而漏判。不是所有「AI 相關」的問題都該用 AI 去解,這是它給我的第一個提醒。
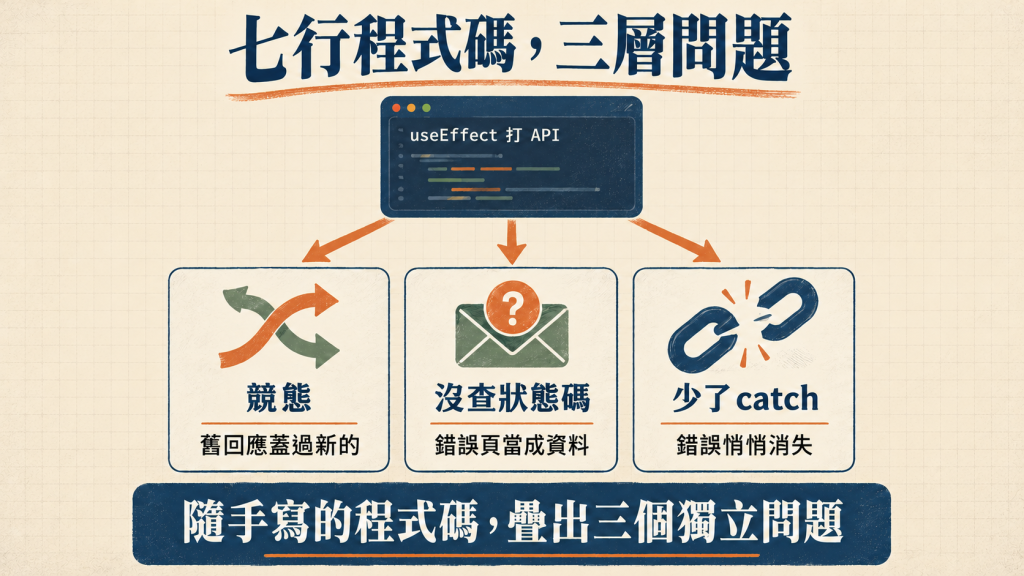
拿一個最常見的「元件掛載時打 API」寫法去跑:useEffect 裡 fetch 一個使用者資料端點,.then 解析 JSON,再 .then 塞進 state。這種寫法我自己也寫過無數次,順手到不會多想。
跑起來之後,同一段七行程式碼疊出三個各自獨立的警告:fetch 包在 useEffect 裡沒處理競態(元件如果在請求完成前重新渲染或卸載,舊的回應還是會打進 state);拿到 response 直接呼叫 .json(),沒檢查 res.ok(伺服器回 404 或 500 時,這段程式碼會把錯誤頁面內容當成合法資料繼續往下跑);promise 鏈沒有 .catch,請求失敗時錯誤會靜悄悄消失,不會有任何提示。三個問題疊在同一段看起來很正常、甚至很常見的程式碼裡,而且彼此獨立,不是同一個根因的三種說法——這正是我找這個工具來測之前沒預料到的收穫:隨手寫的示範程式碼,比我刻意設計的測試案例還真實。
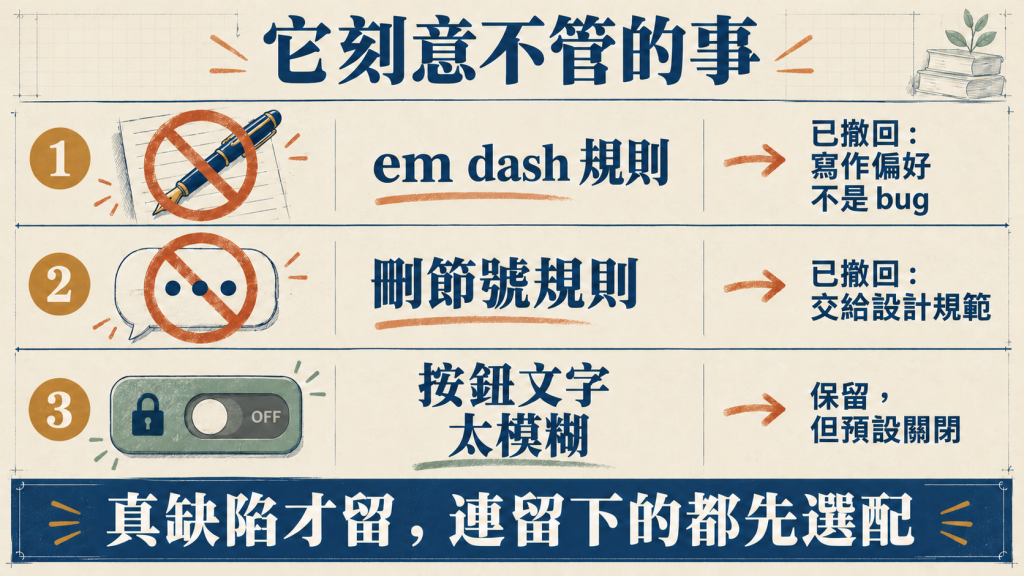
翻它的規則集會看到一個耐人尋味的細節:它曾經寫過兩條規則,一條抓 JSX 文字裡的 em dash,一條抓「...」要不要換成正式的刪節號「…」——這兩條後來都被正式撤回,維護者留下的理由是:「視覺與寫作偏好該放進明確的設計規範,不該是一般性的缺陷檢查。」這個決定本身就是一種清楚的立場:寫作習慣是品味,不是 bug,就算這個品味剛好跟「AI 寫作的痕跡」重疊,也不代表它該變成一條人人都要遵守的強制規則。
另一條「按鈕文字太模糊」的規則留了下來,而且理由很具體:像「Continue」「Submit」這種標籤,螢幕報讀使用者完全不知道按下去會發生什麼事,這是真的會傷害到人的可用性問題,不是單純的美感偏好。但即使有這麼明確的理由,這條規則預設還是關著的,要專案自己選擇開啟。一個工具在「這是真缺陷」和「這是我覺得比較好的寫法」之間,連哪些該預設開、哪些只能選配,都分得這麼細,這份克制比它抓到多少 bug 更值得學。
它給了三種掛載方式,分別對應不同的使用情境:專案根目錄跑一次就是完整稽核;在 CI 裡裝上後,每個 PR 只回報這次改動新增的問題,不會把整個專案的歷史債務都搬出來洗版——這個「只看變化量」的設計很實際,稽核工具最容易讓人放棄的原因就是一次丟出幾百條舊問題,沒人看得完也沒人想看;第三種是直接幫 coding agent(Claude Code、Cursor、Codex 都支援)裝成一份技能,讓 agent 自己讀過去抓到的問題學起來,下次少犯一次。
它還有一個比較少見的功能:連上一個真的在跑的頁面,錄一段 Chrome DevTools 的效能 trace,邊錄邊在畫面上即時標出哪個元件在重新渲染。大多數這類工具只分析原始碼,它多做了一步,把「跑起來之後實際發生了什麼」也納進來。
它判斷要不要套用 React 專屬規則,靠的是有沒有偵測到專案真的依賴 React。在一個沒有宣告 React 依賴的空殼專案裡試跑,大部分規則直接被關掉,只剩語言通用的部分在跑——這點在測試或範例專案裡容易讓人誤會「這工具好像沒抓到什麼」,其實只是判斷條件沒有被滿足。它的輸出裡也老實列出遙測蒐集了什麼(版本、框架、觸發的規則名稱,不含程式碼內容),想關掉也有現成的指令。
這系列前面測過不少靠 LLM 去判斷、去審查的技能,react-doctor 提醒我另一條路也成立:窄、可列舉、語法固定的問題,決定性規則處理得又快又穩;真正需要判斷的,它選擇留白,而不是硬湊一條規則充數。工具好不好用,有時候不是看它抓到多少,是看它清不清楚哪些事不該自己做決定。
明天找下一個方向繼續測,候選清單還在累積。


 iThome鐵人賽
 看影片追技術