

前幾天做完 Direct Manipulation 之後,Visual Learning Lab 已經可以讓使用者直接抓住 phasor、初速度向量、數學錨點,而不是只能在旁邊拉 Slider。
但做到這裡,我開始發現一個更大的問題。
Day 19 做的 Source Atlas 已經可以回答:
「這個概念在原始教材的哪裡?」
Day 24 做的 Direct Manipulation 則可以回答:
「這個概念能不能直接操作?」
問題是,這兩件事其實還是分開的。
我可以在教材裡看到一個公式,也可以在 Explore 裡玩一個互動模型,但使用者其實不知道:
這兩個東西到底是不是同一個概念?
所以 Day 25 我想做的不是再增加一種新的視覺化。
而是把前面已經做出來的幾個系統真正接起來:
原始教材上的物件
        ↕
Stable Semantic ID
        ↕
互動 Learning World
        ↕
Canonical State
我把這個能力叫做:
也就是:
教材裡的一個公式、箭頭或概念,可以擁有一個能被操作的互動分身。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
原本 Day 25 的規劃其實有一個很誘惑人的方向:
Three.js。
因為做到 Learning World 之後,下一個很自然的念頭就是:
那乾脆開始做真正的 3D 吧。
甚至我還研究了:
但重新把 Day 19~24 的成果攤開之後,我最後決定先不做。
原因很簡單。
現在真正還沒有被證明的,不是:
我能不能畫出一顆更漂亮的 3D 球?
而是:
我能不能證明,原始教材裡的那個東西,真的就是右邊正在被操作的那個東西?
如果這一層都還沒有接好,就算右邊做出再酷的 3D,其實還是另一個 Demo。
所以 Day 25 先把 Source 和 Interactive World 接起來。
這也是我這幾天越來越在意的一件事:
不要每次想到一個新功能,就重新做一套系統。
Source Atlas 本來就已經有:
Day 24 的 Direct Manipulation 也已經有:
所以 Day 25 真正缺的其實不是另一套 AI。
而是中間的一座橋。
最後的架構變成:
Validated Source Region
        ↓
semantic_ids[]
        ↓
Semantic Entity
        ↓
Existing Manipulation Target
        ↓
Existing World / Lab State
最重要的是:
Day 25 沒有新增一個模型 schema。
也沒有叫 AI 再回答一次:
「請告訴我這個來源框應該對應哪一個 draggable object。」
只要前面的系統已經擁有相同 semantic ID,這個連結就可以在本地端直接推導。
實際做之後才發現,Source ↔ Twin 並不是簡單的一對一關係。
例如一個「相位」概念,教材裡可能同時出現在:
所以比較合理的結構其實是:
Source Region A ─┐
Source Region B ─┼─→ phase
Source Region C ─┘
                     ↓
               Phasor Handle
                     ↓
                 Waveform
                     ↓
                  Metric
也就是:
一個 semantic entity 可以有多個來源,也可以有多個 representation。
反過來,它也可能:
有來源
有 semantic ID
有正式表示
但沒有安全的 manipulation target
這件事後面會變得非常重要。
第一條路徑是從教材走到互動世界。
使用者現在可以在 Source 裡選一個區域。
例如選到教材中的相位圖。
系統會先找到:
region
↓
semantic ID
接著查看這個 semantic ID 是否存在合法的 manipulation target。
如果有,就會出現:
在互動場景中探索
按下去之後不是重新生成一個場景,也不是再問一次 AI。
而是直接把目前的 canonical semantic focus 帶進原本的 Learning World。
所以整條流程是:
Source Region
↓
Semantic Focus
↓
Existing Learning World
↓
Existing Manipulation Target
沒有第二套 focus state。
反過來也要成立。
如果使用者已經在 Explore 裡操作 phasor,我希望他可以回頭問:
這東西原本到底是教材哪裡來的?
所以互動物件也會沿著同一個 semantic ID 回頭找 Source Atlas。
Manipulation Target
↓
Semantic ID
↓
Supporting Source Regions
↓
Original PDF
如果來源真的有可靠的 bbox,就聚焦到那個區域。
如果只有 page-level support:
那就只回到那一頁。
不能為了畫面漂亮,自己捏一個假的框。
這一段也滿有趣。
原本我以為 Day 25 很可能會接 OpenSeadragon,因為它本來就是很成熟的圖片 pan / zoom viewer。
所以這天也真的去研究了它。
但實際拿現有 Source Atlas viewer 去測之後:
都可以正常運作。
region click 正常。
換頁正常。
重新 render 之後 viewport 也能保留。
而且缺少的「focus 到指定來源區域」其實在現有 viewer 裡就能補。
所以最後的決定是:
OpenSeadragon 暫緩。
不是它不好。
而是現在換掉 viewer,會增加一套新的 frontend dependency、coordinate adapter 和 deployment surface,但沒有證據證明產品因此會更好。
Day 25 反而讓我更確定:
能不用新輪子,就不要為了「用了新技術」而用。
這天最重要的產品規則之一,是把兩種「值」分開。
假設教材寫:
θ = 18°
然後使用者進入 Learning World,把它拖到:
θ = 90°
這時系統絕對不能偷偷把教材變成 90°。
所以現在會明確區分:
Compiled baseline
Current exploration
Delta
而原始來源永遠維持原本內容。
也就是:
SOURCE
θ = 18°

CURRENT EXPLORATION
θ = 90°

Δ
+72°
不過我也刻意沒有把 Compiled baseline 直接稱為「Source value」。
因為模型建立場景時的 initial value,不一定能被證明就是來源中精確寫出的值。
這個小地方我覺得很重要。
Visual Learning Lab 可以幫你探索。
但不能因為畫面方便,就把「模型推導」偽裝成「來源事實」。
第一個驗收案例延續 Day 24 的 phase world。
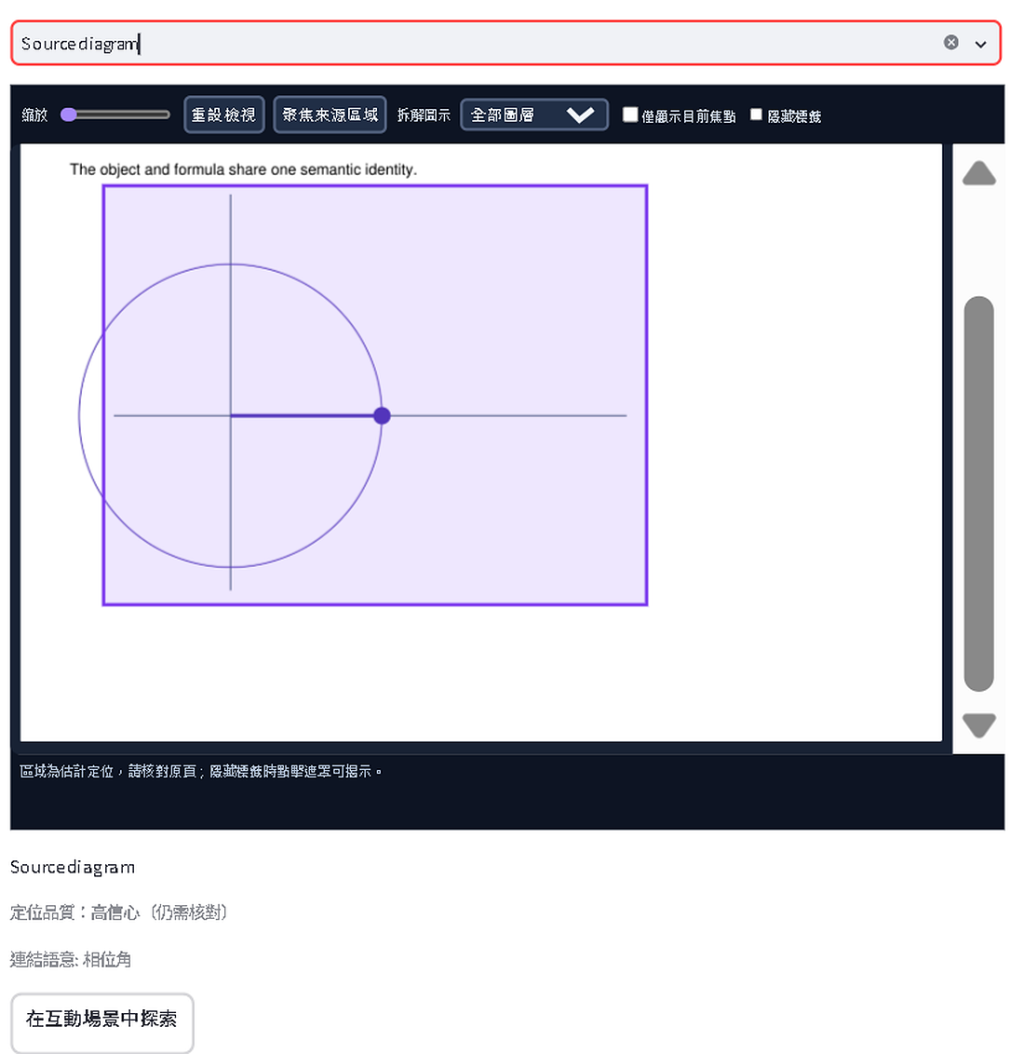
現在可以從 Source 裡面的 diagram:
Source diagram
↓
相位角 semantic entity
↓
Open interactive twin
直接進到原本的 phasor。
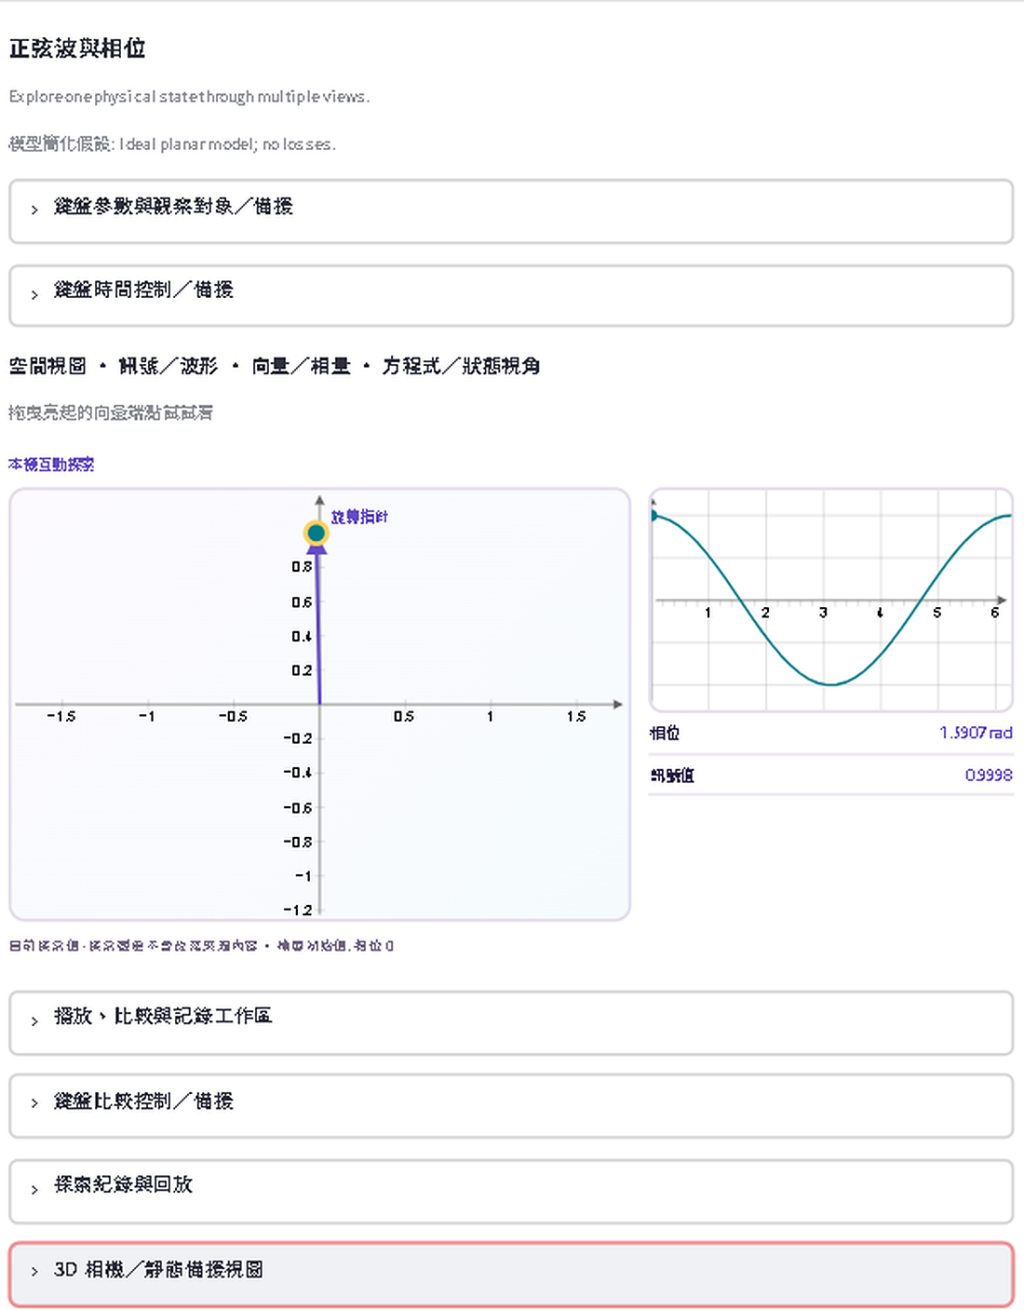
接著把 phasor 往圓頂拖。
實際真人操作時得到:
phase ≈ 1.5907 rad
signal ≈ 0.9998
非常接近:
π/2
signal = 1
waveform 也同步移動。
而且再切回 Source:
原本的來源圖還是原本的來源圖。
探索狀態則繼續保留。
這就是我 Day 25 最想做到的感覺:
教材沒有被改掉,但教材裡的概念「活起來」了。
第二個則延續之前的 projectile world。
來源中的 launch quantity / vector 可以連到 Day24 已經存在的 launch vector。
使用者直接拖初速度端點之後:
speed ≈ 30 m/s
angle ≈ 60°
Runtime 重新得到:
horizontal velocity ≈ 15 m/s
整條 trajectory 也同步更新。
這裡完全沒有重新寫 projectile 公式。
Grounded Twin 只負責:
「這個來源概念,連到哪個已存在的互動物件?」
真正的物理計算還是原本的 Spatial World 在做。
為了避免最後看起來只是一個物理工具,第三個案例沿用:
y = ax + b
從公式對應到 affine semantic entity,再連到 Day24 的 draggable anchor。
把 x=0 anchor 拉到大約:
y = 2
得到:
b ≈ 2
另外一個 anchor 也同步跑到:
y ≈ 4
同一套 Grounded Twin bridge 可以接物理,也可以接一般數學。
它自己不需要知道這是:
projectile、phase 還是 linear equation。
它只認:
source region
semantic ID
representation
manipulation target
這是 Day 25 我最喜歡的一個限制。
很容易有一種誘惑:
既然都做互動世界了,那全部數字都弄成可以拖不是更酷?
但這其實會開始亂教。
例如:
它們可能都有來源。
也可能都有 semantic ID。
但:
不代表有合法的 direct manipulation。
所以 Day 25 特別加入一個 non-manipulable acceptance case。
結果是:
Source ✅
Semantic focus ✅
Formal representation ✅
Direct manipulation ❌
畫面會正常顯示來源和正式表示。
但不會為了看起來酷,硬塞一個假 handle。
這其實也是我現在對 Visual Learning Lab 越來越明確的想法:
好的互動不是「什麼都能拖」。
而是:
只有語意上合理,而且 Runtime 能安全解釋的東西才可以拖。
前面的工程驗收仍然使用自己準備的 deterministic PDF。
所以最後我又拿了一份真正正在使用的教材來試。
裡面有一個很典型的正弦波公式:
v(t) = Vm cos(ωt + θ)
還有實際 waveform 圖。
Visual Learning Lab 的 Source Atlas 最後真的把公式區域抓出來:
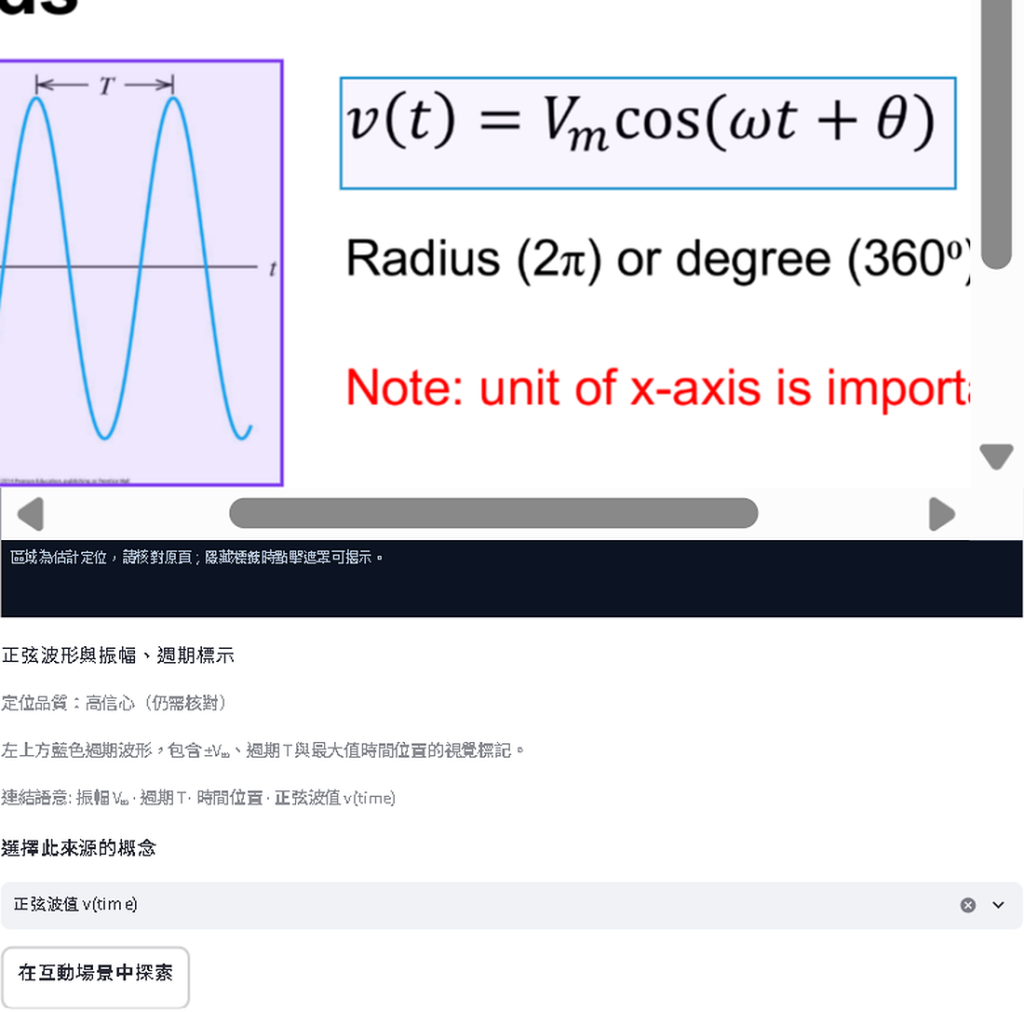
它連到的概念包含:
接著按:
在互動場景中探索
可以直接進入正弦波 Learning World。
裡面原本就有:
而且這些互動不是重新問 AI。
都是本地 Runtime 執行。
這次我覺得是 Day 25 最重要的人工驗收。
因為這終於不只是:
我自己設計一份 PDF,然後自己的系統成功處理它。
而是真的拿教材裡的一個公式:
v(t) = Vm cos(ωt + θ)
接到一個活的 Learning World。
這次 Browser acceptance 也抓到一個很實際的問題。
Direct Manipulation 本身其實已經成功 commit。
但是 Numeric Lab 原本的 slider callback,在 Streamlit rerun 後又把舊值寫回去。
結果變成:
drag
↓
新值 commit
↓
rerun
↓
舊 slider callback
↓
把新值蓋掉
如果只看純 Python unit test,其實不一定會發現。
最後是跑真正 browser interaction 才抓到。
這次也修成:
slider 和 direct manipulation 都只能操作同一份 canonical value,而不能在 rerun 時互相覆蓋。
這也是為什麼我現在越來越不敢只看:
tests passed
Browser interaction 還是得真的玩。
Grounded Twin 本身其實非常輕。
因為它沒有在做新的 AI 推理。
只是利用既有 ID 推導 source ↔ target link。
實測中位數:
| Case | Link derivation |
|---|---|
| Phase | 0.0977 ms |
| Projectile | 0.0544 ms |
| Affine | 0.0587 ms |
產生的 link data 大約:
0.94 KB ~ 1.01 KB
所以這一層幾乎不是效能瓶頸。
這一天我刻意把 real-model usage 壓到非常低。
因為:
semantic ID linking
viewer event
bbox focus
navigation
drag
state
browser synchronization
全部都是 deterministic engineering 問題。
根本不應該一直叫模型重新抽卡。
最後實際模型探測:
Requests: 1
Input tokens: 9,118
Output tokens: 2,407
Total: 11,525
而且沒有 SDK retry。
這次模型最後接受了:
14 個來源區域
之後:
Source click
Twin navigation
drag
slider
reset
return to source
全部:
Day 25 最後 focused tests:
40 passed
Source Atlas:
30 passed
然後完整 regression:
耗時:
226.441 秒
完整 regression 一樣只跑一次。
除此之外還做了:
而且 Generic Grounded Twin bridge 裡沒有:
if phase
if projectile
if affine
這種 topic-name routing。
Day 25 最後反而有兩個「沒有做」的東西值得記。
研究了。
但現有 viewer 已經可以:
所以:
DEFER。
也研究了。
它很適合下一階段真正做:
但 Day 25 的 source grounding 還比較重要。
所以:
DEFER。
我現在反而覺得這種「有研究,但最後決定不用」很健康。
因為專案開始不是:
今天可以塞什麼酷東西?
而是:
今天哪個東西真的讓產品往核心問題前進?
現在整條路開始變成:
ORIGINAL MATERIAL
        ↕
SOURCE REGION
        ↕
SEMANTIC ENTITY
        ↕
REPRESENTATION
        ↕
DIRECT MANIPULATION
        ↕
CANONICAL STATE
        ↕
LEARNING WORLD
而且這些不是六套互相不知道彼此存在的功能。
它們開始共享:
同一個 semantic identity。
這讓我第一次真的覺得:
Visual Learning Lab 裡的「Source」和「Explore」不再是兩個頁面。
它們只是:
同一個概念的兩個視角。
如果 Day 1 的 Visual Learning Lab 是:
Turn complex ideas into something you can actually see.
Day 24 之後可以加:
And something you can actually touch.
那 Day 25 我覺得又可以再往前一步:
The diagram in your textbook now has a living twin.
原始教材還是原始教材。
AI 不會偷偷改掉它。
但教材裡的一個公式、一個向量、一個概念,可以一路連到一個真的能操作、能實驗、能回頭驗證來源的 Learning World。
這大概就是目前 Visual Learning Lab 最接近我一開始想做的東西的一天。


 iThome鐵人賽
 看影片追技術