

前幾天做到 Universal Learning World Compiler 之後,Visual Learning Lab 已經可以把不同教材分配到不同的互動世界。
有數學關係就進 Numeric Lab、有空間運動就進 Spatial World、有狀態轉移就進 Process Runtime,甚至連 recursion 的 call / return 都開始有真正的 execution semantics。
但我後來發現一個很明顯的問題。
雖然這些東西都叫「互動」,大部分時候使用者其實還是在操作:
也就是說,我想理解一個向量,卻不是去碰那支向量,而是先找到旁邊一個數字,再拉一個 Slider。
這件事開始讓我覺得很不對。
所以 Day 24 的目標變得非常單純:
不要再讓使用者操作控制器,直接讓他操作知識本身。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab
我想做的體驗其實很像 GeoGebra 或 PhET。
如果今天在學 Phase:
就直接抓住 phasor 的端點旋轉。
如果今天在看 Projectile:
就直接抓住初速度向量,把它拉長、改角度。
如果今天是一條直線:
就直接拖圖上的 anchor,讓 equation 跟著改。
而不是:
拖 Slider
↓
改數字
↓
圖才跟著動
我希望變成:
直接拖圖上的物件
↓
推回真正的數學參數
↓
Canonical State 改變
↓
所有 representation 一起更新
這其實看起來只是 UI 改了一點,但底層完全不是同一件事。
Day 20 做完 Open Source Audit 後,我現在每次要新增比較大的圖形功能,都會先問一個問題:
GitHub 上是不是已經有人把這個輪子做得比我好很多?
所以這次先讓 Codex 比較了幾種選項:
Konva 很適合一般 2D Scene Graph,PixiJS 則非常適合高效能的 2D rendering。
但目前 Visual Learning Lab 最缺的並不是一個通用遊戲引擎。
而是:
數學物件、座標、向量、Constraint 和 Drag 本身。
最後選擇的是:
而且明確使用 MIT License。
這次是離線 bundle,沒有把 CDN 當成 Runtime dependency,也沒有新增 Python dependency。
JSXGraph 幫我們負責:
但它不負責「什麼叫 Phase」。
也不負責「拖到這裡代表初速度是多少」。
那些還是我們自己的 Semantic Runtime 負責。
這是 Day 24 最重要的 architecture decision。
我很不希望變成:
Python 裡有一份 state
JavaScript 裡又有另一份 state
最後兩邊開始不同步。
所以現在規則還是一樣:
Python / Runtime 的 Canonical State 才是正式狀態。
Browser 可以在拖曳途中做暫時 preview。
但真正放開滑鼠時:
Gesture
↓
Semantic inverse mapping
↓
Validation
↓
Canonical state patch
↓
Shared reducer
↓
重新投影所有 representation
也就是 Browser 不可以偷偷說:
我現在 Phase 是 90°,所以就是 90°。
它只能說:
使用者把這個合法 draggable point 拖到這個座標。
接下來由可信任的 Runtime 算出:
這代表 phase = π/2。
這個差別非常重要。
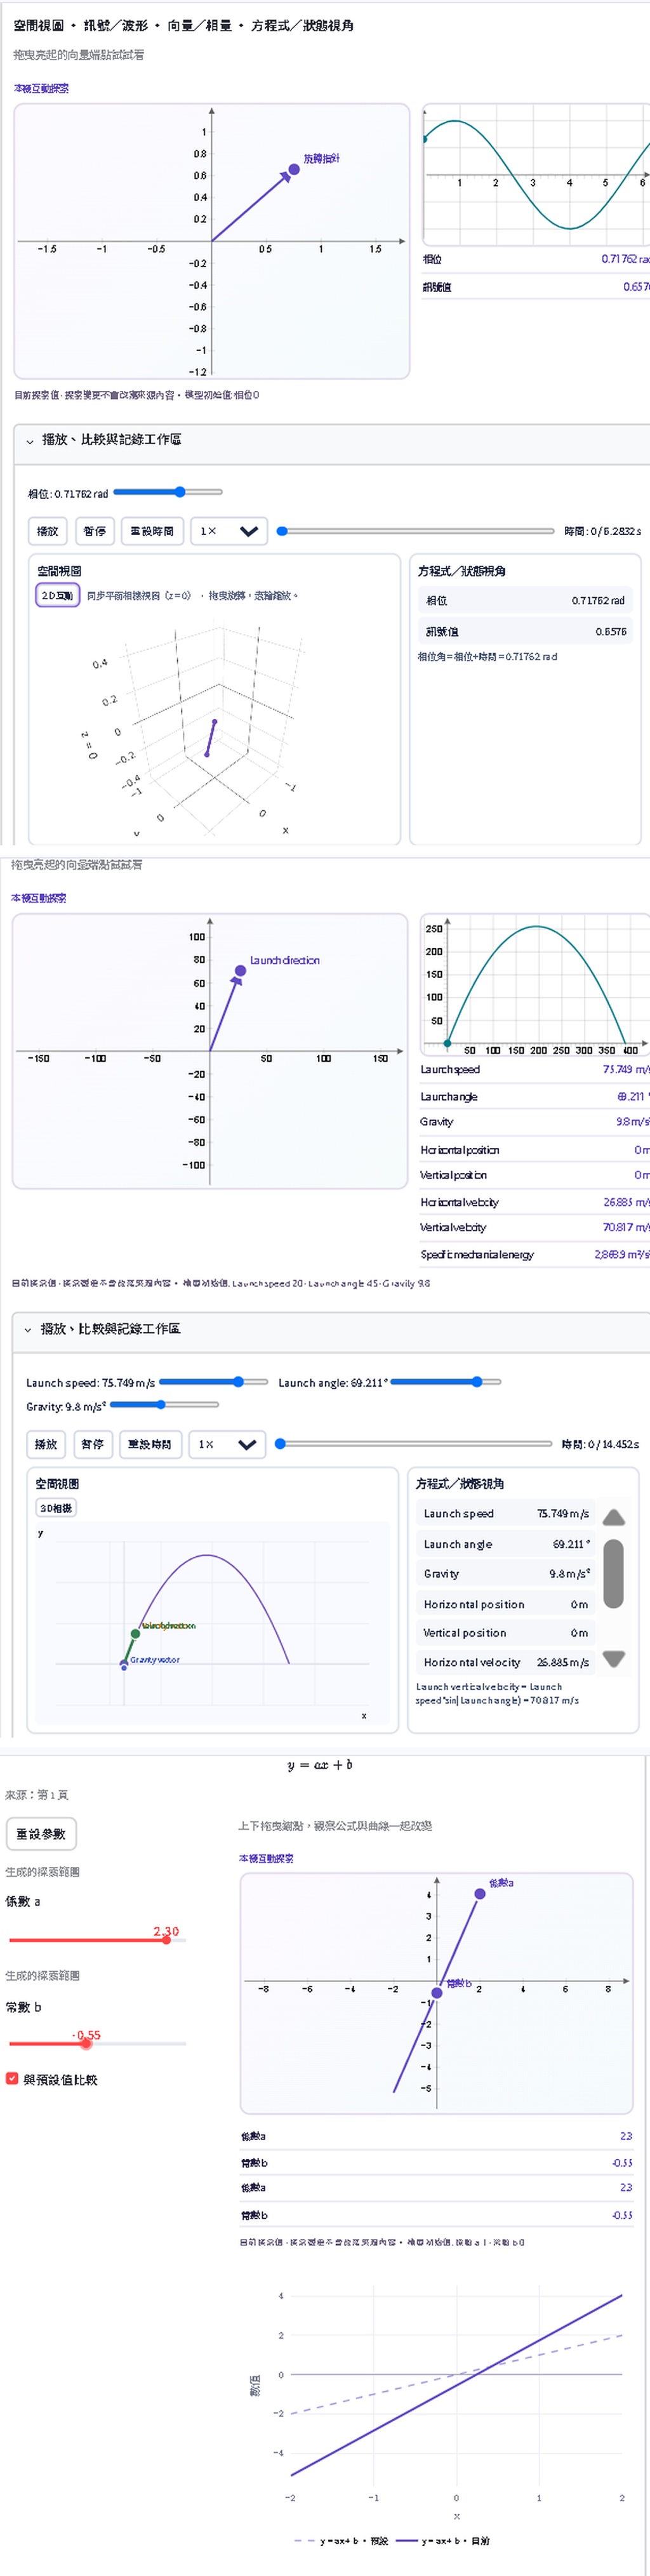
第一個 hero case 就拿之前已經存在的 sinusoid / phase world。
這次沒有重做新的波形引擎。
原本的 formal state、waveform、projection 都保留,只是在前面加上一個可以直接操作的 phasor。
現在可以直接抓紫色端點旋轉。
例如把端點往上拉之後:
visual drag
↓
derive phase
↓
phase state changes
↓
projection changes
↓
waveform shifts
↓
current signal value changes
全部一起更新。
【圖片 1:直接拖曳紫色 phasor 端點後,phase、signal value 與下方 waveform 同步改變】
這張圖對我來說滿有感的。
以前我是在操作一個「Phase Slider」。
現在我是在操作:
Phase 本身。
第二個案例則把相同的 manipulation contract 接到之前 Day 18 的 Spatial World。
這次可以直接抓初速度箭頭的端點。
拖遠:
velocity magnitude 變大。
換方向:
launch angle 改變。
然後原本的 projectile runtime 重新算:
也就是沒有為了 Day 24 再寫一個新的 Projectile Simulator。
而是:
重用原本的 Spatial World,只多了一種新的輸入方式。
【圖片 2:拖曳 Launch velocity 紫色端點後,速度、角度、水平速度與整條拋體軌跡同步更新】
這也是我這次很在意的一點。
如果每做一種 Direct Manipulation 就要重寫一個新的 App,那這個架構其實沒有意義。
真正想做的是:
same gesture contract
↓
different semantic inverse
↓
same canonical-state architecture
如果只做 Phase 和 Projectile,很容易變成:
其實你只是做了一個物理模擬器。
所以第三個案例刻意換成一般數學。
這次是一條 affine relation:
y = ax + b
圖上有兩個 semantic anchor。
直接拖 anchor 之後,不只是那顆點移動,而是會推回:
接著整條線和另一個 anchor 一起重新投影。
【圖片 3:直接拖曳數學錨點後,a、b、直線與另一個 anchor 同步改變】
而且這一關還有反向同步。
也就是:
Visual → State
可以。
原本的:
State → Visual
也還要成立。
例如用既有 Slider 改參數,圖上的 draggable point 也會跑回新的正確位置。
這才是真的兩邊共用同一份 state。
做到這裡,Day 24 最重要的結果其實不是三張漂亮圖。
而是:
| Case | Gesture | Canonical Target | Linked View |
|---|---|---|---|
| Phase | circular drag | phase | phasor / waveform / metric |
| Projectile | vector endpoint drag | speed + angle | vector / trajectory / metric |
| Affine relation | point drag | formal parameters | anchors / line / equation |
三個案例使用的是同一套 manipulation architecture。
不是:
if phase:
    ...

if projectile:
    ...

if linear:
    ...
Generic layer 只認:
真正的 domain formula 留在各自的 runtime。
這也是我目前在做 Universal Learning World Compiler 時一直想守住的界線。
這種功能其實非常容易做成危險的 architecture。
最方便的方法可能會是:
叫模型直接產一段 JavaScript,告訴前端拖曳之後要幹嘛。
但這條路我從一開始就不想走。
Day 24 還是維持之前的原則:
模型只能宣告:
哪個 semantic object 可以被操作
它對應哪個 formal quantity
適合哪種 gesture
真正的:
全部由可信任程式負責。
沒有執行:
eval
exec
這一天還補了一堆看起來很煩,但其實很重要的測試。
因為 Browser Event 本身也屬於外部輸入。
所以 Runtime 會拒絕像:
這些狀況都不能繞過原本的 Validator。
也就是:
「可以拖」不代表前端突然取得修改整個 Learning World 的權限。
另一個實際問題是 Performance。
Pointer movement 一秒可能幾十、甚至上百次。
如果:
mousemove
→ Python rerun
→ Streamlit rerun
→ browser redraw
每一次都這樣跑,使用體驗一定會爛掉。
所以最後採用的是:
拖曳途中 browser 做 local transient preview,放開後才正式 commit。
這樣手感比較順,但 Canonical State 最後還是會經過正式 Validator。
快取之後量到的 payload 中位數大約是:
Projectile 比另外兩個重一些很合理,因為它還要重新算整條 trajectory。
但整體已經足夠讓拖曳看起來是即時的。
這點跟前幾天一樣。
Day 24 實作和測試過程中一共用了:
8 / 12 次模型請求
共:
37,992 tokens
但 Learning World 一旦建立完成:
drag
drag
drag
change parameter
play
reset
全部:
這是我現在非常在意的一個產品特性。
AI 負責:
理解與編譯。
Runtime 負責:
執行與探索。
而不是使用者每動一下滑鼠,就重新花一次模型費用。
這次新增的 focused tests:
21 passed
最後完整 regression:
耗時:
212.103 秒
而且按照這次的規則,完整 regression 只跑了一次。
沒有因為修一個 CSS 或一顆 draggable point,就一直重跑四百多個 tests。
除此之外還做了真正的 Browser interaction 驗證:
都成功。
最後我自己在瀏覽器重新玩了一次三個案例。
其實最明顯的感覺不是:
圖變漂亮了。
而是:
操作方式開始比較符合「我要理解什麼」。
我要理解 Phase:
我直接轉它。
我要理解 Velocity:
我直接拉它。
我要理解一條數學關係:
我直接改圖上的結構。
這件事情比多一張圖、多一個 Button,對整個 Visual Learning Lab 的產品方向更重要。
現在整條架構開始變成:
Material
↓
Semantic Model
↓
Representation Planner
↓
Validated Learning World
↓
Canonical State
↕
Direct Manipulation
↕
Visual Representation
以前的互動比較像:
使用者操作 UI,UI 再改知識。
Day 24 之後開始變成:
使用者直接操作知識的視覺化身。
我覺得這也是 Visual Learning Lab 到目前為止第一次真的開始靠近我一開始想做的東西:
Turn complex ideas into something you can actually see.
現在可能還要再加一句:
And something you can actually touch.


 iThome鐵人賽
 看影片追技術