
上一篇比較了部署策略,也提到新版本是否可以繼續接收流量,需要靠成功率、錯誤率與回應時間判斷。
但如果 CPU 只有 30%、容器也都正常執行,使用者卻反映「訂單送出後要等很久」,接下來該看哪裡?
程式等待資料庫連線、外部 API 或鎖定釋放時,不一定會消耗大量 CPU,若只看資源使用率,就有可能會漏掉這些問題。
這篇會從 Metrics(指標)、Logs(日誌)與 Traces(追蹤) 出發,看看如何選擇監控能力,並從使用者的症狀找到需要處理的原因。
以下是一個假設案例。
訂單 API 執行在 ECS,透過 ALB 接收請求,建立訂單時會存取資料庫與庫存服務,平常回應時間的 P95 約為 300 毫秒,某次部署後升到 2 秒,但 CPU 仍維持在 30% 左右。
補充:P95 是什麼?
P95 是第 95 百分位數,把一段時間內所有請求的回應時間,從快到慢排列,P95 就是約 95% 的請求不會超過的時間。例如 P95 為 2 秒,代表約 95% 的請求在 2 秒內完成,只有少數請求需要更長時間。
P95 不是平均回應時間,觀察 P95 可以避免平均值掩蓋部分使用者等待較久的情況。
這時直接增加 ECS Task,未必能改善問題,如果瓶頸在資料庫連線,增加 Task 還可能讓資料庫承受更多連線。
因此先確認是哪項操作變慢、是否伴隨錯誤,再檢查相關資源與相依服務,會比直接擴充容量更有依據。
接下來可以從三種監控資料觀察同一個問題:Metrics(指標) 用來發現整體異常,Logs(日誌) 協助查看個別操作的紀錄,Traces(追蹤) 則能找出請求的處理路徑與耗時。
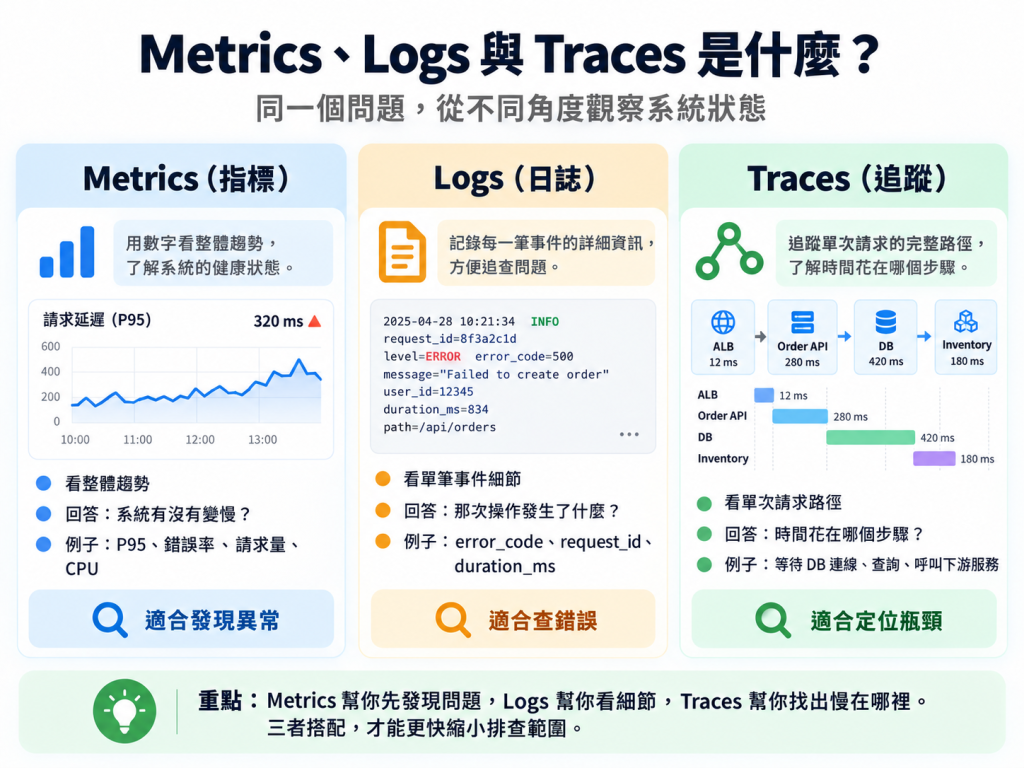
圖:Metrics、Logs 與 Traces 的用途比較,圖中數據為示意,實際可取得的資訊取決於監控設定。
Metrics 是一段時間內的數值,適合觀察趨勢、比較版本與觸發告警。
訂單 API 可以先看四件事:
在 AWS 上,可以透過 Amazon CloudWatch 查看服務內建指標,並收集應用程式自訂指標。
例如 ALB 的 TargetResponseTime,就是衡量請求送到後端後,到後端開始回傳回應標頭所花的時間。
另外 HTTP 成功也不一定代表業務成功,如果 API 回傳 200,內容卻是「訂單建立失敗」,只看 HTTP 5xx 就會漏掉問題,因此重要操作還需要記錄業務結果,並建立訂單成功率等業務指標。
藍綠部署若使用不同的 Target Group(目標群組),可以分別觀察兩組延遲。
但在滾動部署期間,新舊版本的 ECS Task 可能同時接收請求,如果共用同一個 Target Group,ALB 的監控指標就會把兩個版本的結果一起統計,無法直接判斷是哪個版本變慢。
因此,需要在應用程式的監控資料中加入版本資訊(例如 v1、v2),並收集各版本的請求回應時間,才能分別計算 P95。
如果發現只有新版的 P95 明顯上升,而舊版正常、請求量也沒有明顯增加,就可以優先檢查新版程式及其相依服務。
Metrics 能看出「訂單 API 變慢」,Logs 則保留個別操作的結果與錯誤內容。
如果日誌只有 Request failed,排查時幫助有限,採用 Structured Logging(結構化日誌),可以把查詢需要的資訊分成欄位:
{
  "level": "ERROR",
  "service": "order-api",
  "version": "v2",
  "operation": "CreateOrder",
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "duration_ms": 2100,
  "error_code": "DB_CONNECTION_TIMEOUT"
}
把日誌送到 CloudWatch Logs 後,可以使用 CloudWatch Logs Insights 找出超過一秒的訂單請求:
fields @timestamp, version, duration_ms, error_code, trace_id
| filter service = "order-api"
    and version = "v2"
    and operation = "CreateOrder"
    and duration_ms > 1000
| sort duration_ms desc
| limit 20
這個查詢沒有只篩選 ERROR,因為慢請求也可能最後成功,前提是應用程式有記錄成功與失敗請求的耗時,而且 duration_ms 使用數值格式。
在本文案例中,若部分慢請求同時出現 DB_CONNECTION_TIMEOUT,就能進一步檢查資料庫連線取得過程。
這些業務欄位需要由應用程式輸出,日誌也應避免包含密碼、存取權杖與完整付款資料,而 Trace ID 適合用來關聯請求,不適合當成每次都不同的自訂指標維度。
當請求包含多個處理步驟,只看各自的日誌,很難還原完整的等待過程。
Distributed Tracing(分散式追蹤) 可以串起同一次請求的處理路徑,一次 Trace 包含多個 Span(追蹤區段),分別記錄操作的時間與狀態。
以下假設應用程式已為連線取得、資料庫查詢與下游呼叫建立對應的 Span,而且這些步驟依序執行:
| 步驟 | 耗時 |
|---|---|
| 驗證請求 | 20 毫秒 |
| 等待資料庫連線 | 1,700 毫秒 |
| 執行資料庫查詢 | 80 毫秒 |
| 呼叫庫存服務 | 150 毫秒 |
從這筆 Trace 可以看出,請求雖然成功取得資料庫連線,但光是等待連線就花了 1,700 毫秒,如果其他請求等待更久,超過連線池設定的等待時間,就可能發生前面日誌中的 DB_CONNECTION_TIMEOUT。
因此接下來應檢查連線池等待數、使用中的連線,以及新版程式是否正確釋放連線。
實際 Trace 可能包含多個互相重疊的 Span,因此不能直接把所有 Span 的耗時加總,當成整體請求時間。
在 AWS 上,可以使用 OpenTelemetry 產生與收集追蹤資料,再搭配 CloudWatch Application Signals 等工具查看服務效能與相依關係,不過應用程式需要先設定追蹤功能,如果想觀察「等待資料庫連線」等特定步驟,而自動追蹤沒有涵蓋,就需要額外加入自訂 Span。
當請求經過多個服務時,也需要傳遞 Trace ID 等追蹤資訊,並在日誌中記錄相同的 Trace ID,才能把不同服務的執行過程與錯誤紀錄關聯起來。
可以依照想回答的問題,選擇需要啟用與維護的能力:
| 監控需求 | AWS 能力 | 額外設定與責任 |
|---|---|---|
| 查看 ALB 請求量、延遲與 HTTP 錯誤 | CloudWatch 內建指標 | 建立面板、告警與適當門檻 |
| 查看 ECS 資源使用狀況 | ECS 內建指標,需要更細資訊時評估 Container Insights | 依需求啟用 Task/Container 層級監控,並管理額外費用 |
| 查詢應用程式的錯誤與慢請求 | CloudWatch Logs/Logs Insights | 設定日誌傳送、結構化欄位與保留時間 |
| 分析請求內部與跨服務的等待 | Application Signals 搭配 OpenTelemetry | 監測植入、資料傳送、上下文傳遞與取樣 |
對單一、處理流程簡單的服務,可以先建立服務指標、應用程式日誌與告警,當日誌已難以還原單次請求的等待位置,再加入追蹤。
不過是否需要 Traces 不能只看服務數量,一支重要的訂單 API,即使沒有拆成微服務,也可能依賴資料庫與第三方付款 API,仍值得追蹤關鍵步驟。
本文選擇服務指標、結構化日誌,再加上訂單路徑的追蹤 ,原因是需要比較部署版本,也需要區分資料庫連線等待與下游呼叫的耗時;相對地,團隊要承擔監測植入與資料收集的維護工作。
收集範圍也需要控制,日誌應設定保留時間,Trace 可以透過 Sampling(取樣) 減少資料量與成本。
取樣是指只保留部分請求的追蹤紀錄,例如設定 10% 的取樣率,代表每 100 筆請求大約只會保留 10 筆 Trace。
CPU 短暫升高、服務仍正常,和訂單持續失敗,最好不要使用相同的通知等級。
已影響使用者的失敗率、逾時與延遲,需要及時處理;容量逐漸不足但服務仍正常,則可以安排檢查與調整。
例如本文假設團隊要求訂單 API 的每分鐘 P95 不超過 1 秒,可以把「最近 5 個一分鐘區間中,有 3 個超過門檻」作為初始告警條件。
CloudWatch Alarm 支援這類 M out of N(N 個資料點中有 M 個違反門檻) 的判斷方式,可以避免服務偶爾變慢就立即發出告警。實際門檻仍需要依照服務能容忍的延遲與偵測時間調整。
另外,P95 也需要搭配請求量觀察,如果某分鐘只有幾筆請求,少數的慢請求就可能讓 P95 明顯波動,CloudWatch 因此提供低樣本處理設定,讓使用者決定樣本不足時是否繼續評估百分位數告警。
每個需要通知人員的告警,至少要交代環境、受影響的操作,以及對應的監控面板或排查文件,讓接手的人知道下一步要做什麼。
回到本文的假設案例,排查可以依序進行:
這裡不能只憑 Trace 的等待時間就判定連線洩漏,也不能在退版完成後立即宣布問題解決,處理結果仍要回到使用者操作與相關指標驗證。
監控能協助發現服務異常,但應用程式使用的資料庫密碼、API 金鑰,以及可疑的 AWS 操作,也需要另外管理。
下一篇會接著討論機密管理與操作稽核,看看權限設定完成後,還有哪些安全與事件處理責任需要安排。



 iThome鐵人賽
 看影片追技術