
Day 25 那次 50 封信的執行,代理層記下了每一次模型呼叫。今天先把帳算清楚,再試三個省錢的手段。
結論先講:我原本以為最貴的是主管,實際上最貴的是查單專員。而我試的三個省錢手段,兩個讓總成本變高,一個在某一題上燒掉比它省下的多六倍。
50 封信的 token 花在哪,整理成下圖。
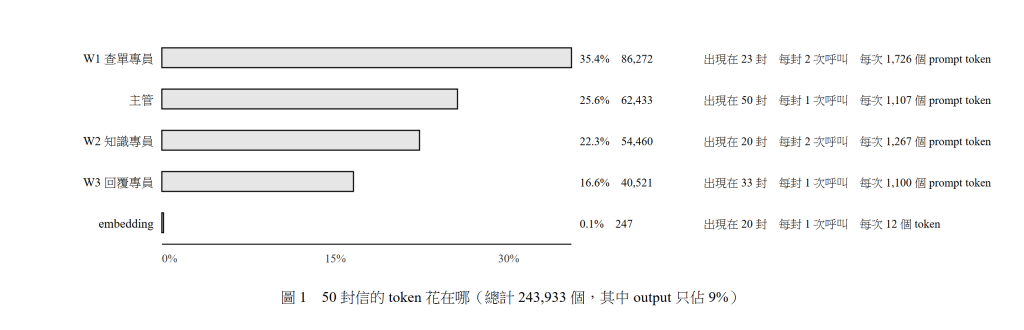
總共 243,933 個 token,每封信平均 4,879 個。
| token | 佔比 | |
|---|---|---|
| W1 查單專員 | 86,272 | 35.4% |
| 主管 | 62,433 | 25.6% |
| W2 知識專員 | 54,460 | 22.3% |
| W3 回覆專員 | 40,521 | 16.6% |
| embedding | 247 | 0.1% |
兩件我沒料到的事。
第一,主管不是最貴的。 主管的 system prompt 有 2,236 個位元組,看起來很長,但它單次呼叫的 prompt 中位數只有 1,103 個 token,而且每封信只呼叫一次——Day 18 選的 Switch 寫死路由版本,主管只做分類,派給誰是程式決定的。
W1 單次呼叫的 prompt 是 1,726 個 token,比主管多 56%,而且每封信要呼叫兩次(一次決定呼叫哪個工具,一次把工具回傳的資料整理成 WorkerResult)。它只出現在 23 封信裡,卻吃掉三分之一的帳單。
為什麼 W1 的 prompt 這麼大?它掛了三個 Data table 工具,每個工具的名稱、參數結構和說明都會進到每一次呼叫的 context 裡。加上 Day 14 那份有 12 個欄位的 WorkerResult schema。工具和契約都不是免費的,它們是每次呼叫都要付的固定成本。
第二,output 只佔 9%。 很多人的第一個念頭是「叫模型講短一點」,但那只能動到這 9%。要省錢得動 input。
還有一個數字值得記下來:自動回覆的信每封 6,743 個 token,轉人工的信每封只要 1,261 個。因為轉人工在主管那一步就結束了,不派工也不寫草稿。這個數字等一下很關鍵。
Day 10 寫過「做判斷的用大的,做轉換的用小的」。本機有一個 qwen3.5:0.8b,把三位專員的 Chat Model 換過去,跑各自的 20 題考卷。
結果不是「分數掉幾分」:
| 考卷 | HTTP 200 | |
|---|---|---|
| W1 查單(跑 5 題) | — | 0/5 |
| W2 知識 | — | 0/20 |
| W3 回覆 | — | 0/20 |
一題都沒跑完。 n8n 的日誌寫著:
Model output doesn't fit required format
The AI model returned an empty response to the Structured Output Parser
從代理層看得到小模型實際吐了什麼。它不是亂寫,內容其實蠻像樣的:
format_final_json_response({"reason":"客人詢問訂單到貨時間","needs_human":"false"})
但有兩個問題。第一,大模型會把結果包進 output 欄位——format_final_json_response({"output":{...}})——小模型把欄位直接攤在最外層。第二,布林值它吐成字串 "false"。
所以小模型的問題不是判斷力,是守不住契約。 而 Day 14 建立的整套東西,正是建立在「每個專員都吐出同一份格式」這個前提上。一個會把 facts 陣列寫成字串的專員,後面的守門員、合併、驗收全部會垮。
我在下一個實驗裡需要一個很小的判斷,順便驗證了這件事。契約只有兩個欄位:
{ "needs_human": true, "reason": "客人要求賠償並提到申訴" }
第一次還是失敗——同樣是沒包 output、布林吐成字串。於是我把 Structured Output Parser 整個拿掉,讓它寫純文字,自己在 Code 節點解析:
const raw = String($input.first().json.output ?? '');
const m = raw.match(/\{[\s\S]*\}/);
let t = {};
try { t = JSON.parse(m ? m[0] : raw); } catch { t = {}; }

return [{
  json: {
    needs_human: String(t.needs_human).toLowerCase() === 'true',
    reason: String(t.reason ?? '').slice(0, 60),
    parse_ok: Object.keys(t).length > 0,
  },
}];
50 次呼叫全部解析成功。
所以大小模型分級不是「換個模型就好」,是「把契約縮到它守得住的程度」。 兩個欄位加一段自己寫的容錯解析,它做得到;十二個欄位、含陣列和列舉的 WorkerResult,它做不到。
既然小模型能做小判斷,那在主管前面加一個分流員:先判斷這封信要不要直接給人處理,是的話就不叫主管、不派工、不寫草稿。
分流員的 prompt 只有十行,模型用 qwen3.5:0.8b。50 封信重跑一次:
| 原本 | 加分流員 | |
|---|---|---|
| 完全通過 | 42/50 | 40/50 |
| 總 token | 243,933 | 255,278 |
| 延遲 p50 | 3,778ms | 5,863ms |
總成本變高了 4.6%。 拆開來看:
而且它抓得不準。17 封標準答案是轉人工的信,分流員只攔到 5 封;另外它把 EV28 誤判了——那是一封正常的退貨詢問,它讀成「要求賠償、提到申訴」。那封信本來會得到正確的回覆,現在被擋下來轉人工。
最諷刺的是延遲變差。 那 6 封走捷徑的信,延遲中位數從 1,148ms 變成 1,965ms。分流員自己跑一次就要 1,634ms——本機的小模型比雲端的大模型還慢。
回頭看就很清楚:它想省的那條路本來就很便宜。
Day 18 選的 Switch 架構裡,客訴、優惠、其他這三類在主管分類完就直接結束,每封只花 1,261 個 token。分流員想省的就是這 1,261,而它自己要花 263。扣掉誤判的代價,等於沒省。
早期退出要划算,前提是被退出的那條路原本很貴。 如果我的轉人工也要走完派工、查詢、寫草稿再丟掉,那這招會很有效。但 Day 18 已經把那條路切短了,所以沒有東西可以省。
(補充一個測量上的細節:加了分流員之後 intent 正確率從 92% 掉到 80%,這不是分類變差,是走捷徑的那 6 封根本不產生 intent,評分器把它算成錯。真正的品質變化是 42/50 → 40/50,其中兩封是重跑的抖動。)
W1 最貴,而它的 prompt 裡有三個工具的定義。第三個 get_customer 查會員等級,Day 11 給它的說明寫了「不要為了多知道一點而呼叫此工具」——聽起來很少用。砍掉試試。
| 三個工具 | 兩個工具 | |
|---|---|---|
| 考卷 | 20/20 | 19/20 |
| prompt 中位數 | 3,408 | 3,210 |
| 耗時中位數 | 1,776ms | 1,427ms |
prompt 少了 5.8%,速度快了 20%。看起來划算——直到看那掉的一分。
W1-20 這題問「查出這位客戶的會員等級」。沒有 get_customer,它應該要回報「我沒有這個能力」。它沒有:
get_customer({"email":"wang@example.com"})
get_customer({"email":"wang@example.com"})
get_customer({"email":"wang@example.com"})
... 連續 18 次
模型不會說「我沒有這個工具」,它會一直呼叫一個不存在的工具,直到 maxIterations 用完,整個 workflow 以錯誤收場。
這一題燒掉 26,676 個 token(包含測試腳本的三次重打)。而砍掉工具在另外 19 題一共省下大約 3,800 個。一題的代價是全部省下的七倍。
所以工具描述的長度不該跟「它佔幾個 token」比,要跟「少了這個能力會發生什麼事」比。答案是:會發生最壞的那種失敗——不報錯、不降級、只是重複嘗試直到逾時。
三個手段試完,兩個讓總成本變高,一個在邊界情況上賠更多。我從這裡歸納出三件事。
第一,先量再動手。 我原本準備要縮短主管的 prompt,因為我以為它最貴。量完才知道它只佔 25.6%,而且每封信只呼叫一次。如果我照直覺動手,會花一整天優化一個沒什麼用的地方。
第二,成本是「每次呼叫的固定成本 × 呼叫次數」。 W1 貴不是因為它笨,是因為 1,726 × 2 × 23。要壓它,動哪一項都比改 prompt 有效:
第三,架構層的節省已經先發生了。 今天沒有一個手段有效,很大一部分原因是前面幾天已經把能省的省掉了:Day 18 的 Switch 讓主管只呼叫一次、讓轉人工的信早早結束;Day 12 證明 20 條 FAQ 不需要檢索(整份塞進 prompt 反而快一倍、省四分之一 token);Day 23 證明專員不該掛記憶(視窗填滿後要多付 49%)。
那些才是真正的成本決定。等到架構定了再來省 token,能動的空間就很小了。
Prompt caching 我沒有辦法測。我用的是 Ollama Cloud 的 gemma4:cloud,代理層看得到 token 數,但看不到計價,而快取影響的是價格不是 token 數。
能確定的只有一件事:要讓快取生效,system prompt 必須完全靜態。 我的主管 prompt 裡沒有任何變動內容(日期、客人名字都在 user message 裡),這是 Day 09 就定下的結構,剛好符合快取的要求。如果你把 {{ $now }} 寫進 system prompt,每次的前綴都不一樣,快取就完全失效。
output、布林值吐成字串。明天開始最後一週,先回頭修評估集:50 封信裡只有一封是髒的、同信箱多筆訂單只有三封、EV11 的標準答案從 Day 17 吵到現在還沒解決。


 iThome鐵人賽
 看影片追技術