
明天要做單兵 Agent 和 Supervisor 架構的正面對決。在那之前得先處理一件事:兩個分數差多少,才算真的有差?
這個問題我前面幾天一直在用直覺回答。Day 22 說「一題的差距落在雜訊範圍內」,Day 25 說「那是 W3 的抖動」——都沒有量過。今天把它量出來,順便還前面欠的三筆評估集的債。
完全相同的流程、完全相同的 50 封信,連續跑四次。
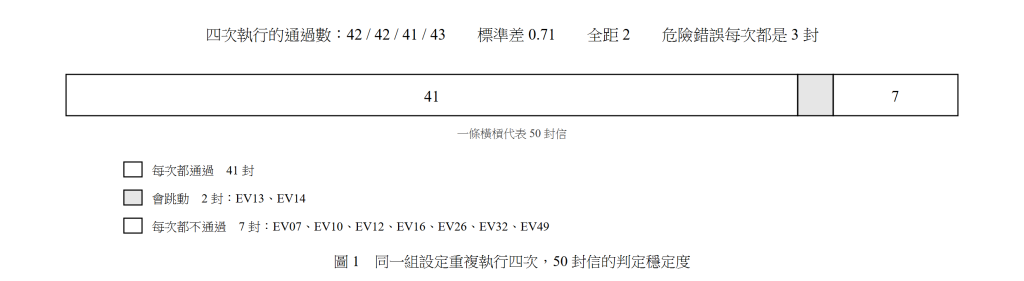
同一組設定重複執行四次,50 封信的判定穩定度如下圖。
| 第 1 次 | 第 2 次 | 第 3 次 | 第 4 次 | |
|---|---|---|---|---|
| 完全通過 | 42 | 42 | 41 | 43 |
| 危險錯誤 | 3 | 3 | 3 | 3 |
標準差 0.71,全距 2。總 token 在乾淨的三次之間的標準差是 0.7%。
比分數更有用的是逐案的穩定度:
所以「雜訊」不是均勻地散在 50 封信上,它集中在兩封。 其他 48 封要嘛穩定地對,要嘛穩定地錯。
這個結果比我預期的乾淨。溫度設 0.2、prompt 固定、資料固定,LLM 其實相當確定;不確定的是那些本來就在邊界上的案件。EV13 是一信兩問(訂單狀態+沖煮方式),W3 有時候把兩個都寫進去、有時候只寫一個。EV14 是那封轉寄的髒信,主管有時候判成 order_status、有時候判成 complaint。
明天的判讀規則:差 1 到 2 封落在雜訊範圍,不宣稱誰贏;要差 3 封以上我才會說有差別。危險錯誤的數字四次都一樣,所以那個指標上差 1 封就有意義。
還有一件事值得記:那 7 封每次都錯的,才是真正的待辦清單。 跑一次看到 8 封錯,你不知道哪些是運氣;跑四次之後,名單就確定了。
接著盤點這 50 封信本身。我把它量了一遍,結果不太好看。
| 50 封裡 | |
|---|---|
| 信件字數中位數 | 28 字 |
| 超過 150 字的 | 1 封(EV14,393 字) |
| 有轉寄區塊、引用、簽名檔的 | 1 封(EV14) |
Day 22 做「W3 該拿摘要還是原信」的實驗時就卡在這裡:要測「摘要會不會漏東西」,得用摘要和原文差很多的信,而 50 封裡只有一封符合。當時我說 Day 27 會補,現在補。
資料表裡有 4 位客人各有兩筆訂單。評估集裡有 12 封信來自這些客人,但其中 7 封自己寫了訂單編號——那就不需要分辨了。真正考驗「要判斷是哪一筆」的只有 5 封,其中 3 封是查單類。
Day 25 的 EV12(「我的濾杯什麼時候寄?」)就是這類,而且它是那次唯一一個八條分流規則都沒攔到的危險錯誤。Day 25 結尾我說「50 封裡只有 3 封同信箱多筆,不夠驗證」,所以沒動手改。
ask_info 只有一封標準答案的 action 分佈是:回覆 32 封、轉人工 17 封、索取資訊 1 封。
「資料不足、要先問客人」是 Day 09 就定義的三個結局之一,但它幾乎沒有被測到。
針對三個洞各補一批,一共 12 封,編號 EV51 到 EV62。
五封髒信:轉寄的出貨通知加行銷區塊、公司簽名檔加免責聲明、兩層引用的回信、手機簽名檔、沒有標點而且訂單編號寫成小寫的信。
其中 EV52 是最長的一封,416 字,真正的問題夾在中間:
你好

我是上禮拜買巴西豆的那位,東西還沒到不過沒關係我不急,我想先問一個別的問題。

我家裡沒有冷藏的空間,平常都放在廚房的櫃子裡,但最近天氣很熱,我有點擔心
豆子會壞掉。想問一下你們建議怎麼保存比較好?另外我看網路上有人說要放冷凍,
這樣對嗎?

謝謝

--
曾國華 Kuo-Hua Tseng
專案經理|某某科技股份有限公司
電話:02-1234-5678 分機 321
地址:台北市信義區某某路 200 號 15 樓

本郵件及其附件可能包含機密或特權資訊,僅供指定收件人使用。若您非指定收件人,
請立即通知寄件人並刪除本郵件,不得複製或轉發。本公司不對本郵件內容之完整性
或正確性負法律責任。
它的 must_not_mention 寫了「機密」「特權資訊」「法律責任」「分機 321」——簽名檔的內容不應該出現在回信裡。
四封同信箱多筆:「那個淺焙的豆子到了嗎?」「我八月買的那筆收到了嗎?」「那支日曬的寄了嗎?」「我有兩筆訂單,麻煩兩筆都幫我看一下」。分別要靠品項、下單日期、處理法、以及「兩筆都要」來判斷。
三封該索取資訊:寄件信箱不在訂單表裡、只說「我想退貨」沒說哪一筆、只說「收到的東西有問題」沒說哪裡有問題。
補完之後評估集變成 62 封:
| 原本 50 封 | 現在 62 封 | |
|---|---|---|
| 有雜訊的信 | 1 | 5 |
| 索取資訊 | 1 | 4 |
| 困難(H) | 15 | 21 |
主線流程跑這 12 封:8 封完全通過、2 封部分通過、2 封錯得有風險。
結果跟我預期的相反。
五封髒信裡,四封完全通過。
a10313):正確查到並回報已送達。Day 22 擔心的「摘要會漏掉原信裡的東西」沒有發生。主管把一封 416 字的信壓成一句 clean_question,壓得很準。
唯一失敗的髒信是 EV51,而它失敗的方式我沒想到。
信是這樣的:客人收到「A10310 已送達」的通知,回信說——
這個我收到了沒問題,但我另外買的濾杯到現在都還沒看到,是不是漏掉了?

---------- 轉寄的郵件 ----------
您的訂單 A10310 已於 2026/09/05 送達,物流:黑貓宅急便,貨號 8891234850。
...
系統回的是:
關於您的訂單 A10310,目前狀態為已送達 (delivered),由黑貓宅急便配送,
物流單號為 8891234850。
它回答了客人明說「這個我收到了」的那一筆。
Day 09 給主管寫的規則是「訂單編號必須真的出現在信裡」——這是為了防止模型編造編號。A10310 確實出現在信裡,所以守門員放行了。問題是它出現在轉寄的那一段,不是客人這次在問的事。
這是一個新的失敗模式:雜訊不只是「多餘的字」,它會提供一個看起來完全合法的錯誤參數。 防編造的規則擋不住這個,因為它不是編的。
四封裡失敗兩封,而且兩封都是危險錯誤。
EV56「那個淺焙的豆子到了嗎?」(王小明有 A10293 淺焙已出貨、A10296 磨豆機待付款):
關於您的訂單,我這邊查到兩筆紀錄:
訂單 A10293:已出貨,由黑貓宅急便配送(單號 8891234567),預計 2026-09-15 送達。
訂單 A10296:待付款。

請您確認詢問的是哪一筆訂單。
EV59「那支日曬的寄了嗎?」(陳大文有 A10295 哥倫比亞已送達、A10307 古吉日曬已出貨):
我為您查詢到兩筆訂單,請確認您詢問的是哪一筆:
訂單 A10295:已送達 (delivered)
訂單 A10307:已出貨 (shipped)
兩封的答案其實都在手上了。 「淺焙」對得到耶加雪菲,「日曬」對得到古吉。系統還是把兩筆都列出來,請客人自己選。
這跟 Day 25 的 EV12、Day 23 的 C3-R2 是同一個行為。加上今天這兩封,「同信箱多筆、要靠線索判斷是哪一筆」的案例現在有四封,系統答對一封——EV57「我八月買的那筆收到了嗎」它正確只回報了八月那筆。
四分之一。而這類案件在 50 封的舊評估集裡只有一封,所以前面二十幾天我一直以為這是個別案例。補題的價值就在這裡:它把一個偶發的失敗變成一個可以量的失敗率。
三封裡,EV61(「我想退貨」)和 EV62(「收到的東西有問題」)都正確地請客人補資訊,過了。
EV60 失敗。寄件人的信箱根本不在訂單表裡,W1 查不到任何東西,系統回的是:
關於您的訂單出貨進度,我這邊幫您確認後,最晚 24 小時內回覆您。
它沒有請客人提供訂單編號,而是承諾自己去查——可是它查不到,因為資料裡就是沒有。final_action 是 reply 不是 ask_info。
追下去是 Day 20 寫的合併邏輯:W1 回報 not_found 時,unresolved 寫「查無符合的訂單」,但 ask_info 只有在 W1 回報 insufficient_info 時才會打開。「查無資料」和「資訊不足」在程式裡是兩件事,但對客人來說結果一樣——都需要他補一個訂單編號。
這封信至少有被分流規則攔下來要人審(review_required = true),所以不會錯誤地寄出去。但它暴露了一條設計縫隙,我記在待辦裡。
Day 17 留下一個沒解決的問題。EV11 是「訂單 A10299 怎麼變成取消了?我沒有取消啊」,而資料表裡 A10299 的狀態就是 cancelled,沒有取消原因。
當時 v2 版的主管把它轉人工,標準答案寫的是自動回覆,我沒有改標準答案,就那樣擱著。
今天四次重跑,這一題四次都通過,回信是:
關於您的訂單 A10299,目前狀態為已取消。

關於該訂單在您未主動取消的情況下為何變更狀態,我這邊幫您確認後,
最晚 24 小時內回覆您。
所以我維持原本的標準答案,理由是:「資料裡沒有原因」不是「要轉人工」的理由,而是「不可以編原因」的理由。 能誠實說出「狀態是已取消,原因我幫您確認」就已經是正確的回覆——它沒有讓客人白等,也沒有編出「逾期未付款自動取消」這種話。
標準答案的 must_not_mention 寫著「您自行取消」「逾期未付款」「自動取消」,這一欄才是這題真正在測的東西。Day 26 加分流員那次重跑,這題就踩中了「您自行取消」。負面的標準答案比正面的更會抓人。
兩件要講清楚。
第一,這份評估集是被我的 prompt 看過的。 前面 26 天我反覆用它調 prompt、改規則、修守門員。它的分數一定偏高。datasets/holdout12.json 裡有 12 封我沒有用來調過任何東西的信,明天的對決會一併跑,分數應該會比 62 封那組低——如果不低,那才要擔心評估集是不是太簡單。
第二,我沒有做 LLM 當評審。 現在的評分全部是程式:關鍵字比對、禁用詞、狀態列舉、路由比對。它的缺點很明顯——Day 22 那一分就是因為摘要版寫「已到貨 22 天」而判準要「超過」,意思一樣但字面沒中。
我考慮過加一個 LLM 評審來判斷語意,但沒有做,理由是前面已經有兩次教訓:Day 21 加 LLM 驗收讓分數變差,唯一一次退件是誤判;而且評分器自己的 bug 我到今天抓到七個,每一個都是程式規則寫錯——如果評分再多一層模型的主觀判斷,我連「這個數字可不可信」都說不清楚。
評分器寧可笨一點但可重複。 不可重複的評分,拿來比較兩個系統是沒有意義的。
ask_info 只有 1 封。ask_info 那條路幾乎打不開:「查無資料」和「資訊不足」在程式裡分成兩件事,但客人看到的結果一樣。明天把單兵 Agent 和 Supervisor 架構放在同一組信上跑,包含對 Supervisor 不利的數字。


 iThome鐵人賽
 看影片追技術